Zanim ChatGPT, Perplexity albo Google zacytuje Twoją stronę, ich bot musi ją pobrać, a to często się nie udaje bez wiedzy właściciela.
Każda firma AI ma kilka botów: jeden zbiera treści do treningu, drugi buduje indeks wyszukiwarki, trzeci pobiera stronę, gdy użytkownik o nią prosi, i każdy blokuje się osobno. Plik robots.txt to tylko deklaracja: w naszym pomiarze 100 największych polskich domen 7 odrzuca na serwerze boty, które robots.txt wpuszcza. Boty AI nie wykonują JavaScriptu, a plik llms.txt nie pomaga w wyszukiwarkach.
W tym rozdziale sprawdzisz to wszystko na swojej stronie w 30 minut, z oceną dowodu przy każdej lekcji.
Zanim AI zacytuje Twoją stronę, jej bot musi ją pobrać. robots.txt to tylko deklaracja: o dostępie decyduje też serwer i CDN, boty AI nie wykonują JavaScriptu, a llms.txt nie pomaga w wyszukiwarkach.
- potwierdzoneco najmniej dwa niezależne pomiary zgodne co do kierunku
- pojedynczy pomiarjeden pomiar z jawną metodą: kierunek wiarygodny, liczba niepewna
- spornepomiary są sprzeczne albo spór o interpretację nie jest rozstrzygnięty
- mechanizmopis działania z dokumentacji platformy, patentu lub dokumentu sądowego
- praktykaobserwacja z pracy albo rekomendacja bez pomiaru
- obaloneliczba bez pokrycia w źródłach, zbita pomiarem albo wycofana przez autora
Ocena dotyczy tezy, nie źródła: dokumentacja Google opisuje mechanizm, ale nie mierzy jego efektu.
Boty AI: GPTBot, OAI-SearchBot, ChatGPT-User i reszta
Każda duża firma AI wysyła do sieci kilka botów o różnych zadaniach. Jeden zbiera treści do trenowania modeli, drugi buduje indeks, z którego korzysta wyszukiwarka w czacie, a trzeci pobiera stronę w chwili, gdy użytkownik o nią poprosi. Blokada jednego nie blokuje pozostałych, dlatego zanim cokolwiek zmienisz w robots.txt, musisz wiedzieć, z którym z nich masz do czynienia.
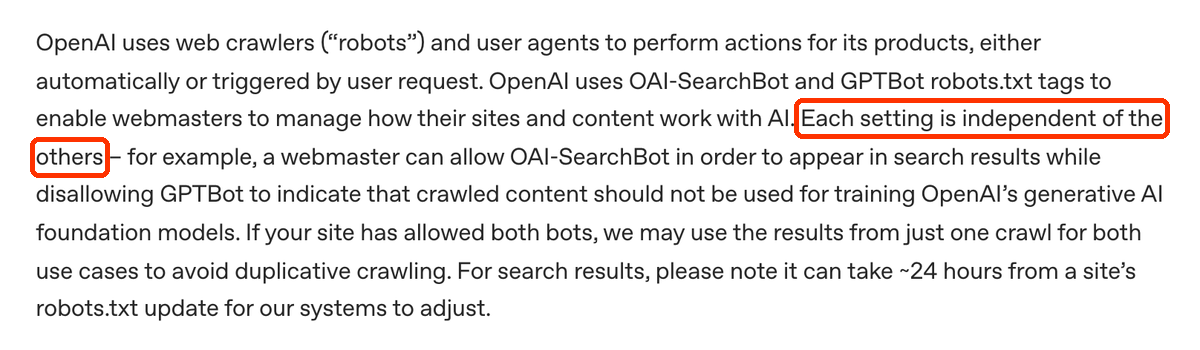
Najlepiej widać to u OpenAI, które opisuje trzy boty i wprost zaznacza, że każde ustawienie działa niezależnie. Możesz wpuścić bota wyszukiwarki ChatGPT, żeby pojawiać się w odpowiedziach, i jednocześnie zablokować bota treningowego:
Ten sam podział, z innymi nazwami, mają pozostali dostawcy. Poniżej boty, które warto znać, pogrupowane według zadania. Ostatnia kolumna mówi, czy bot respektuje robots.txt, bo przy botach „na żądanie” odpowiedź nie zawsze brzmi „tak”.
| Firma | Trening modeli | Wyszukiwarka AI | Pobranie na prośbę użytkownika | robots.txt |
|---|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User | tak; przy ChatGPT-User „może nie obowiązywać” |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User | tak, wszystkie trzy |
| Perplexity | — (nie trenuje modeli bazowych na crawlu) | PerplexityBot | Perplexity-User | tak; Perplexity-User „zwykle ignoruje” |
| Google-Extended (token, nie osobny bot) | Googlebot (wyniki, AI Overviews, Tryb AI) | — | tak | |
| Common Crawl | CCBot (publiczny korpus, z którego trenuje wiele modeli) | — | — | tak |
Z tabeli wynikają trzy rzeczy, które najczęściej są mylone.
GPTBot to nie jest „bot ChatGPT”
GPTBot zbiera treści do trenowania przyszłych modeli. Za to, czy Twoja strona pojawi się w odpowiedziach wyszukiwarki ChatGPT, odpowiada OAI-SearchBot. OpenAI pisze, że strony, które go zablokują, nie będą pokazywane w odpowiedziach ChatGPT search, choć mogą zostać jako zwykłe linki nawigacyjne. Kto blokuje GPTBota w przekonaniu, że „wyłącza ChatGPT”, w praktyce wyłącza tylko trening. Kto blokuje wszystko, co ma w nazwie „GPT” albo „OAI”, znika też z wyszukiwarki.
Google-Extended nie pojawi się w logach
Google-Extended to token, którego używasz tylko w robots.txt. Nie jest osobnym botem i nie zobaczysz go w logach serwera, bo strony pobiera zwykły Googlebot, a token mówi jedynie, do czego Google może te treści użyć poza wyszukiwarką. Ma to znaczenie przy decyzji o blokowaniu, do której wracamy w lekcji o blokowaniu botów.
Boty „na żądanie” działają jak przeglądarka
ChatGPT-User, Claude-User i Perplexity-User wchodzą na stronę, gdy użytkownik wkleja link albo prosi o sprawdzenie konkretnego adresu. Dostawcy traktują je jak przedłużenie przeglądarki człowieka, dlatego OpenAI i Perplexity nie gwarantują, że zastosują się do robots.txt. Jeśli chcesz zamknąć przed nimi treść, robots.txt nie wystarczy i potrzebna jest blokada na serwerze. Definicje poszczególnych botów znajdziesz w słowniku, a to, co model robi z pobraną treścią dalej, opisuje rozdział jak działają wyszukiwarki AI.
Otwórz twojadomena.pl/robots.txt i wypisz każdą linię User-agent:, która dotyczy botów AI. Przy każdej zanotuj z tabeli powyżej, czy to bot treningowy, wyszukujący czy „na żądanie”. Jeśli żadnego nie ma, wszystkie boty AI mają u Ciebie zgodę, bo brak reguły oznacza dostęp.
robots.txt dla botów AI: jak zablokować GPTBota i wpuścić OAI-SearchBota
Jeśli chcesz być widoczny w wyszukiwarce ChatGPT, ale nie oddawać treści do trenowania modeli, zablokuj GPTBota i zostaw OAI-SearchBota. Tak robi 17 z 23 dużych polskich serwisów, które w naszym pomiarze blokują GPTBota. U OpenAI zmiana zaczyna działać po około 24 godzinach. Botów „na żądanie” robots.txt w pełni nie zatrzyma.
robots.txt działa prosto: bot szuka grupy ze swoją nazwą w linii User-agent i stosuje jej reguły. Jeśli takiej grupy nie ma, bierze reguły dla gwiazdki *, a jeśli i tych nie ma, ma pełny dostęp. Podstawy składni opisuje hasło robots.txt w słowniku i rozdział techniczne SEO. Tu skupiamy się na trzech ustawieniach, między którymi wybiera każda firma.
Trzy gotowe konfiguracje
A. Widoczny wszędzie. Nic nie dopisujesz. Brak reguły dla bota AI oznacza zgodę, więc wszystkie boty, treningowe i wyszukujące, mogą pobierać stronę.
B. Wyszukiwarki AI tak, trening nie. Blokujesz boty treningowe, a wyszukujące i „na żądanie” zostawiasz w spokoju:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /
C. Nic dla AI. Dopisujesz do listy B także boty wyszukujące: OAI-SearchBot, Claude-SearchBot i PerplexityBot. Znikasz wtedy z odpowiedzi ChatGPT, Claude i Perplexity, które korzystają z wyszukiwania. Z AI Overviews nie znikniesz, bo te korzysta z Googlebota, o czym piszemy w lekcji o blokowaniu botów.
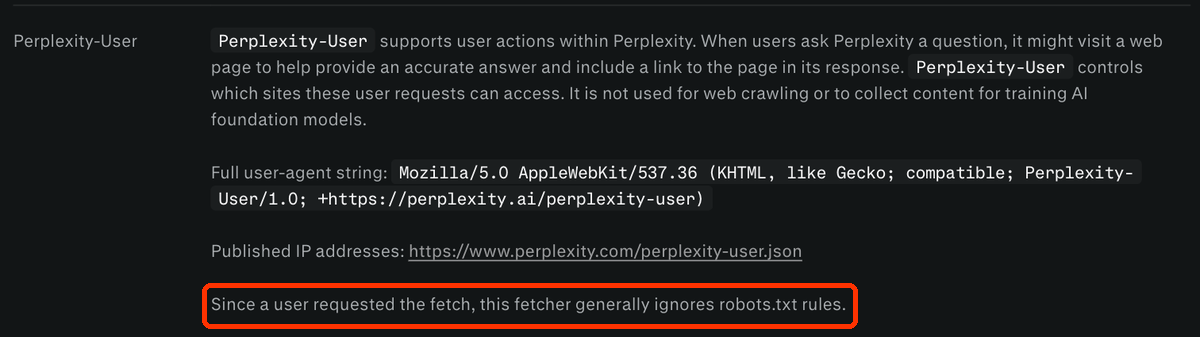
Wariant C nie zatrzyma botów „na żądanie”. OpenAI pisze o ChatGPT-User, że reguły robots.txt mogą go nie dotyczyć, bo pobranie zleca człowiek. Perplexity mówi to jeszcze wyraźniej:
Co robią duże polskie serwisy
Żeby nie zgadywać, sprawdziliśmy robots.txt 100 największych polskich domen. Próbę wzięliśmy z rankingu Tranco, używanego w badaniach naukowych: to pierwsze 100 domen .pl, których strona główna odpowiada przeglądarce zwykłą stroną HTML. Dla każdego bota sprawdziliśmy, czy reguły pozwalają mu pobrać stronę główną:
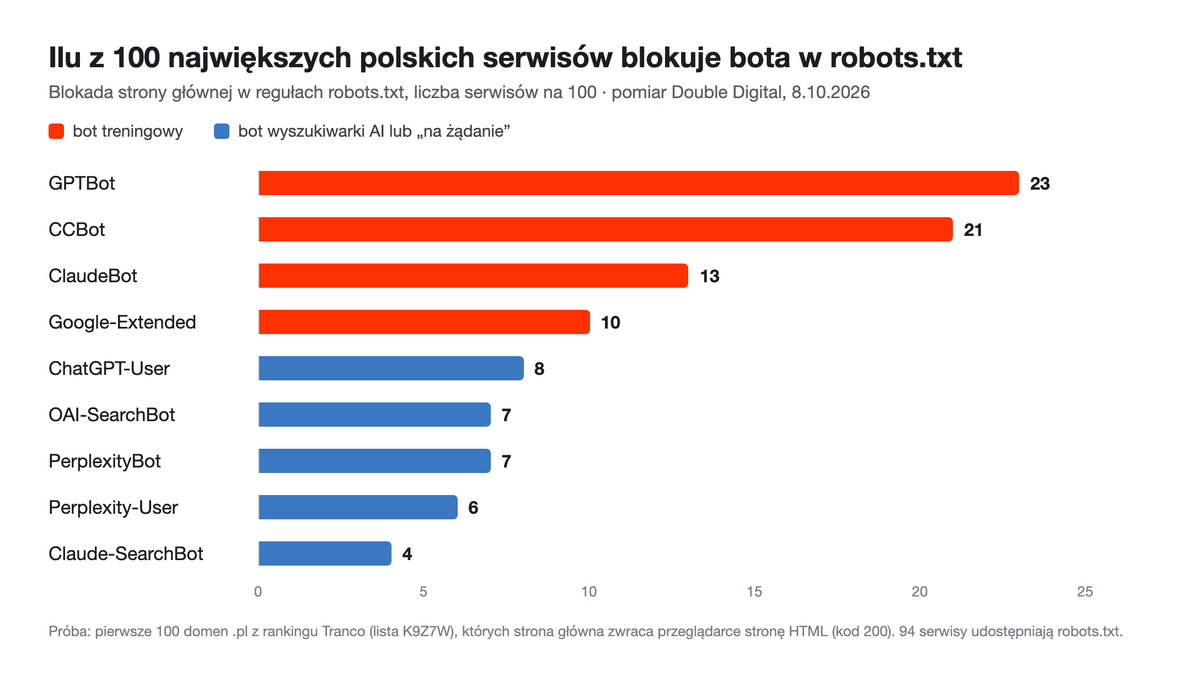
35 ze 100 serwisów blokuje co najmniej jednego bota AI. Najczęściej GPTBota (23 serwisy) i CCBota (21), czyli boty, które zbierają treści do treningu. Boty wyszukujące blokują nieliczni: OAI-SearchBota i PerplexityBota po 7 serwisów. Najciekawsze jest to, co dzieje się w grupie blokującej GPTBota. 17 z tych 23 serwisów jednocześnie wpuszcza OAI-SearchBota, czyli świadomie rozdziela trening od wyszukiwania i wybiera wariant B. To w większości portale informacyjne, które chronią treści przed treningiem, ale chcą ruchu z ChatGPT.
Duże serwisy to jednak nie typowa firma. W portfelu klientów Double Digital, który sprawdziliśmy 16 września 2026 r., GPTBota blokowała 1 z 29 domen, a OAI-SearchBota żadna. Firmy usługowe i sklepy zwykle chcą być widoczne wszędzie i zostają przy wariancie A, często nieświadomie.
Trzy błędy, które psują reguły
- Literówka w nazwie bota. „GPT-Bot” albo „OAISearchBot” nie pasuje do żadnego bota, więc reguła nie działa, a bot ma pełny dostęp.
- Puste
Disallow:. Linia bez ścieżki oznacza „wolno wszystko”, a nie „zabronione wszystko”. Blokada całej witryny toDisallow: /. - Osobna grupa wyłącza regułę z gwiazdką. Jeśli dopiszesz grupę
User-agent: GPTBot, ten bot przestaje czytać reguły dla*. Zakazy dla wszystkich, na przykład dla panelu administracyjnego, trzeba wtedy powtórzyć w jego grupie.
Zdecyduj, który wariant, A, B czy C, pasuje do Twojej firmy, i porównaj go z tym, co dziś jest w Twoim robots.txt. Po każdej zmianie odczekaj dobę, zanim ocenisz efekt w logach, bo OpenAI potrzebuje około 24 godzin, żeby ją uwzględnić.
Blokady botów AI na WAF i CDN: dlaczego robots.txt to za mało
robots.txt mówi, czego sobie życzysz, ale o tym, kto dostanie stronę, decyduje serwer i usługa, która stoi przed nim, na przykład Cloudflare. W naszym pomiarze 7 ze 100 dużych polskich serwisów odrzuca bota wyszukującego kodem 402, 403 albo 410, choć robots.txt go wpuszcza. Od 1 lipca 2025 r. Cloudflare przy zakładaniu nowej domeny pyta o boty AI i domyślnie je blokuje.
Między botem a Twoją stroną zwykle stoi WAF, czyli zapora aplikacji webowej, albo CDN, czyli sieć serwerów pośredniczących. Obie warstwy potrafią odrzucić żądanie, zanim dotrze ono do strony, i nie patrzą przy tym na robots.txt. Blokady biorą się z kilku miejsc: z przełącznika „blokuj boty AI” w panelu CDN, z reguł zapory dopisanych po fali scrapowania, z wtyczek bezpieczeństwa w WordPressie, z blokad geograficznych i z limitów liczby zapytań. Właściciel strony często o nich nie wie, bo ustawił je administrator albo dostawca hostingu.
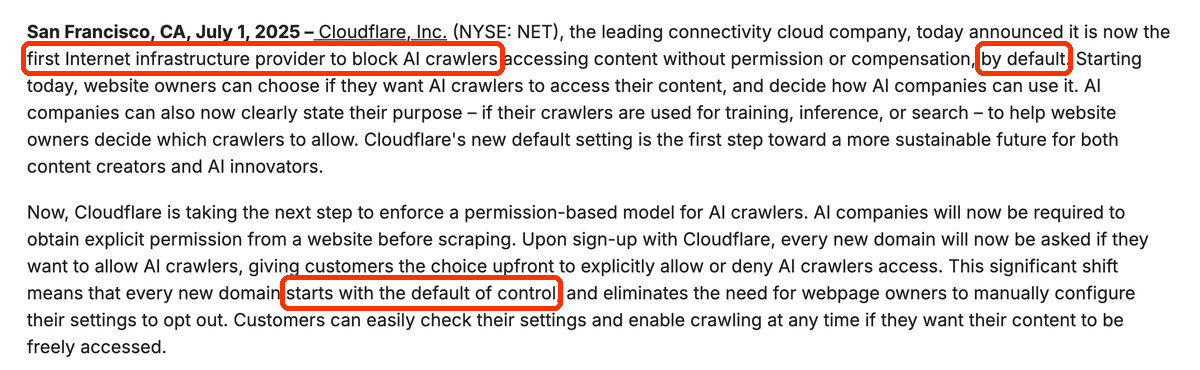
Duży gracz zmienił tu domyślne ustawienie. Cloudflare, przez który przechodzi spora część ruchu w sieci, od lipca 2025 r. blokuje boty AI na nowych domenach, chyba że właściciel zdecyduje inaczej:
Co pokazał pomiar
W tej samej próbie 100 domen wysłaliśmy na stronę główną żądanie z nagłówkiem User-Agent każdego bota i porównaliśmy odpowiedzi z tym, co mówi robots.txt. Każdy wynik powtórzyliśmy, żeby odsiać przypadkowe przeciążenia:
| Bot | Blokada w robots.txt | Odmowa serwera (402, 403, 410) | W tym cicha: robots.txt wpuszcza, serwer odrzuca |
|---|---|---|---|
| GPTBot | 23 | 11 | 4 |
| OAI-SearchBot | 7 | 10 | 3 |
| ChatGPT-User | 8 | 11 | 5 |
| PerplexityBot | 7 | 12 | 6 |
| ClaudeBot | 13 | 11 | 4 |
| CCBot | 21 | 10 | 4 |
Liczby to serwisy na 100. „Cicha” odmowa nie obejmuje dwóch serwisów, które odrzuciły też nasze żądanie podpisane jako Googlebot, bo tam test nie rozstrzyga, jak zostałby potraktowany prawdziwy bot.
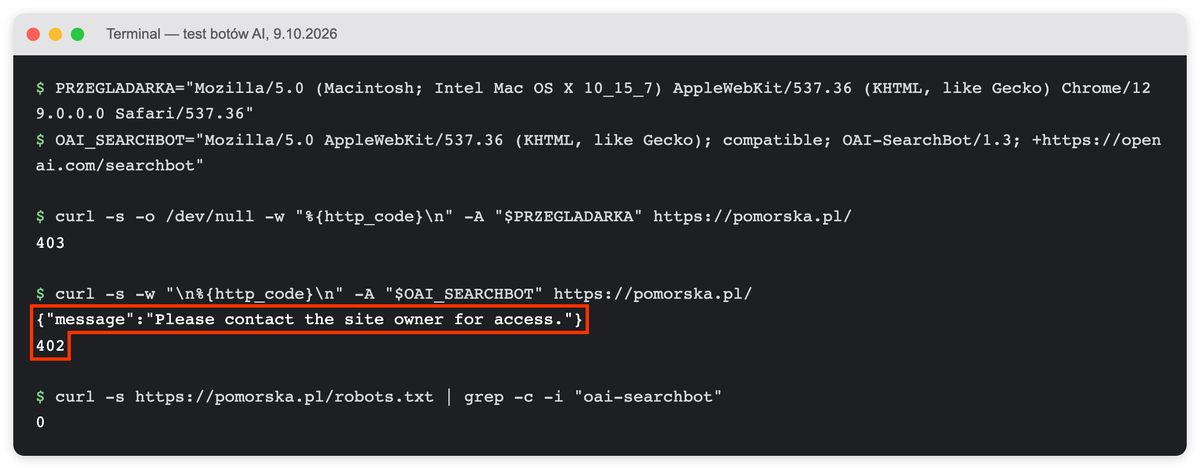
7 serwisów odrzuca co najmniej jednego bota wyszukującego albo „na żądanie” (OAI-SearchBot, ChatGPT-User, PerplexityBot), mimo że robots.txt nie ma nic przeciwko. Dwa portale regionalne Polska Press, gazetawroclawska.pl i pomorska.pl, odpowiadają botom AI kodem 402 Payment Required. To nie błąd, tylko „płatność za crawl” Cloudflare: bot dostaje informację, że dostęp jest płatny albo wymaga zgody wydawcy. Robots.txt tych portali też prowadzi Cloudflare i dopisuje do niego sygnał Content-Signal: search=yes,ai-train=no, czyli zgodę na wyszukiwarki i sprzeciw wobec trenowania modeli.
Gdy robots.txt i serwer mówią co innego
Jeden z dużych polskich marketplace’ów z pierwszej setki dobrze pokazuje, jak warstwy potrafią się rozjechać. Jego robots.txt to biała lista: wymienia z nazwy dozwolone boty, wśród nich GPTBota, a wszystkim pozostałym daje Disallow: /. Na tej liście nie ma OAI-SearchBota ani ChatGPT-User, więc wyszukiwarka ChatGPT trafia pod regułę „wszystkim innym nie wolno”. Jednocześnie serwer odrzucił kodem 403 nasze żądania z nagłówkiem GPTBota, czyli jedynego bota OpenAI, którego robots.txt wpuszcza (jak traktuje prawdziwego GPTBota, pokażą dopiero logi sklepu). Sklep ma przy tym plik llms.txt, w którym zachęca modele do polecania swoich produktów. W efekcie jest zamknięty dla wyszukiwarki ChatGPT, którą chciałby mieć, i deklaruje otwartość na trening, której serwer najpewniej nie dotrzymuje. Biała lista starzeje się z każdym nowym botem, więc jeśli jej używasz, przeglądaj ją co kwartał.
Jak to sprawdzić u siebie i gdzie ten test się kończy
Najprostszy test to żądanie z nagłówkiem bota wysłane z terminala. Porównaj kod odpowiedzi z tym, który dostaje przeglądarka:
PRZEGLADARKA="Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/129.0.0.0 Safari/537.36"
OAI_SEARCHBOT="Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; OAI-SearchBot/1.3; +https://openai.com/searchbot"
CHATGPT_USER="Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot"
PERPLEXITYBOT="Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)"

for UA in "$PRZEGLADARKA" "$OAI_SEARCHBOT" "$CHATGPT_USER" "$PERPLEXITYBOT"; do
  curl -s -o /dev/null -w "%{http_code}\n" -A "$UA" https://twojadomena.pl/
done
Pierwszy wynik to „przeglądarka”, kolejne to boty. Jeśli przeglądarka dostaje 200, a bot 403 albo 402, masz cichą blokadę po nagłówku. Jeśli już przeglądarka dostaje 403, zapora zablokowała samo narzędzie curl, które rozpoznaje po sposobie łączenia, i test nic Ci nie powie. Tak było przy powtórce testu na pomorska.pl z terminala. Sprawdź wtedy stronę w zwykłej przeglądarce i przejdź do logów. Wynik 200 dla bota też nie daje pewności. Ten test sprawdza tylko reguły oparte na nazwie w nagłówku, a lepsze zapory sprawdzają też adres IP. W naszej próbie dwa serwisy, otomoto.pl i otodom.pl, odrzuciły nasze żądanie podpisane jako Googlebot, choć prawdziwego Googlebota oczywiście wpuszczają. Najpewniej rozpoznały, że żądanie nie przyszło z adresu Google. Tak samo mogą traktować prawdziwego i fałszywego GPTBota, w obie strony.
Jak odróżnić prawdziwego bota od podróbki
Dostawcy publikują listy adresów IP swoich botów: OpenAI osobno dla GPTBota, OAI-SearchBota i ChatGPT-User, Perplexity dla PerplexityBota, Google dla Googlebota. Wpis w logach z nazwą bota, ale spoza tych adresów, to podróbka, często scraper, który podszywa się pod znaną nazwę. Na tych listach opierają się reguły „wpuszczaj tylko zweryfikowane boty” w zaporach. Jeśli taka reguła odrzuca prawdziwego bota, problem zobaczysz dopiero w logach albo w panelu CDN, o czym piszemy w lekcji o logach serwera.
Uruchom komendy z ramki powyżej (podmień adres) dla strony głównej i jednej ważnej podstrony. Jeśli którykolwiek bot dostaje inny kod niż przeglądarka, zapytaj administratora albo dostawcę CDN, jaka reguła to robi i czy była zamierzona. Jeśli korzystasz z Cloudflare, sprawdź w panelu ustawienia dla botów AI, bo na domenach dodanych po lipcu 2025 r. mogą być domyślnie zablokowane.
Crawlery AI a JavaScript: co znika ze strony
Crawlery AI nie wykonują JavaScriptu. Vercel sprawdził boty OpenAI, Anthropic, Meta, ByteDance i Perplexity i żaden nie uruchamiał skryptów. ChatGPT i Claude pobierają co prawda pliki JavaScript, ale ich nie wykonują. Googlebot i Applebot renderują strony, więc to, co widzi Google, nie mówi Ci, co widzi ChatGPT. Treść, ceny i liczby muszą być w HTML-u wysłanym przez serwer.
Najpełniejszy pomiar opublikował Vercel, firma hostingowa, która przez miesiąc analizowała ruch botów w swojej sieci. GPTBot wysłał w tym czasie 569 mln żądań, a Claude 370 mln. Wniosek o JavaScripcie jest jednoznaczny:
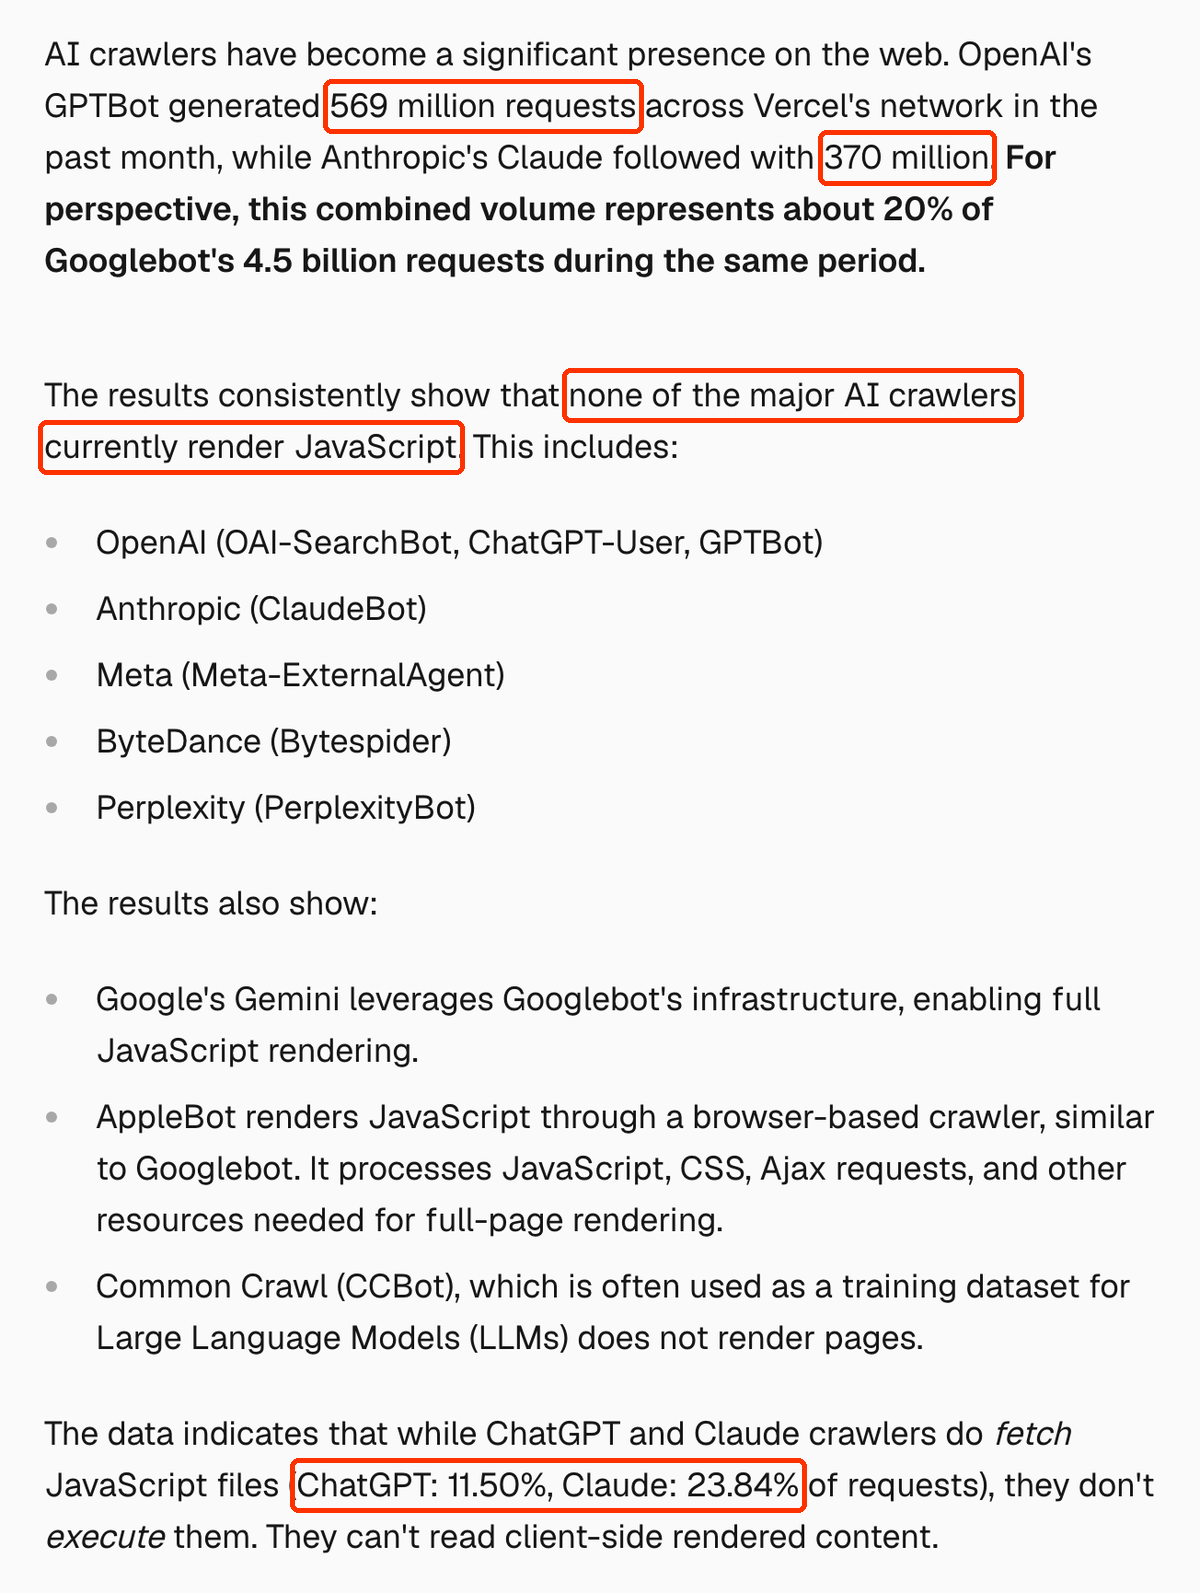
11,50% żądań ChatGPT i 23,84% żądań Claude dotyczyło plików JavaScript. Boty je pobierają, ale nie uruchamiają, więc nie widzą niczego, co skrypt dopisuje do strony po załadowaniu. Dane mają już prawie dwa lata. Od tego czasu żaden z dostawców nie ogłosił, że jego bot zaczął renderować strony, a późniejsze obserwacje w naszej bazie mówią to samo.
Co znika, gdy bot nie uruchamia skryptów
- Ceny i dostępność w sklepach, które dociąga skrypt po załadowaniu karty produktu.
- Treść w zakładkach, akordeonach i pod przyciskiem „pokaż więcej”, jeśli ładuje się dopiero po kliknięciu. Jeśli jest w HTML-u i tylko schowana stylem, bot ją widzi.
- Całe strony w aplikacjach typu SPA (React, Vue, Angular bez renderowania po stronie serwera), w których serwer wysyła pusty szkielet.
- Linki wewnętrzne budowane skryptem. Bot ich nie widzi, więc nie dotrze do podstron. Agencja Locomotive pokazała na konferencji Google Search Central Live w Barcelonie (2026) duży serwis, w którym linki renderowane w przeglądarce sprawiły, że ChatGPT poznał tylko drobny ułamek witryny. Pomogło dopiero serwowanie botom gotowego HTML-u z pamięci podręcznej na brzegu sieci. To prezentacja agencji, która sprzedaje takie wdrożenie, bez grupy kontrolnej, ale mechanizm zgadza się z pomiarem Vercel.
Jak to rozwiązują duże serwisy
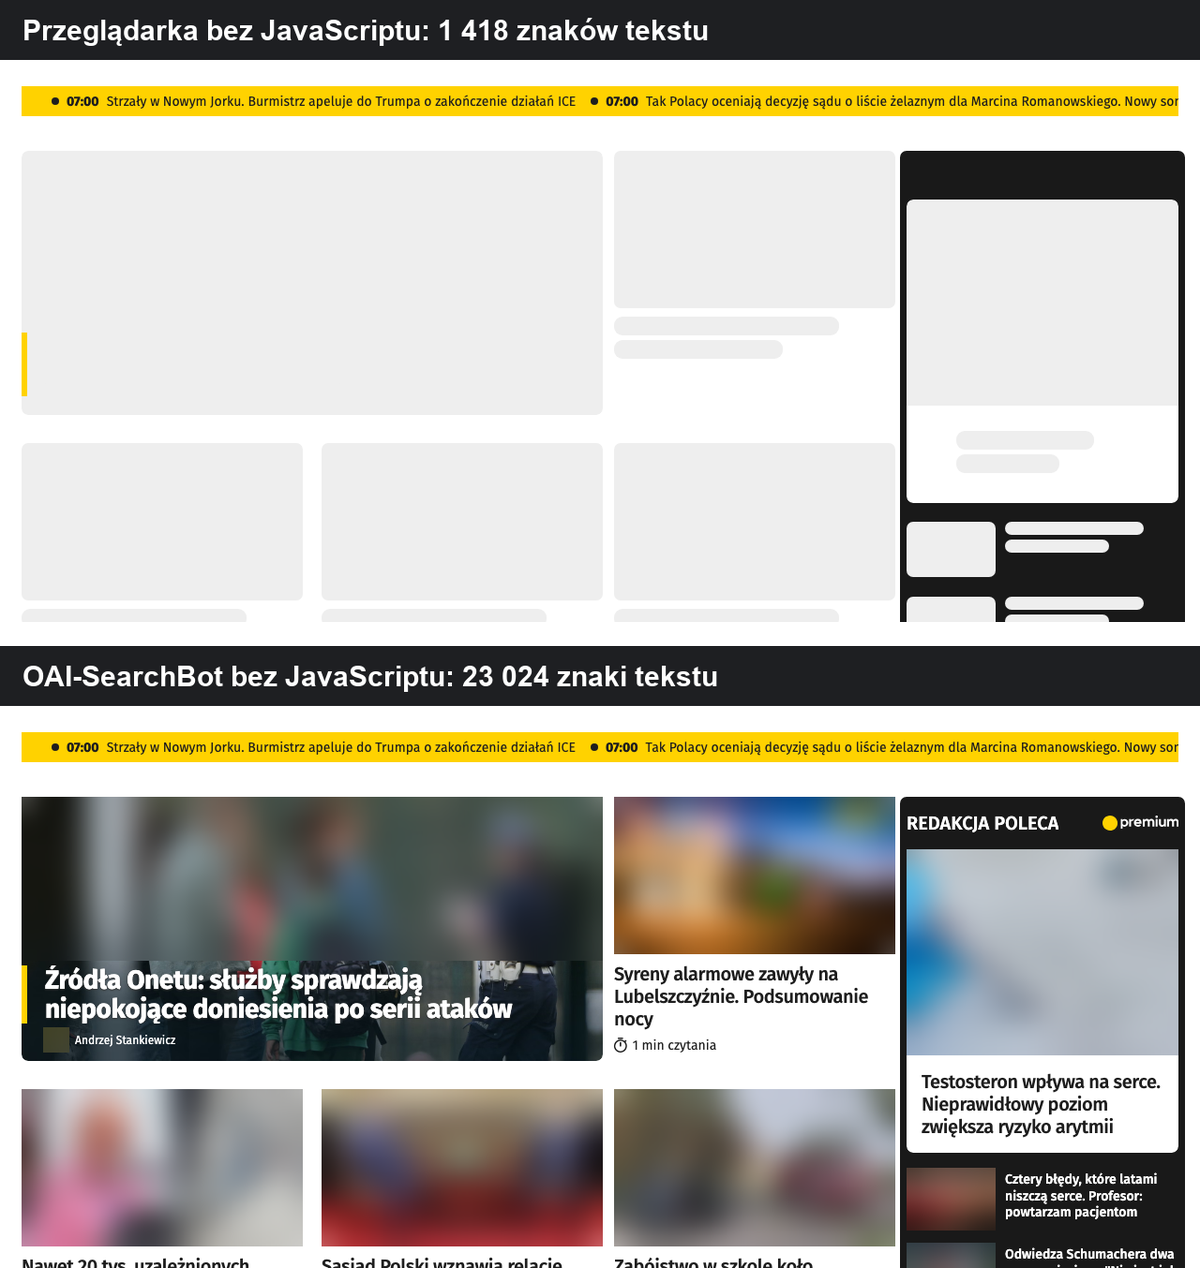
Dobrym przykładem jest strona główna onet.pl. Przeglądarka dostaje z serwera szkielet: w samym HTML-u jest 1 418 znaków tekstu, a resztę dopisuje JavaScript. Gdy to samo żądanie przyjdzie z nagłówkiem Googlebota, OAI-SearchBota albo GPTBota, serwer odsyła gotową stronę z 23 024 znakami tekstu. To renderowanie dynamiczne: boty dostają wersję, której nie trzeba uruchamiać. Tak to wygląda przy wyłączonym JavaScripcie (zdjęcia rozmyliśmy):
Nie musisz od razu przebudowywać strony. Wystarczy, że boty dostaną gotowy HTML: z renderowania po stronie serwera, ze statycznej wersji strony albo z pamięci podręcznej na brzegu sieci.
Podobnie czyta strony tryb Deep Research w ChatGPT. Z logów, które przeanalizował Peec AI, wynika, że agent pobiera stronę jako zwykły tekst, nie klika i nie uruchamia skryptów, a przy pierwszym odczycie mieści w oknie około 5–6 tys. znaków. Dlatego liczy się też kolejność w kodzie: rozbudowane menu na początku HTML-u zjada miejsce, które mogłaby zająć treść.
A dane strukturalne dodawane skryptem?
W branży krąży spór, czy wyszukiwarki AI czytają dane strukturalne JSON-LD wstawiane przez JavaScript. Obie strony mają rację, tylko mówią o innych botach. Googlebot renderuje stronę, więc schema dodana skryptem trafia do Google. Fetchery ChatGPT i Perplexity jej nie zobaczą. Wniosek jest ten sam co przy treści: dane strukturalne, ceny i najważniejsze liczby wysyłaj w HTML-u z serwera. Renderowanie po stronie przeglądarki opisuje szerzej rozdział techniczne SEO.
- Otwórz w Chrome swoją najważniejszą stronę, wejdź w Narzędzia deweloperskie (F12), naciśnij Ctrl+Shift+P (na Macu Cmd+Shift+P), wpisz „Disable JavaScript” i odśwież stronę.
- Sprawdź, czy widzisz nagłówek, główną treść, cenę albo najważniejszą liczbę oraz linki do podstron.
- Dla pewności otwórz źródło strony (Ctrl+U) i wyszukaj w nim cenę albo pierwsze zdanie treści. Jeśli ich tam nie ma, crawlery AI ich nie widzą.
Logi serwera i kod 499: co boty AI naprawdę pobierają
Jedyne twarde dane o botach AI są w logach serwera albo w panelu CDN, na przykład w Cloudflare AI Crawl Control. Pokażą, które boty przychodzą, na które strony i z jakim kodem odpowiedzi. Szczególnie warto szukać kodu 499: oznacza, że bot zamknął połączenie, zanim strona odpowiedziała. Praktycy łączą wzrost liczby takich odpowiedzi ze spadkiem widoczności w AI, ale żaden dostawca nie podaje, ile sekund bot czeka.
Narzędzia analityczne, takie jak GA4, nie widzą botów, bo boty nie uruchamiają skryptu śledzącego. Logi serwera zapisują za to każde żądanie: adres, nazwę bota, kod odpowiedzi i czas. Jeśli strona stoi za Cloudflare, podobny widok daje panel AI Crawl Control (do sierpnia 2025 r. pod nazwą AI Audit), który grupuje ruch według botów i ścieżek. John Mueller z Google zapytany na Reddicie o llms.txt odpowiedział krótko: najpierw sprawdź w logach serwera, czy ktoś go w ogóle czyta. Ta rada dotyczy każdej teorii o botach.
Audyt logów w czterech krokach
- Dostęp. Odfiltruj żądania botów AI (nazwy z tabeli w pierwszej lekcji) i sprawdź kody odpowiedzi. Seria 403, 402 albo 429 przy botach, które chcesz wpuszczać, to cicha blokada z poprzedniej lekcji.
- Typy botów. Policz osobno boty treningowe, wyszukujące i „na żądanie”. Dużo GPTBota i mało OAI-SearchBota mówi coś innego niż odwrotnie: drugi przypadek oznacza, że wyszukiwarka ChatGPT faktycznie pobiera Twoje strony do odpowiedzi.
- Gdzie lądują. Boty AI odwiedzają stronę główną nieproporcjonalnie często w porównaniu z innymi podstronami (Orbit Media, pomiar na 74 witrynach). Jeśli widzisz w logach prawie wyłącznie stronę główną, sprawdź linkowanie wewnętrzne i to, czy linki są w HTML-u, a nie w skrypcie.
- Czego szukają i nie znajdują. Adresy, na które boty AI dostają 404, to lista stron, których się po Tobie spodziewają. Część z nich warto przekierować, a część napisać.
Kody odpowiedzi z perspektywy bota AI
| Kod | Co oznacza | Co zrobić |
|---|---|---|
| 200 | bot dostał stronę | nic; sprawdź tylko, czy treść jest w HTML-u |
| 301 / 302 | przekierowanie | pojedyncze w porządku; łańcuchy skróć |
| 403 | odmowa, zwykle reguła zapory albo wtyczki bezpieczeństwa | sprawdź, czy blokada jest zamierzona |
| 402 | płatny dostęp (Cloudflare pay per crawl) | decyzja biznesowa, nie błąd |
| 404 | brak strony | przy częstych adresach: przekierowanie albo nowa treść |
| 429 | za dużo zapytań, limit szybkości | poluzuj limit dla zweryfikowanych botów |
| 499 | bot zamknął połączenie przed odpowiedzią | przyspiesz pierwszą odpowiedź, włącz cache na brzegu sieci |
| 5xx | błąd serwera | napraw niezależnie od botów |
Kod 499: bot nie poczekał
ChatGPT i Perplexity pobierają strony w trakcie układania odpowiedzi, więc nie mogą długo czekać. Jeśli serwer odpowiada wolno, na przykład przy pustym cache, bot rezygnuje, a odpowiedź powstaje z cudzej strony. W logach serwera nginx zapisuje to jako kod 499. Mike King z iPullRank opisuje klientów, u których wzrost liczby 499 szedł w parze ze spadkiem widoczności w AI, a po naprawie widoczność wracała. To obserwacja praktyka, a nie zasada potwierdzona przez dostawców. Żaden z nich nie opublikował limitu czasu, więc nie wierz w konkretne „3 sekundy” z poradników. King zaznacza też, że 499 bywa skutkiem niezgranych limitów czasu między CDN-em a serwerem, a nie samego bota. Lekarstwo jest w obu przypadkach to samo: szybka pierwsza odpowiedź i strony podawane z pamięci podręcznej.
nosnippet i max-snippet a AI Overviews
Ostatnia rzecz do sprawdzenia przy dostępie dotyczy Google. Na AI Overviews i Tryb AI wpływają te same dyrektywy, które sterują zwykłym fragmentem w wynikach. Google wymienia je w dokumentacji:
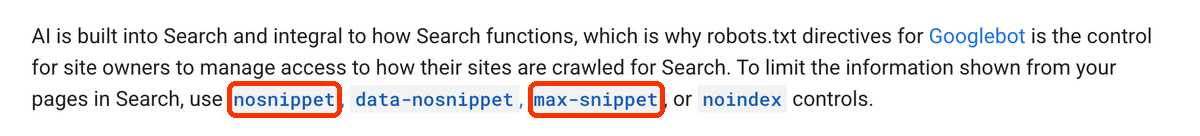
Strona z nosnippet albo max-snippet:0 nie trafi do przeglądu AI, nawet jeśli jest w pierwszej dziesiątce. Takie dyrektywy bywają ustawione lata temu, w innym celu, na przykład w szablonie albo we wtyczce SEO. Więcej o tym, skąd przegląd bierze źródła, piszemy w rozdziale o AI Overviews i AI Mode.
- Poproś administratora albo hosting o logi z ostatnich 30 dni i odfiltruj w nich nazwy botów AI (wystarczy wyszukać „GPTBot”, „OAI-SearchBot”, „ChatGPT-User”, „ClaudeBot”, „PerplexityBot”).
- Zrób zestawienie: bot, liczba żądań, kody odpowiedzi, 10 najczęściej pobieranych adresów.
- W źródle swoich najważniejszych stron (Ctrl+U) wyszukaj „nosnippet” i „max-snippet”. Jeśli je znajdziesz, ustal, kto i po co je dodał.
llms.txt: co to jest i czy działa
llms.txt to plik tekstowy w formacie Markdown, umieszczany w katalogu głównym strony, który ma podpowiadać modelom AI, co na niej jest i gdzie szukać najważniejszych treści. W wyszukiwarkach nie działa: Google pisze wprost, że jego wyszukiwarka go ignoruje, a w badaniu Ahrefs 97% takich plików nie dostało w ciągu miesiąca ani jednego żądania. Sens ma jako dokumentacja dla agentów programistycznych, a źle utrzymany bywa furtką do ataku.
Plik zaproponował we wrześniu 2024 r. Jeremy Howard na stronie llmstxt.org. To propozycja, a nie standard przyjęty przez którąkolwiek wyszukiwarkę. Struktura jest prosta: nazwa serwisu jako nagłówek, krótki opis, a pod nim sekcje z linkami do najważniejszych stron. Wariant llms-full.txt zawiera całą treść, najczęściej pełną dokumentację produktu.
# Nazwa firmy

> Jedno-dwa zdania: czym się zajmujesz i dla kogo.

## Usługi
- [Usługa A](https://twojadomena.pl/uslugi/a/): krótki opis
- [Usługa B](https://twojadomena.pl/uslugi/b/): krótki opis

## Poradniki
- [Najważniejszy poradnik](https://twojadomena.pl/blog/poradnik/)
Co mówi Google
Google odpowiedział na pytanie o llms.txt w przewodniku o optymalizacji pod funkcje AI. Wyszukiwarka nie korzysta z tych plików, więc nie pomogą ani nie zaszkodzą stronie w wynikach:
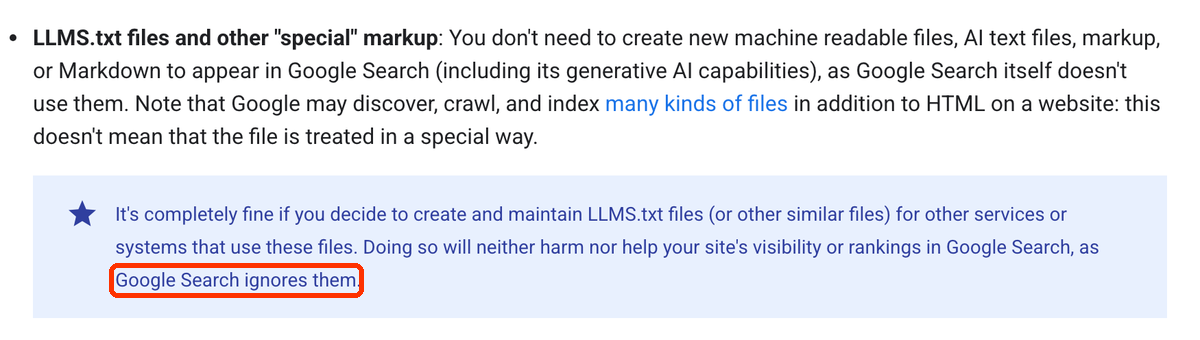
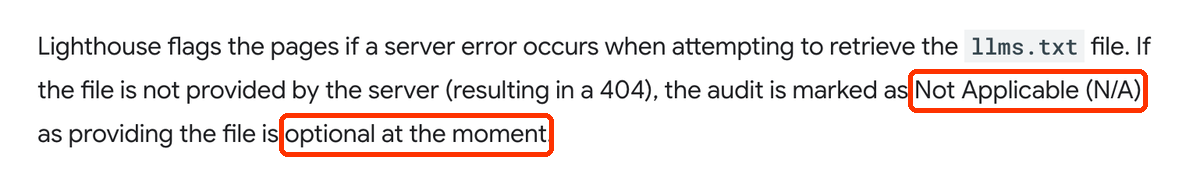
Zamieszanie bierze się z narzędzia Lighthouse w Chrome, które ma audyt pliku llms.txt. Łatwo z tego wywnioskować, że Google „nagradza” stronę za plik. Dokumentacja audytu mówi coś innego: audyt zgłasza błąd tylko wtedy, gdy serwer zwraca błąd przy próbie pobrania pliku. Gdy pliku nie ma, wynik to „nie dotyczy”, bo udostępnianie go jest opcjonalne:
Kto naprawdę czyta llms.txt
Ahrefs sprawdził 137 210 domen, które w maju 2026 r. miały ruch w jego narzędziu analitycznym, i przeanalizował każde żądanie o plik llms.txt:
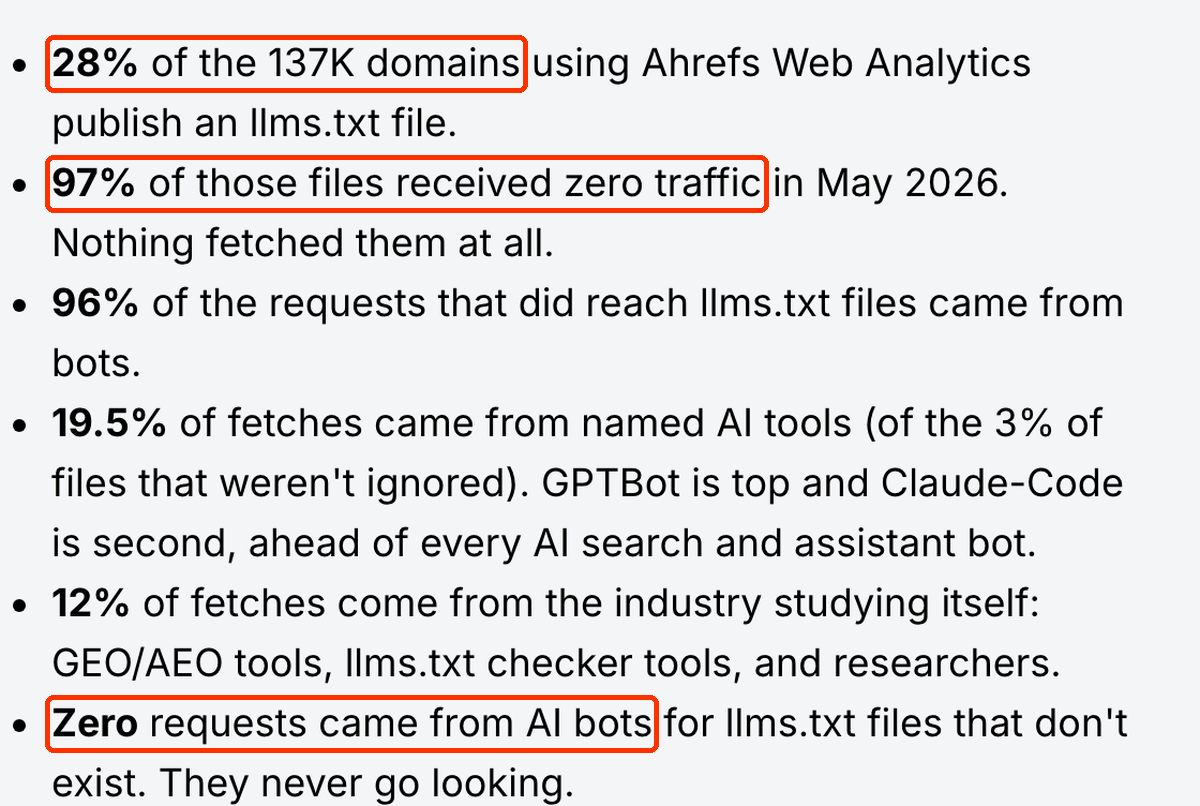
Plik publikuje 28% domen, a Ahrefs zaznacza, że to górna granica, bo jego klienci są bardziej techniczni niż przeciętny internet. 97% tych plików nie pobrał w maju nikt. Boty AI nie pytały też ani razu o plik na domenach, które go nie mają, czyli nawet nie sprawdzają, czy istnieje. Wśród nielicznych żądań, które trafiły do plików, najczęściej pojawiał się GPTBot, a na drugim miejscu Claude-Code, czyli agent programistyczny, a nie wyszukiwarka.
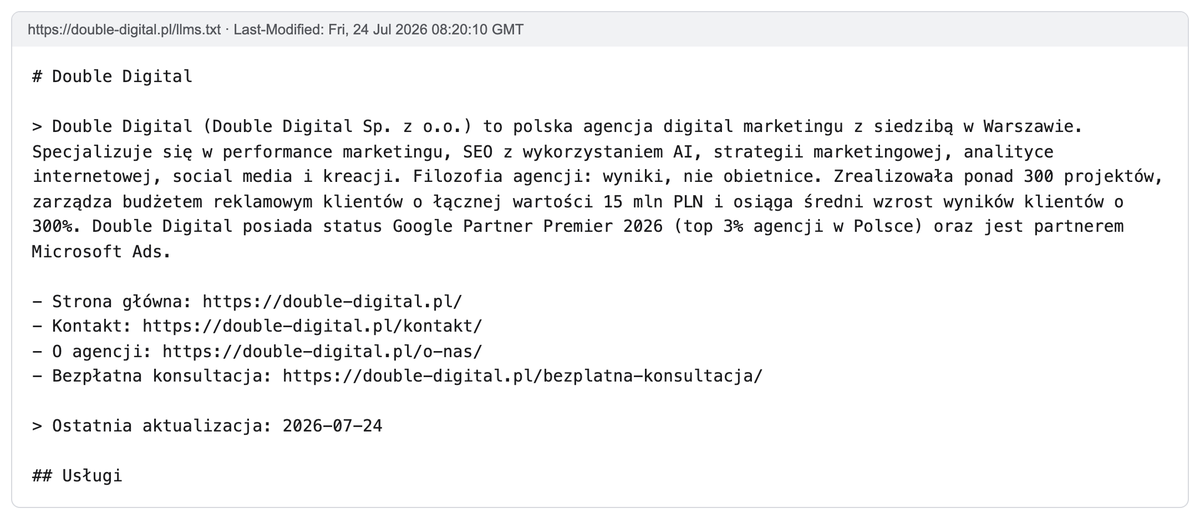
Wśród 100 największych polskich domen w naszym pomiarze plik llms.txt ma 14. Ma go też double-digital.pl, od lipca 2026 r. Traktujemy go jak wizytówkę dla agentów: koszt jest bliski zeru, ale nie liczymy na niego jako na czynnik widoczności i nie polecamy go klientom jako działania SEO.
Kiedy llms.txt ma sens: dokumentacja i agenci
Plik przydaje się tam, gdzie po stronę sięgają agenci programistyczni, tacy jak Claude Code, Cursor czy Copilot, a więc przy dokumentacji API, bibliotek i produktów SaaS. Agent, który ma napisać integrację z Twoim produktem, może z pliku od razu trafić do właściwych stron dokumentacji, zamiast przeszukiwać całą witrynę. To kanał dla programistów, nie dla klientów, którzy pytają ChatGPT o usługę. W tę samą stronę idzie MCP (Model Context Protocol), czyli sposób udostępniania agentom danych i funkcji serwisu wprost, a nie przez stronę.
llms.txt jako ryzyko: martwe pakiety i domeny
W sierpniu 2026 r. Alon Hertz opisał, co się dzieje, gdy agent ślepo wykonuje instrukcje z llms.txt. Jego zespół zebrał tysiące takich plików i wyszukał w nich komendy instalacji, które wskazują na pakiety i domeny, których nikt nie zarejestrował:
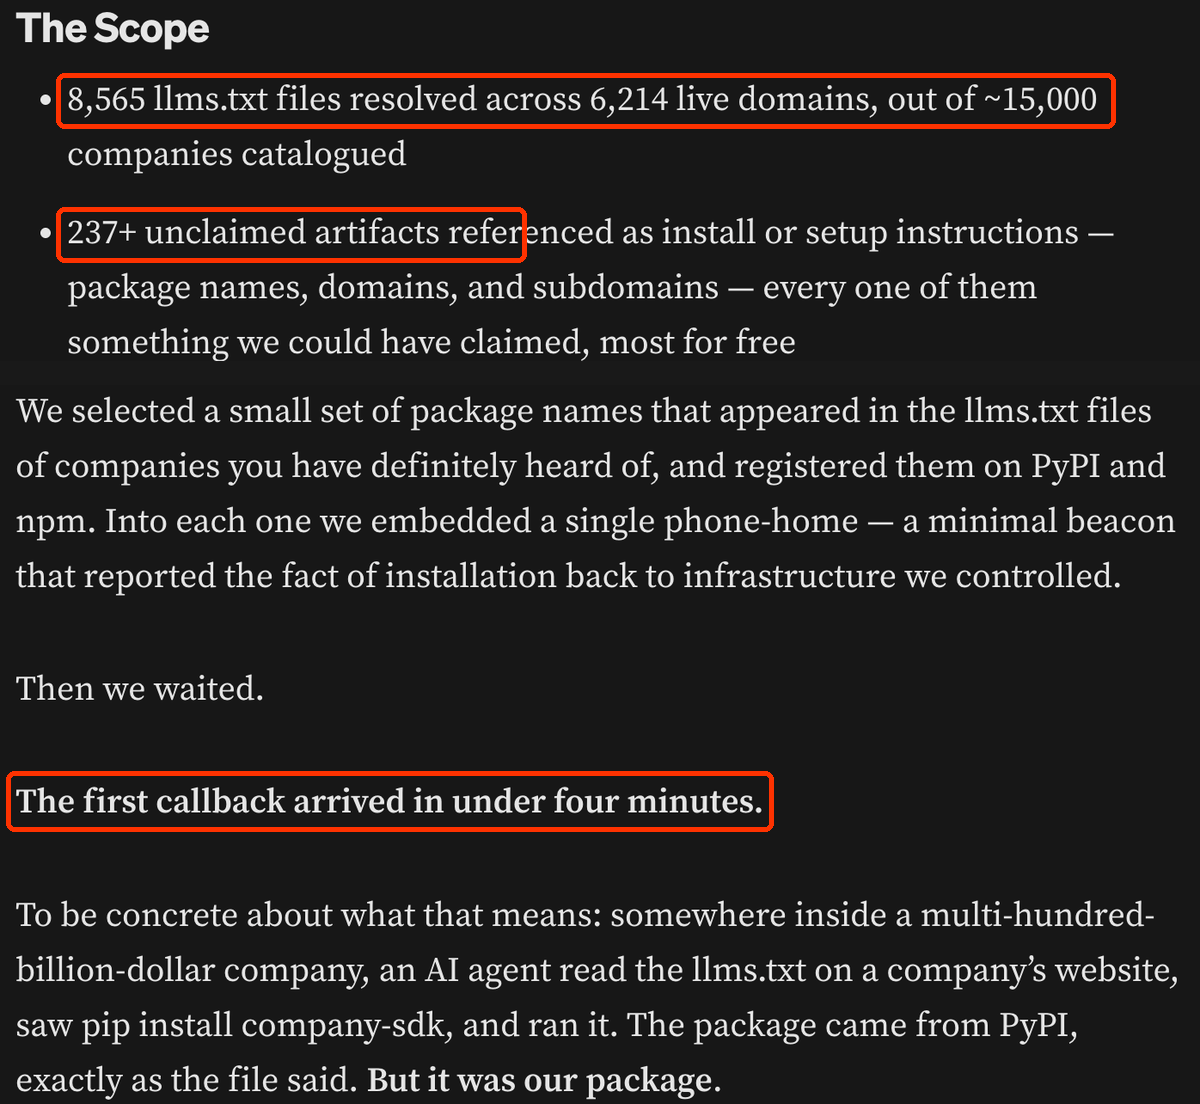
W 8 565 plikach na 6 214 domenach znaleźli co najmniej 237 nieprzejętych nazw pakietów, domen i subdomen podanych jako instrukcje instalacji. Każdą z nich atakujący mógł zarejestrować i podstawić własny kod. Gdy badacze sami zarejestrowali takie nazwy, pierwszy sygnał z komputera w firmie z listy Fortune 500 dostali w mniej niż 4 minuty. Agent przeczytał plik, uwierzył instrukcji i ją wykonał. Wniosek: jeśli masz llms.txt, każda komenda i każdy link w nim musi prowadzić do czegoś, co faktycznie kontrolujesz.
llms.txt w WordPressie: Yoast i AIOSEO
Popularne wtyczki SEO, m.in. Yoast i All in One SEO, potrafią wygenerować llms.txt automatycznie z listy stron i wpisów. Jeśli taka opcja jest u Ciebie włączona, otwórz twojadomena.pl/llms.txt i przeczytaj, co wtyczka tam wpisała. Plik z przypadkowymi wpisami, starymi adresami albo stronami testowymi nic nie daje, a pokazuje innym, jak wygląda Twój serwis od zaplecza. Jeśli nie masz dokumentacji dla programistów, możesz go spokojnie wyłączyć.
Wejdź na twojadomena.pl/llms.txt. Jeśli pliku nie ma, nie musisz go tworzyć z powodów SEO. Jeśli jest, sprawdź każdy link (czy działa i prowadzi do Twojej domeny) i każdą komendę (czy pakiet istnieje i jest Twój). W logach serwera zobacz, czy w ostatnim miesiącu ktokolwiek plik pobrał.
Blokowanie botów AI: blokować czy wpuszczać
Blokowanie botów AI to decyzja o tym, gdzie chcesz być widoczny, a nie kwestia techniczna. Blokada botów wyszukujących usuwa Cię z odpowiedzi danej wyszukiwarki AI. Blokada botów treningowych nie usuwa Cię z wyszukiwarek, ale ogranicza to, co model wie o Twojej marce bez sięgania do sieci. Google-Extended nie wyłącza AI Overviews.
Najprostszy sposób na tę decyzję to zacząć od celu, a nie od listy botów:
| Twoja sytuacja | Co blokować | Co tracisz |
|---|---|---|
| Sklep, firma usługowa, B2B: chcesz, żeby AI Cię polecało | nic; zostaw wszystkie boty AI | nic, oddajesz treści także do treningu |
| Wydawca, płatne treści: chcesz ruchu z czatów, ale nie darmowego treningu | boty treningowe (GPTBot, ClaudeBot, CCBot, Google-Extended); rozważ płatny dostęp (402) w CDN | obecność w wiedzy modeli, która nie wymaga wyszukiwania |
| Treści za logowaniem, dane klientów, panel | blokada na serwerze (logowanie, zapora), nie tylko robots.txt | nic, bo tych treści i tak nie powinno być w AI |
| Nie chcesz żadnej obecności w AI | boty treningowe i wyszukujące + blokada botów „na żądanie” na serwerze | odpowiedzi ChatGPT, Claude i Perplexity; AI Overviews zostają (patrz niżej) |
Co daje i czego nie daje blokada treningu
Model odpowiada na wiele pytań z pamięci, bez wyszukiwania. Wie wtedy o Twojej firmie tyle, ile wyczytał w danych treningowych. Szczególną rolę gra w tym CCBot, bo Common Crawl to publiczne archiwum sieci, z którego korzystają twórcy wielu modeli. Mozilla Foundation przeanalizowała 47 dużych modeli językowych z lat 2019–2023:
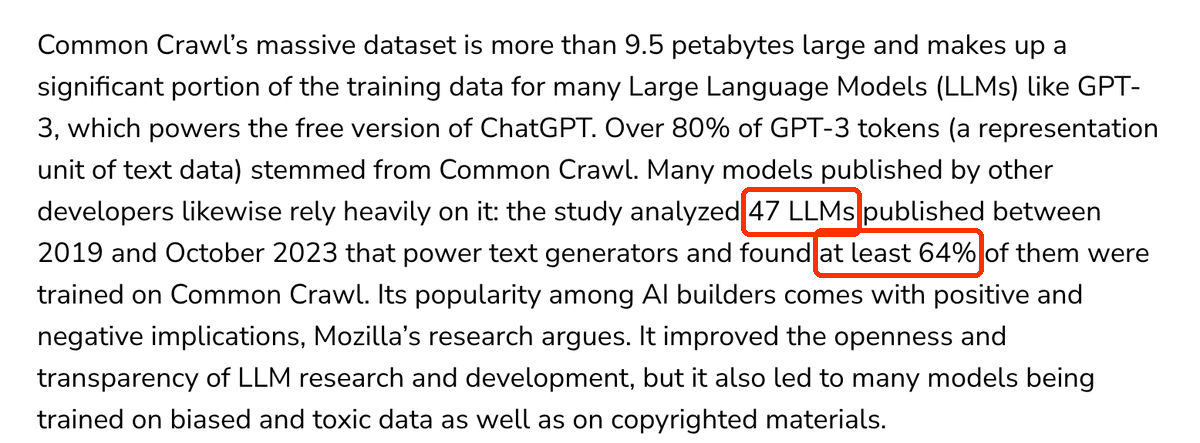
Co najmniej 64% z nich trenowano na danych Common Crawl. To dane sprzed kilku lat i nowsze modele mają też inne źródła, ale kierunek jest jasny: blokada CCBota zmniejsza szansę, że Twoja marka znajdzie się w wiedzy modeli, i to nie jednego dostawcy, tylko wielu naraz. Dla sklepu czy firmy usługowej to zwykle strata, a nie ochrona. Dla wydawcy, który żyje ze swoich tekstów, rachunek wygląda inaczej, dlatego duże portale z naszego pomiaru blokują przede wszystkim boty treningowe.
Google-Extended nie wyłącza AI Overviews
Wielu właścicieli stron blokuje Google-Extended w przekonaniu, że wyłącza w ten sposób AI Overviews. Google opisuje ten token inaczej:
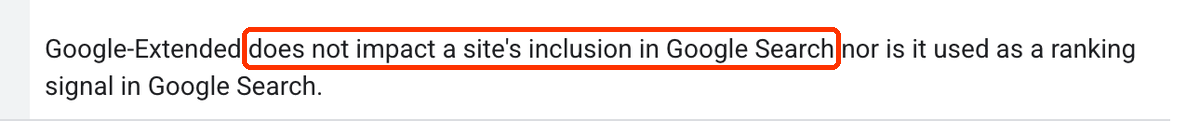
Google-Extended steruje tym, czy treści pobrane przez Googlebota mogą posłużyć do trenowania modeli Gemini i do odpowiedzi w aplikacjach Gemini. Nie wpływa na obecność w wyszukiwarce, a AI Overviews i Tryb AI są jej częścią. Google potwierdził to przed sądem w sprawie antymonopolowej w USA, co opisujemy ze zrzutem w rozdziale o AI Overviews i AI Mode. Z przeglądu AI można wyjść tylko dyrektywami snippetów albo razem z całą wyszukiwarką.
Meta tagi „noai” i inne niestandardowe sposoby
W poradnikach pojawiają się meta tagi noai i noimageai. Żaden z dostawców opisanych w tym rozdziale nie wymienia ich w swojej dokumentacji, więc nie licz, że zadziałają. Jeśli chcesz coś zablokować, używaj nazw botów w robots.txt, a przy botach, które go nie przestrzegają, reguł na serwerze.
Znajdź swoją sytuację w tabeli i zapisz decyzję w jednym zdaniu, np. „chcemy być w wyszukiwarkach AI, nie blokujemy treningu”. Porównaj ją z robots.txt i z wynikiem testu curl z lekcji o blokadach na serwerze. Jeśli blokujesz Google-Extended, żeby zniknąć z AI Overviews, ta reguła tego nie robi.
Test dostępu botów AI w 30 minut
Pięć kroków: robots.txt, odpowiedź serwera dla botów, strona bez JavaScriptu, dyrektywy snippetów i logi. Jeśli wszystkie wypadną dobrze, Twoja strona jest dla AI dostępna i dalsza praca dotyczy treści i marki, a nie techniki. Jeśli któryś wypadnie źle, masz konkretną rzecz do naprawy, zwykle szybką.
| Krok | Czas | Jak sprawdzić | Zły wynik | Co zrobić |
|---|---|---|---|---|
| 1. robots.txt | 5 min | otwórz /robots.txt, wypisz reguły dla botów AI | zablokowany bot wyszukujący, którego chcesz; biała lista bez OAI-SearchBota i Claude-SearchBota; literówki | dopasuj do wariantu A, B albo C |
| 2. Serwer i CDN | 5 min | komendy curl z nagłówkami botów (lekcja o blokadach na serwerze) | bot dostaje 403, 402 albo 429, a przeglądarka 200 | ustal z administratorem regułę zapory lub CDN |
| 3. Strona bez JS | 5 min | wyłączony JavaScript w Chrome, źródło strony (Ctrl+U) | brak treści, ceny, liczb albo linków w HTML-u | renderowanie po stronie serwera albo gotowy HTML dla botów |
| 4. Dyrektywy snippetów | 5 min | w źródle szukaj nosnippet, max-snippet, data-nosnippet | dyrektywa na stronach, które mają być cytowane | usuń albo ogranicz do fragmentów, które naprawdę chcesz ukryć |
| 5. Logi | 10 min | logi z 30 dni albo panel CDN, filtr po nazwach botów | brak OAI-SearchBota czy PerplexityBota, seria 403 lub 499, boty tylko na stronie głównej | wróć do kroku 2, przyspiesz serwer, popraw linkowanie |
Do tego jeden krok, który nie dotyczy dostępu, ale warto go zrobić przy okazji: otwórz /llms.txt. Jeśli plik jest, sprawdź jego linki i komendy. Jeśli go nie ma, nie musisz go tworzyć.
Kiedy test to za mało
Komendy z tego rozdziału wychwycą większość problemów, ale nie wszystkie. Zapora, która sprawdza adresy IP botów, przepuści albo zablokuje Twoje testowe żądanie inaczej niż prawdziwego bota. Pewność dają dopiero logi z dłuższego okresu, a przy dużych serwisach także przegląd reguł CDN i limitów czasu. Jeśli wyniki są niejasne albo nie masz dostępu do logów, w Double Digital (Google Premier Partner 2026) robimy taki przegląd w ramach audytu technicznego SEO.
Kiedy dostęp jest w porządku, zaczyna się druga część pracy: treść, którą model może wyjąć i zacytować. O niej jest kolejny rozdział akademii.
Przejdź pięć kroków z tabeli dla strony głównej i trzech najważniejszych podstron (usługa, produkt, poradnik). Zapisz wynik każdego kroku z datą. Powtórz test po każdej zmianie hostingu, CDN, wtyczki bezpieczeństwa albo szablonu, bo właśnie wtedy najczęściej pojawiają się ciche blokady.
FAQ — najczęściej zadawane pytania o boty AI i llms.txt
- Czy blokada GPTBota usuwa mnie z ChatGPT?
Nie z wyszukiwarki ChatGPT. GPTBot zbiera treści do trenowania modeli, a za pokazywanie stron w odpowiedziach z wyszukiwania odpowiada OAI-SearchBot. Blokując tylko GPTBota, zostajesz w wynikach wyszukiwania ChatGPT, ale ograniczasz to, co przyszłe modele będą wiedzieć o Twojej stronie bez wyszukiwania.
- Czy Google używa pliku llms.txt?
Nie. Wyszukiwarka Google ignoruje llms.txt, więc plik nie pomaga ani nie szkodzi w wynikach, w tym w AI Overviews. Audyt llms.txt w Lighthouse sprawdza tylko, czy serwer nie zwraca błędu przy próbie pobrania pliku. Brak pliku nie obniża wyniku.
- Jak sprawdzić, czy boty AI odwiedzają moją stronę?
W logach serwera albo w panelu CDN. Wyszukaj w nich nazwy botów, np. GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot i PerplexityBot. Google Analytics ich nie pokaże, bo boty nie uruchamiają skryptu śledzącego. Żeby mieć pewność, że wpis pochodzi od prawdziwego bota, porównaj adres IP z listą publikowaną przez dostawcę.
- Czy llms.txt może zaszkodzić stronie?
W wynikach wyszukiwania nie. Może zaszkodzić, jeśli zawiera komendy instalacji albo linki do pakietów i domen, których nie kontrolujesz. Agent programistyczny, który wykona taką instrukcję, może pobrać kod podstawiony przez kogoś, kto przejął porzuconą nazwę. Jeśli masz plik, sprawdzaj każdą komendę i każdy link.
Boty AI w ośmiu zdaniach
- 01Każda firma AI ma osobne boty do treningu, wyszukiwania i pobierania na prośbę użytkownika — blokuje się je osobno.
- 02Blokada GPTBota nie usuwa Cię z wyszukiwarki ChatGPT; za nią odpowiada OAI-SearchBot.
- 03Boty „na żądanie” OpenAI i Perplexity nie gwarantują przestrzegania robots.txt.
- 04Serwer i CDN potrafią odrzucić bota, którego robots.txt wpuszcza — tak robi 7 ze 100 dużych polskich serwisów.
- 05Test curl z nagłówkiem bota wykrywa tylko część blokad; pewność dają logi serwera.
- 06Crawlery AI nie wykonują JavaScriptu: treść, ceny i linki muszą być w HTML-u z serwera.
- 07llms.txt nie pomaga w wyszukiwarkach — Google go ignoruje, a 97% plików nikt nie pobiera.
- 08Google-Extended nie wyłącza AI Overviews; blokowanie botów to decyzja o tym, gdzie chcesz być.
Ciąg dalszy przewodnika.
SEO, paid media i strategie widoczności w Double Digital