AI cytuje zdania, liczby i definicje, a nie całe strony.
W naszym pomiarze polskich AI Overviews (113 odpowiedzi, 400 dopasowanych cytatów) 40,5% cytowanych zdań pochodziło z pierwszych 30% treści strony, a cytowane akapity zawierały liczbę wyraźnie częściej niż reszta tekstu tych samych stron. Najwięcej daje więc odpowiedź postawiona wcześnie, akapit, który da się wyjąć bez kontekstu, i dane, których model nie ma skąd wziąć.
Przepisy na długość i styl, takie jak „akapit 40–60 słów”, „krótsze wygrywa” czy ton autorytatywny, nie mają pokrycia w danych. Przepisanie całego tekstu pod cytat potrafi wręcz obniżyć jego obecność w wynikach.
W tym rozdziale dostajesz pomiar, tabelę mitów z werdyktem i procedurę „dopisz, nie przepisuj”. Przy każdej lekcji podajemy też ocenę dowodu.
AI cytuje zdanie, nie stronę. Stawiaj odpowiedź wcześnie, pisz akapity, które da się wyjąć bez kontekstu, dawaj liczby i dane, których model nie ma skąd wziąć — i nie przepisuj tekstu, który już rankuje.
- potwierdzoneco najmniej dwa niezależne pomiary zgodne co do kierunku
- pojedynczy pomiarjeden pomiar z jawną metodą: kierunek wiarygodny, liczba niepewna
- spornepomiary są sprzeczne albo spór o interpretację nie jest rozstrzygnięty
- mechanizmopis działania z dokumentacji platformy, patentu lub dokumentu sądowego
- praktykaobserwacja z pracy albo rekomendacja bez pomiaru
- obaloneliczba bez pokrycia w źródłach, zbita pomiarem albo wycofana przez autora
Ocena dotyczy tezy, nie źródła: dokumentacja Google opisuje mechanizm, ale nie mierzy jego efektu.
Optymalizacja treści pod AI: model cytuje zdanie, nie stronę
Jednostką cytatu w odpowiedzi AI jest fragment strony: zdanie z liczbą, definicja albo porównanie. Zanim do tego dojdzie, strona musi zostać pobrana i trafić do puli kandydatów. O tym, czy z niej coś zostanie zacytowane, decyduje jednak to, czy jest w niej zdanie, które da się wyjąć i postawić obok pytania użytkownika.
Asystent AI nie czyta Twojej strony tak jak człowiek, od góry do dołu. System wyszukiwania dzieli pobrane strony na fragmenty, porównuje je z pytaniem i do modelu trafia tylko część z nich. Model składa z nich odpowiedź i przy zdaniach, które oparł na konkretnym fragmencie, stawia odnośnik. Szczegóły tego mechanizmu, od dzielenia strony na kawałki po ranking fragmentów, opisuje lekcja jak działają wyszukiwarki AI. Dla piszącego wniosek jest prosty: strona może być dobra w całości i nie dać ani jednego zdania, które da się zacytować.
Pobranie strony i cytat to dwa różne zdarzenia. Według pomiaru AirOps większości stron, które ChatGPT pobiera do odpowiedzi, model nie cytuje wcale. Jeśli więc Twoja strona rankuje, a w odpowiedziach AI jej nie ma, problem często nie leży w pozycji, tylko w tym, że żaden akapit nie odpowiada na pytanie samodzielnie.
Które fragmenty ważą najwięcej
Najdokładniej sprawdzili to Zhang, He i Yao: 602 prompty, ponad 18 tysięcy pobranych stron, trzy platformy AI. Po wyrównaniu różnic między platformami i długością stron fragmenty w roli definicji były wykorzystywane o 32,5% częściej, porównania o 31,3%, a same liczby tylko o 5,6%. Najmniej waży strona, którą model podał jako ogólny odnośnik, bez wzięcia z niej konkretu. To preprint, a role fragmentów oceniał model językowy, więc liczby traktuj jako kierunek. Kierunek jest jednak czytelny: model sięga po zdanie, które coś definiuje albo rozstrzyga.
Jak wygląda cytat od środka
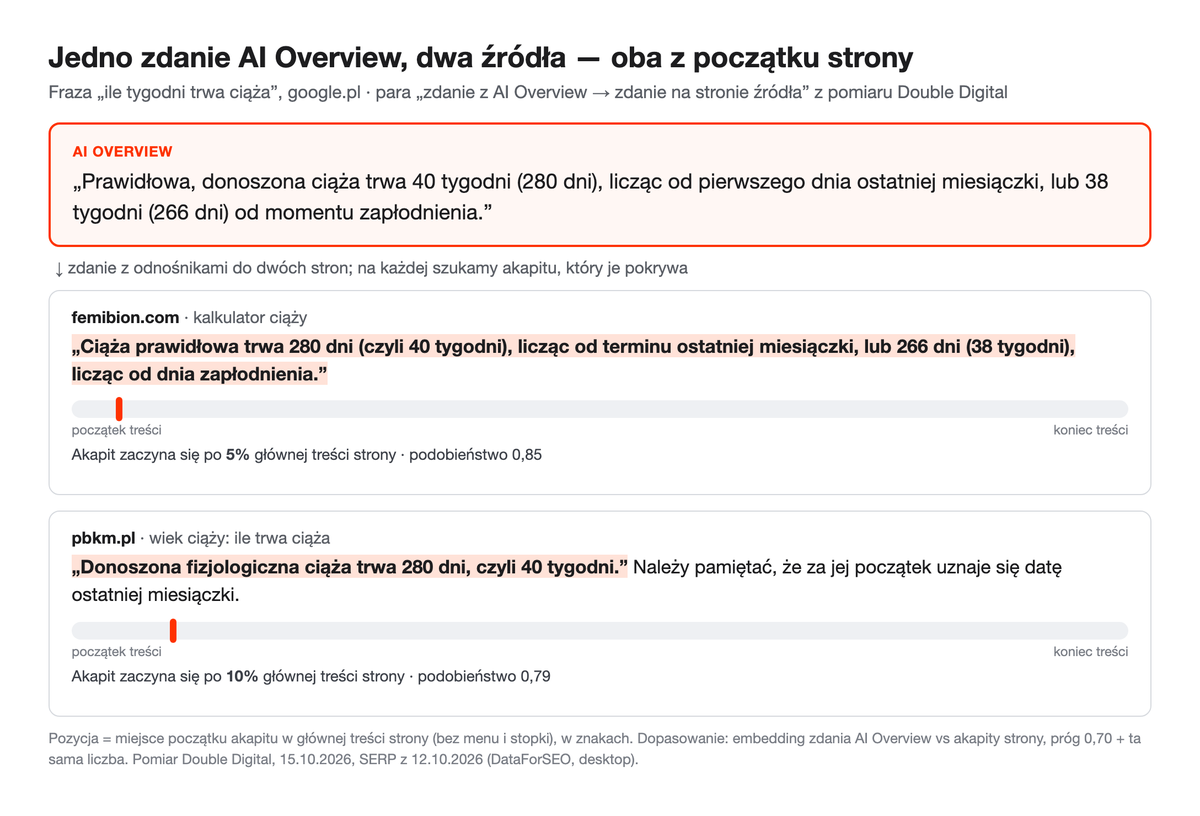
W naszym pomiarze polskich AI Overviews dla każdego zdania przeglądu szukaliśmy na cytowanych stronach akapitu, który je pokrywa. Najprostszy przykład to fraza „ile tygodni trwa ciąża”. Zdanie przeglądu o 40 tygodniach i 280 dniach miało odnośniki do dwóch stron. Na obu odpowiadający mu akapit stał na samym początku treści: po 5% i po 10% strony. Oba podają liczbę dosłownie, w pierwszym zdaniu akapitu, bez wstępu.
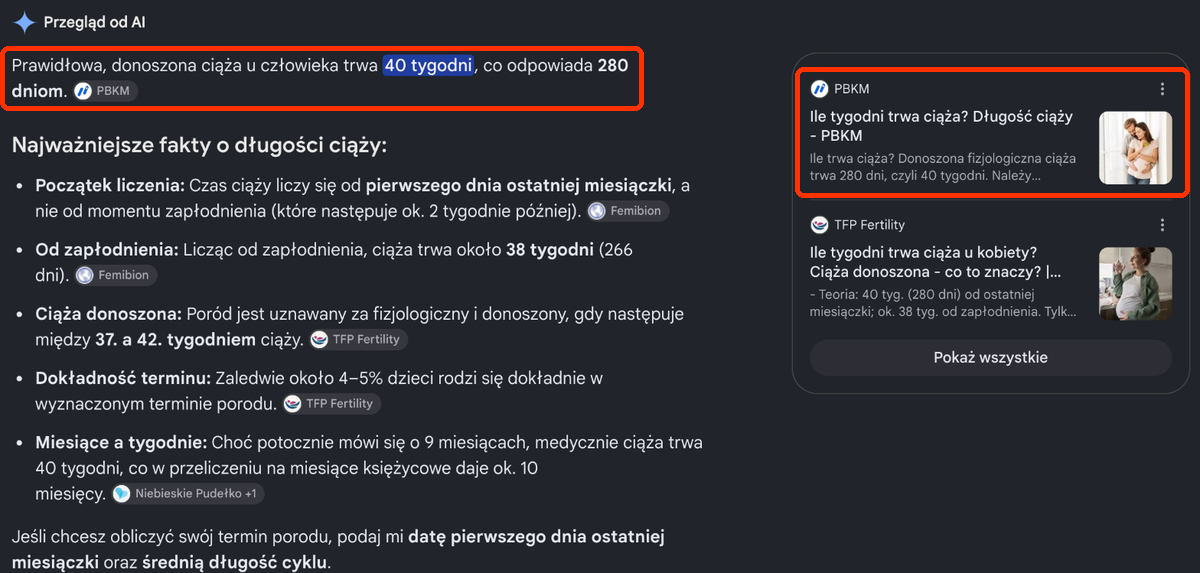
Trzy dni później ten sam przegląd w przeglądarce był sformułowany inaczej, ale pierwsze zdanie nadal opierało się na PBKM. Zmienia się brzmienie odpowiedzi, a źródło zdania z liczbą zostaje:
To samo dotyczy ChatGPT i Perplexity. Silniki różnią się tym, skąd biorą kandydatów (o tym w rozdziale AI Overviews i AI Mode), ale na końcu każdy z nich cytuje fragment. Nie potrzebujesz osobnej wersji tekstu „pod ChatGPT” i osobnej „pod Google”. Potrzebujesz akapitów, które odpowiadają na pytania klientów wprost i da się je zacytować bez reszty strony.
Wybierz jedną frazę ze swojej branży, na którą Google pokazuje przegląd od AI. Otwórz pierwsze cytowane źródło i znajdź na nim zdanie, z którego przegląd wziął informację. Zapisz trzy rzeczy: gdzie stoi na stronie (początek, środek, koniec), czy zawiera liczbę albo definicję i czy da się je zrozumieć bez poprzedniego akapitu. Potem znajdź na swojej stronie zdanie, które odpowiada na tę samą frazę, i porównaj je według tych samych trzech punktów.
Odpowiedź na początku: z której części strony AI Overviews biorą cytaty
Cytaty skupiają się na początku strony, ale nie wyłącznie tam. W polskich AI Overviews 40,5% cytowanych zdań pochodziło z pierwszych 30% treści, 39,3% ze środka i 20,3% z ostatnich 30%. Najmocniej wypada pierwsza dziesiąta część strony (19% cytatów), najsłabiej ostatnia (3,5%). Najważniejsze zdanie stawiaj więc wcześnie, i to zarówno na stronie, jak i w każdej sekcji. Reszta strony też jest cytowana: 60% cytatów pochodzi spoza pierwszych 30%.
Jak mierzyliśmy
Wzięliśmy wyniki Google pobrane 12 października 2026 r. dla 172 polskich fraz z 12 branż (DataForSEO, google.pl, desktop). Przegląd od AI pojawił się na 113 z nich. Każde zdanie przeglądu, które miało odnośnik, porównaliśmy z akapitami cytowanej strony za pomocą embeddingów, czyli liczbowego zapisu znaczenia tekstu. Za dopasowanie uznaliśmy akapit podobny co najmniej w 0,70, wyraźnie lepszy od drugiego kandydata i z tą samą liczbą, jeśli zdanie ją zawierało. Z 1 248 par „zdanie → strona” dopasowanie znalazło się dla 400, a pozycję liczyliśmy jako miejsce początku akapitu w głównej treści strony, bez menu i stopki.
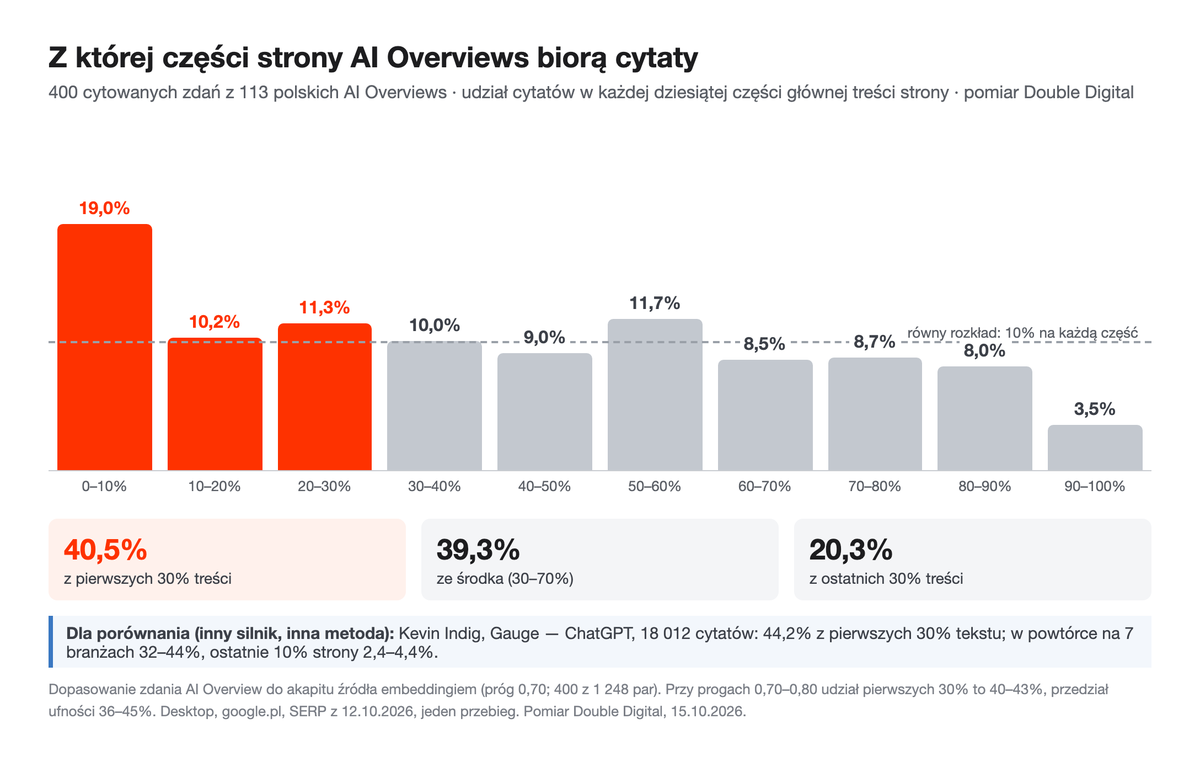
Wynik jest odporny na ustawienia. Przy ostrzejszych progach dopasowania (0,75 i 0,80) udział pierwszych 30% wynosi 43%, a przedział ufności przy progu 0,70 to 36–45%. Gdy każda strona liczy się jako jeden głos, wychodzi 42,9%. Między branżami rozrzut jest duży, od 24% w budowie i remontach do 59% w sporcie. Przy kilkudziesięciu cytatach na branżę nie wyciągaj z tego wniosków dla swojej branży.
Co mierzyli inni
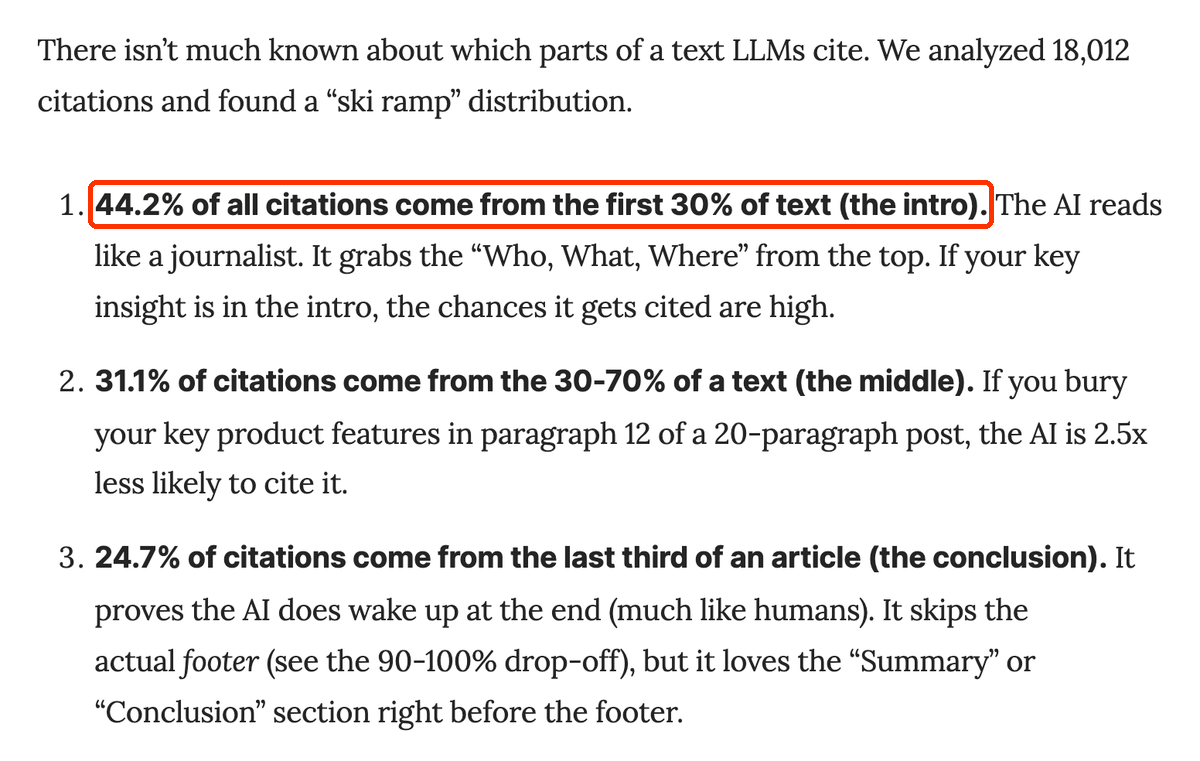
Najczęściej cytowany pomiar pozycji cytatu pochodzi od Kevina Indiga. Dotyczy ChatGPT i stron anglojęzycznych, a pozycję liczono w kodzie HTML, nie w samej treści:
| Kto mierzył | Silnik | Próba | Pierwsze 30% strony | Ostatnie 10% strony | Ocena |
|---|---|---|---|---|---|
| Kevin Indig, dane Gauge (II 2026) | ChatGPT | 18 012 cytatów | 44,2% | spadek przed stopką | pojedynczy pomiar, vendor |
| Kevin Indig, powtórka (III 2026) | ChatGPT | 7 branż | 32–44% zależnie od branży | 2,4–4,4% | pojedynczy pomiar, ten sam autor |
| Double Digital (X 2026) | AI Overviews, google.pl | 400 cytatów, 113 przeglądów | 40,5% (36–45%) | 3,5% | pojedynczy pomiar |
Inny silnik, inny język i inna metoda, a obraz podobny: szczyt na początku, płaski środek i wyraźny spadek w ostatniej dziesiątej części strony. Ten spadek na końcu to, naszym zdaniem, skutek tego, co zwykle tam stoi: odesłania, zachęty do kontaktu i powtórzenia, z których model nie ma czego wziąć. To interpretacja, nie wynik pomiaru. Nie powołuj się natomiast na liczbę „62% cytatów z pierwszych 50 słów”. Nie znaleźliśmy jej w żadnym źródle pierwotnym.
Wniosek praktyczny nie brzmi „wszystko na górę”. Zdanie, które odpowiada na główną frazę strony, powinno stać w pierwszym akapicie treści, a nie po wstępie o historii firmy. Każda sekcja powinna zaczynać się od własnej odpowiedzi, bo 60% cytatów pochodzi ze środka i końca strony, a model wyjmuje akapit bez tego, co stoi przed nim. Zakończenie artykułu też ma znaczenie, jeśli zawiera konkret, a nie tylko zachętę do kontaktu.
Weź 5 najważniejszych stron serwisu i dla każdej zapisz frazę, na którą ma odpowiadać. Znajdź zdanie, które na nią odpowiada, i sprawdź, ile akapitów stoi przed nim. Jeśli więcej niż dwa albo jeśli przed odpowiedzią jest wstęp o firmie, przesuń to zdanie na początek treści. Tę samą próbę zrób dla nagłówków H2: czy pierwsze zdanie pod każdym z nich odpowiada na pytanie z nagłówka?
Jak tworzyć treści pod AI: samodzielny akapit, nagłówek i liczby dosłownie
Akapit pod AI musi przejść test dwóch zdań: wyjęty ze strony bez zmian nadal odpowiada na pytanie. W naszym pomiarze cytowane akapity zawierały liczbę w 60,8% przypadków, a pozostałe akapity tych samych stron w 38,3%. Zdanie definicyjne typu „X to…” miało 25,2% cytowanych akapitów wobec 19,6% pozostałych. Nagłówek działa jak adres odpowiedzi: im lepiej pasuje do pytania, tym częściej strona jest cytowana.
Porównaliśmy 365 akapitów, z których polskie AI Overviews wzięły cytat, z 11 467 akapitami tych samych stron, których nie zacytowały. To ważne: porównujemy akapity z tej samej strony, więc różnica nie wynika z tego, że jedna strona jest lepsza od drugiej.
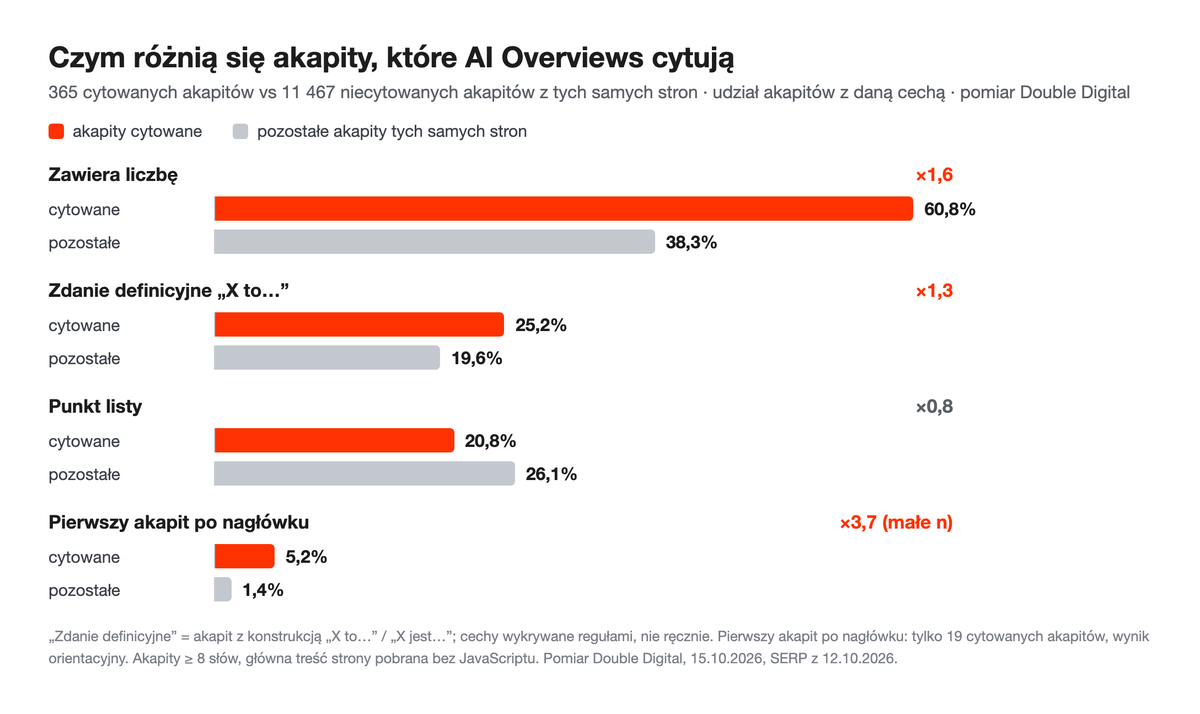
Liczba to najsilniejsza cecha: cytowany akapit zawiera ją 1,6 raza częściej niż reszta tekstu. Definicja daje mniej, ok. 1,3 raza. Pierwszy akapit po nagłówku był w cytowanych blokach prawie cztery razy częstszy, ale to tylko 19 akapitów, więc traktuj to jako sygnał, nie liczbę. Ciekawy jest wynik dla list: punkty listy były cytowane rzadziej niż zwykłe akapity (20,8% wobec 26,1%). Forma listy nie zastępuje treści. Lista pomaga czytelnikowi, ale model i tak szuka w niej zdania z konkretem.
Nagłówek jako adres odpowiedzi
AirOps sprawdził, jak dopasowanie nagłówka do zapytania wpływa na cytowanie w ChatGPT. Mierzył podobieństwo pytania do najlepiej pasującego nagłówka na stronie. Gdy porównał tylko strony z trzech najwyższych pozycji wyszukiwania, stopa cytowania rosła z 55,9% przy słabym dopasowaniu (podobieństwo poniżej 0,60) do 75,3% przy najlepszym (0,90 i więcej):
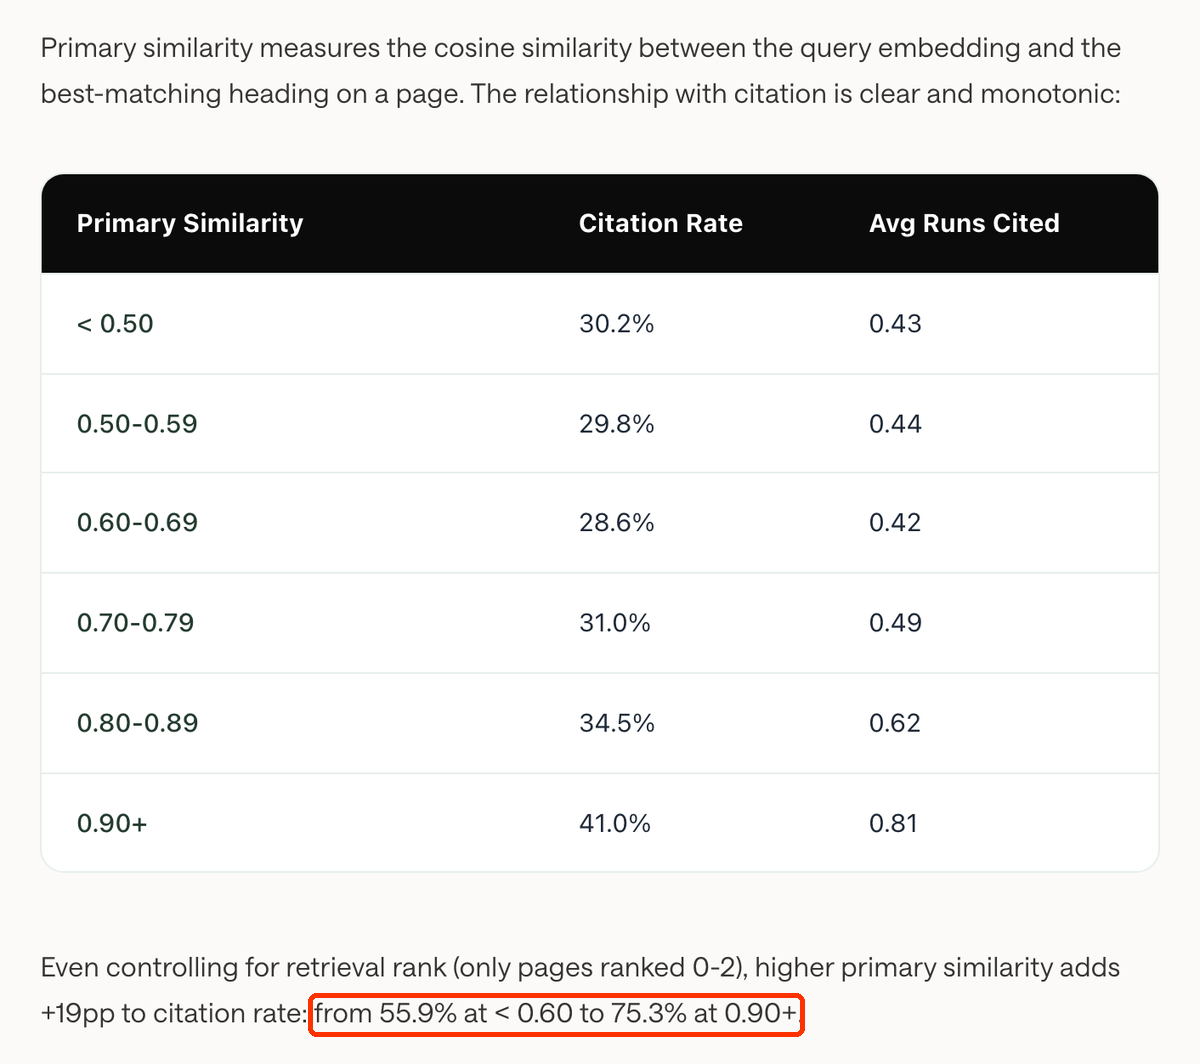
Dla piszącego to znaczy: nagłówek „Nasze podejście” niczego nie adresuje, a nagłówek „Ile kosztuje audyt SEO sklepu” trafia w pytanie klienta. Nie chodzi o upychanie fraz, tylko o to, żeby z nagłówka było jasne, na jakie pytanie odpowiada sekcja.
Liczby i nazwy pisz dosłownie i w jednej wersji w całym serwisie. Część systemów wyszukiwania dopasowuje fragmenty nie tylko po znaczeniu, ale też po słowach (np. algorytm BM25). Jeśli na jednej stronie piszesz „czas realizacji 14 dni”, na drugiej „dwa tygodnie”, a na trzeciej „do pół miesiąca”, model dostaje trzy różne odpowiedzi i może nie wziąć żadnej. Liczby z wykresów i infografik powtórz w tekście, bo obraz to dla wyszukiwarki pusty fragment.
Krok 1: odpowiedź w pierwszym zdaniu pod nagłówkiem
Pierwsze zdanie sekcji odpowiada na pytanie z nagłówka. Wstęp, kontekst i zastrzeżenia idą dalej. Jeśli nagłówek brzmi „Ile trwa wdrożenie sklepu”, pierwsze zdanie podaje liczbę tygodni, a nie opis tego, jak ważne jest dobre planowanie.
Krok 2: akapit bez odesłań
Wytnij z akapitu wszystko, co wymaga czytania poprzedniego: „jak wspomnieliśmy”, „ten proces”, „wspomniana wyżej metoda”, zaimki bez podmiotu. Każdy akapit nazywa rzecz, o której mówi. To wydłuża tekst o kilka słów, a model dostaje fragment, który ma sens bez reszty strony.
Krok 3: liczba z jednostką i źródłem w jednym zdaniu
Liczba, jednostka, okres i źródło stoją w tym samym zdaniu. „Wzrost o 40%” bez podstawy jest dla modelu bezużyteczny. „Ruch z Google wzrósł o 40% w pół roku (Search Console, I–VI 2026)” można zacytować bez kontekstu.
Przed i po: akapit z naszej strony
Tak mógłby wyglądać akapit o pozycji cytatów, napisany w typowym stylu poradnika:
Jak wspomnieliśmy wcześniej, bardzo ważne jest, aby kluczowe informacje pojawiały się w tekście odpowiednio wcześnie. Sztuczna inteligencja zwraca na to szczególną uwagę, dlatego warto o tym pamiętać przy tworzeniu treści.
Ten akapit nie przejdzie testu dwóch zdań: zaczyna się od odesłania, nie ma liczby ani źródła, a „to” nie wiadomo do czego się odnosi. Ta sama myśl po przeróbce:
W polskich AI Overviews 40,5% cytowanych zdań pochodzi z pierwszych 30% treści strony, a tylko 3,5% z ostatniej dziesiątej części (pomiar Double Digital, 400 cytatów, październik 2026). Zdanie, które odpowiada na główną frazę strony, powinno więc stać w pierwszym akapicie treści.
Druga wersja ma liczbę, źródło, okres i wniosek. Wyjęta ze strony nadal odpowiada na pytanie „z której części strony AI bierze cytaty”. Szerzej o tym, jak redagować tekst z pomocą AI i nie zgubić przy tym jakości, piszemy w lekcji treści SEO.
Weź stronę usługi, na której zależy Ci najbardziej. Skopiuj losowe trzy akapity do osobnego dokumentu i przeczytaj je bez reszty strony. Przy każdym zapisz: czy wiadomo, o czym jest, czy zawiera liczbę albo definicję i czy pierwsze zdanie coś rozstrzyga. Akapit, który nie przechodzi żadnego z trzech punktów, popraw krokami 1–3 albo usuń.
Co jest nieodtwarzalne: dane, których model nie ma skąd wziąć
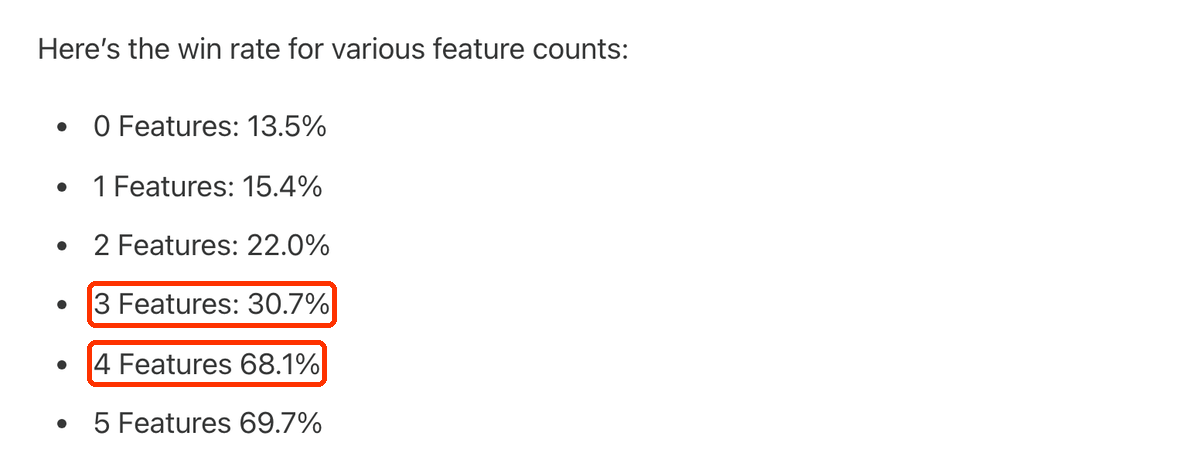
Model sięga po źródło po to, czego nie wygeneruje z parafrazy internetu: własną liczbę, nazwany kompromis, błąd z praktyki, narzędzie, które kończy zadanie. Po stronie Google widać ten sam kierunek. W analizie Zyppy serwisy z czterema cechami „zwycięzców” zyskiwały w aktualizacjach w 68,1% przypadków, a z trzema w 30,7%. Dokumentacja Google od 1 października 2026 r. wymienia oryginalność i wkład pracy wśród cech, które oceniają testerzy jakości.
Cyrus Shepard z Zyppy porównał serwisy, które zyskały i straciły w aktualizacjach Google. Zwycięzców wyróżniało pięć cech: własny produkt lub usługa, możliwość załatwienia sprawy na stronie (kalkulator, narzędzie, formularz), zasoby własne (zdjęcia, dane, badania), wąska specjalizacja i rozpoznawalna marka. Pojedyncza cecha niewiele zmieniała. Duży skok następował dopiero przy czterech:
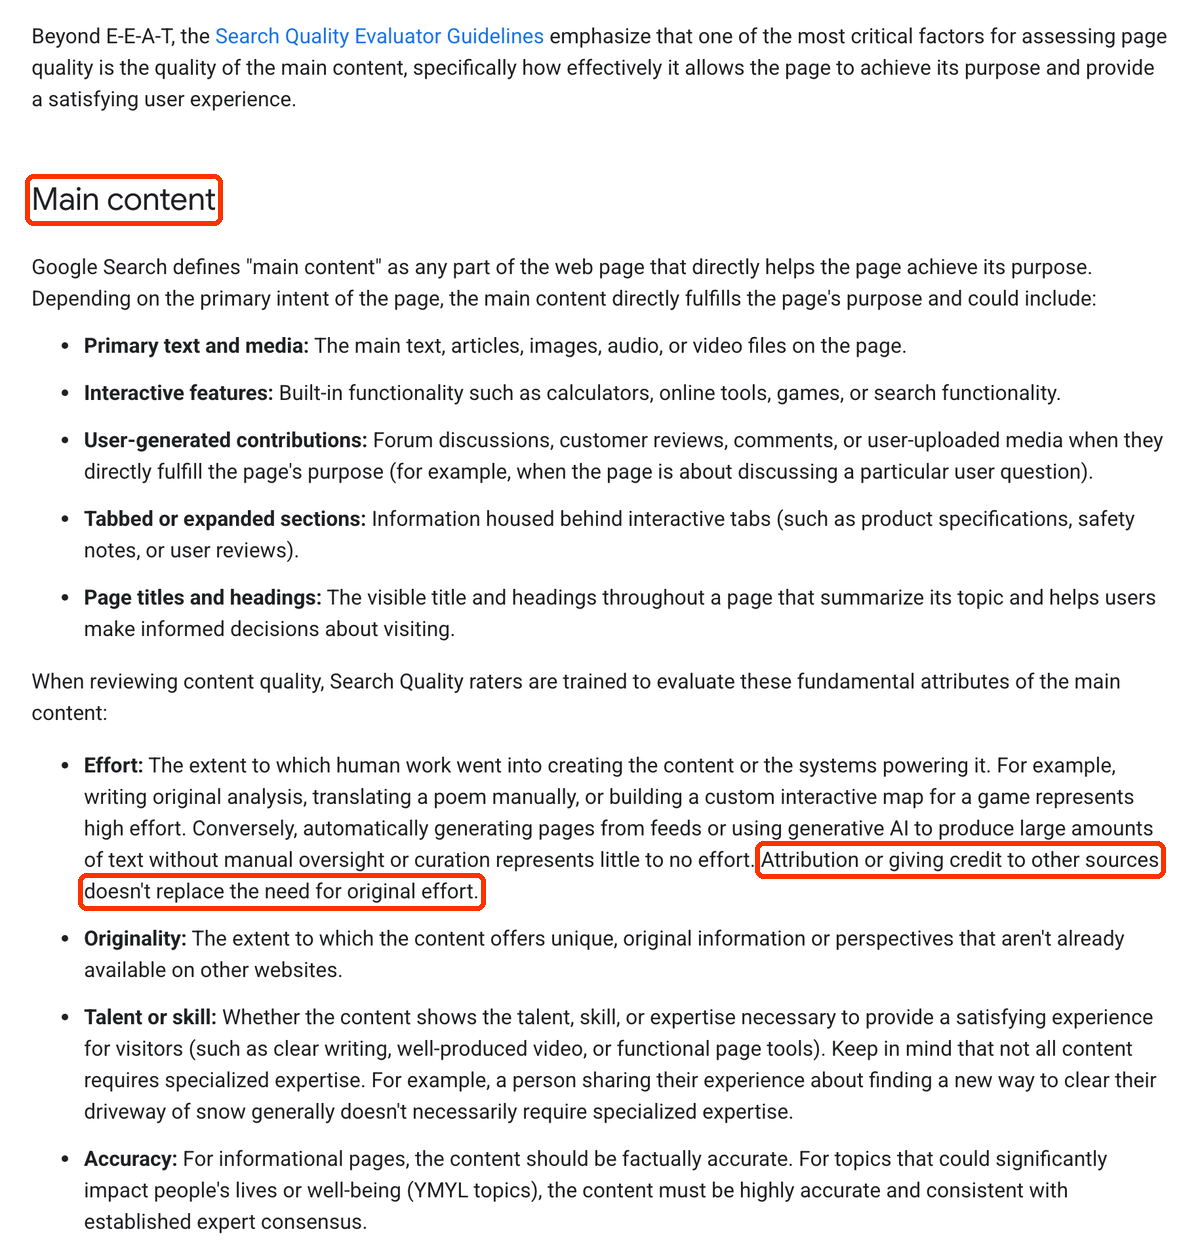
Google opisał to samo od strony ocen jakości. W dokumentacji z 1 października 2026 r. „główna treść” to każda część strony, która bezpośrednio pomaga jej zrealizować cel, także kalkulator czy zakładka ze specyfikacją. Testerzy oceniają w niej wkład pracy, oryginalność, umiejętności i poprawność. Jedno zdanie warto zapamiętać: przypisanie źródeł nie zastępuje własnego wysiłku. Strona złożona z cudzych liczb, nawet uczciwie podpisanych, nie jest przez to oryginalna.
Pięć rodzajów treści, których model nie odtworzy
| Rodzaj | Firma usługowa | Sklep | Jak sprawdzić |
|---|---|---|---|
| Własna liczba | średni czas realizacji z ostatnich 50 zleceń | odsetek zwrotów danego modelu, najczęstszy powód | czy ta liczba jest gdziekolwiek poza Twoją stroną? |
| Nazwany kompromis | kiedy nie polecasz swojej usługi i co wtedy zamiast niej | dla kogo produkt się nie nadaje | czy tekst mówi komuś „nie”? |
| Błąd z praktyki | trzy najczęstsze błędy klientów przed zleceniem | jak klienci źle dobierają rozmiar lub moc | czy opis wymagał kogoś, kto to widział? |
| Narzędzie, które kończy zadanie | kalkulator kosztu, lista kontrolna do pobrania | dobór rozmiaru, porównywarka wariantów | czy klient może coś załatwić bez telefonu? |
| Zasób własny | zdjęcia z realizacji, przykładowy raport | własne zdjęcia produktu w użyciu, test | czy zdjęcie lub plik jest tylko u Ciebie? |
Przykład z naszego podwórka to raport AI SEO i pomiary w tej akademii. Liczby o polskich AI Overviews, które czytasz w tym rozdziale, nie istniały, zanim je policzyliśmy. Każdy model, który chce odpowiedzieć na pytanie o polskie AI Overviews z liczbą, musi wziąć je ze źródła.
Jest też napięcie, o którym trzeba powiedzieć. W symulacji RAG model wyraźnie chętniej cytował tekst, który był przeróbką jego własnej odpowiedzi, niż oryginały pisane przez ludzi czy przez inne AI (szczegóły w części o tym, czy Google karze za treści AI). Treść nieodtwarzalna pomaga wejść do odpowiedzi, ale nie chroni przed konkurencją tekstów pisanych „w stylu modelu”. Przewagę daje dopiero połączenie obu rzeczy: własne dane podane w akapicie, który model łatwo wyjmie.
Jeśli chcesz, żeby ktoś zbudował taką treść za Ciebie, od pomiaru po tekst, zobacz content SEO, czyli treści, które AI może zacytować.
Otwórz najważniejszą stronę usługi albo kategorii i zadaj sobie pytanie: co z niej zniknęłoby, gdyby przepisał ją model językowy na podstawie pięciu stron konkurencji? Zaznacz zdania, które by zostały, bo tylko Ty je znasz: liczby, przypadki, ceny, warunki, zdjęcia. Jeśli nie ma ani jednego, dopisz co najmniej jedną własną liczbę i jeden nazwany kompromis z tabeli wyżej.
Mity o formie: 40–60 słów, „krótsze wygrywa”, 7–20 nagłówków
Żadna z tych liczb nie ma pokrycia w danych. W naszym pomiarze tylko 25,8% cytatów polskich AI Overviews pochodziło z akapitów o długości 40–60 słów, a połowa z krótszych. Zalecenie „7–20 podnagłówków” stoi w podsumowaniu raportu AirOps, choć jego własne dane dają artykułom 4–10. Liczby „61% deklaratywne vs 37% narracyjne” autorzy wycofali.
Najpopularniejszy przepis to akapit 40–60 słów. Pochodzi z czasów fragmentów z odpowiedzią w Google (featured snippets), a nie z pomiaru cytatów AI. Sprawdziliśmy go na 400 cytatach:
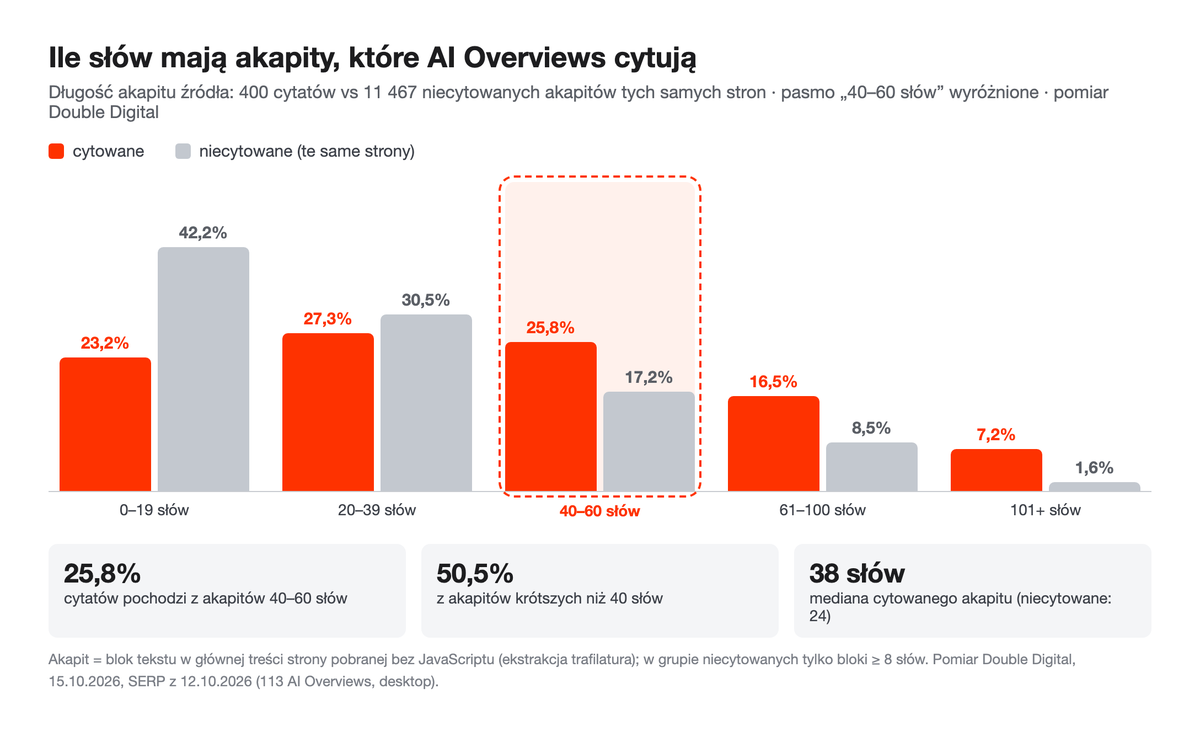
Wynik ma dwie strony. Pasmo 40–60 słów nie jest magiczne: trzy czwarte cytatów pochodzi z akapitów krótszych lub dłuższych, a mediana to 38 słów. Cytowane akapity są jednak wyraźnie dłuższe niż przeciętny akapit tych samych stron (mediana 38 wobec 24 słów). Model rzadko bierze jednozdaniowe wtrącenia i podpisy. Bezpieczna reguła brzmi więc: jedna myśl z dowodem na akapit, tyle słów, ile trzeba, żeby akapit był samodzielny. Nie tnij tekstu na krótkie kawałki pod licznik.
Tabela mitów
| Liczba | Skąd krąży | Co mówi źródło | Werdykt | Czego używać zamiast |
|---|---|---|---|---|
| akapit 40–60 słów | reguła z featured snippets, kursy i e-booki | brak pomiaru na cytatach AI; w AIO PL 25,8% cytatów z takich akapitów | sporne | test dwóch zdań |
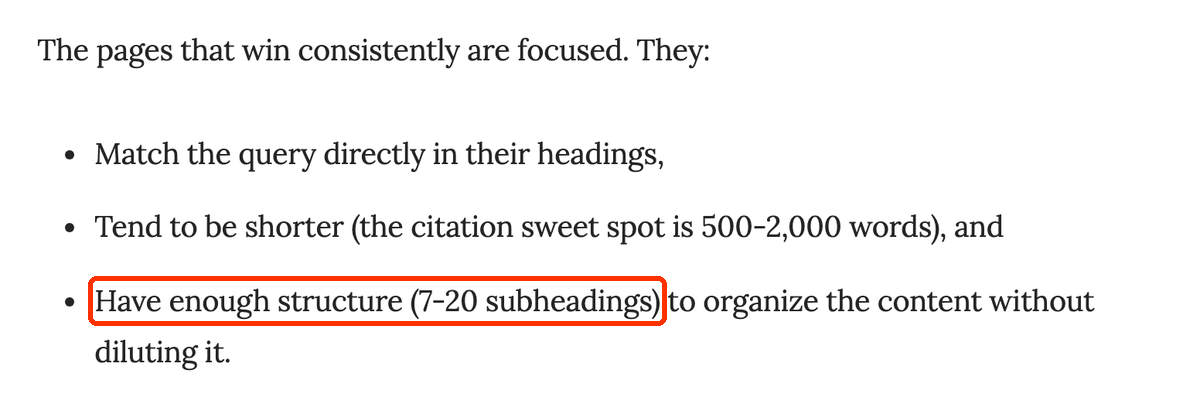
| „7–20 podnagłówków” | raport AirOps „The Fan-Out Effect” i przedruk w SEJ (IV 2026) | dane raportu: artykuły najlepiej przy 4–10, strony produktowe przy zero | obalone | nagłówek na każde osobne pytanie |
| „krótsze treści wygrywają” | ten sam raport | 5,7 pp różnicy między kubełkami długości; strony cytowane zawsze i nigdy mają te same ok. 2 200 słów | sporne | długość wynika z liczby pytań, na które strona odpowiada |
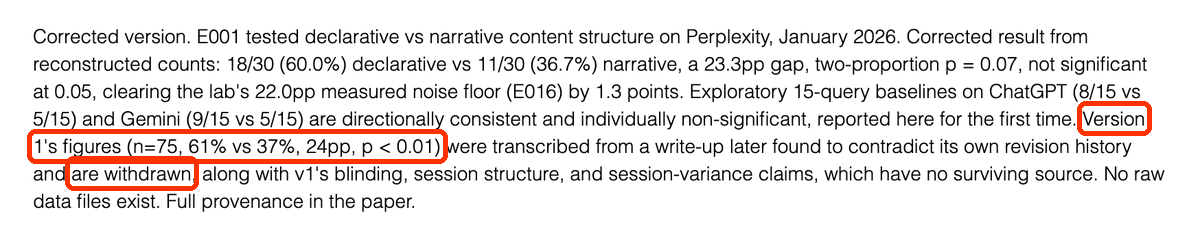
| „61% deklaratywne vs 37% narracyjne” | GEO Lab, eksperyment E001 (v1) | autor wycofał liczby; v2: 60,0% vs 36,7%, wynik nieistotny statystycznie | obalone | nic: brak dowodu w żadną stronę |
| „akapit 100–300 tokenów”, „chunk 100–500 tokenów” | webinary i poradniki o chunkingu | domyślny fragment w Vertex AI RAG Engine Google to 1 024 tokeny; nie wiadomo, czy wyszukiwarka używa tego ustawienia | obalone | test dwóch zdań |
| „62% cytatów z pierwszych 50 słów” | obieg branżowy: poradniki i streszczenia badań | nie występuje w żadnym znanym nam źródle pierwotnym | obalone | 40,5% z pierwszych 30% strony (AIO PL) |
Dwie z tych liczb warto zobaczyć u źródła. Wycofanie „61% vs 37%” stoi w opisie poprawionej wersji pracy:
A „7–20 podnagłówków” trafiło do przedruku w Search Engine Journal z podsumowania raportu, choć dane w tym samym raporcie mówią co innego:
FAQ i statystyki: efekt mały i niepewny
Sekcja FAQ ma opinię „formatu pod AI”. AirOps pokazuje dla niej wzrost o 40%, ale to pomiar vendora na stronach już pobranych. U Zhang i in. strony z pytaniami i odpowiedziami wypadają lepiej w obrębie każdej platformy, a w benchmarku E-GEO efekt to ułamek pozycji. FAQ warto mieć, jeśli odpowiada na prawdziwe pytania klientów. Nie warto dopisywać go jako ozdobnika. Co po wycofaniu rozszerzonych wyników FAQ daje sam znacznik FAQPage, opisujemy w rozdziale o danych strukturalnych i encji marki.
Podobnie jest z dosypywaniem statystyk. Liczba w akapicie pomaga, co widać w naszym pomiarze, ale to musi być liczba potrzebna do odpowiedzi, a nie wstawka „według badań 73% firm…”. W dwóch pomiarach dopisywanie statystyk nie dało efektu, w jednym dało. Liczy się to, czy strona zawiera fakty, których potrzebuje odpowiedź, a nie liczba liczb na stronie.
Długość całej strony też nie jest przepisem. Wśród stron już cytowanych dłuższe przewodniki obsługują więcej różnych promptów, ale to nie znaczy, że długi tekst ma większą szansę na cytat w pojedynczym pytaniu. O pliku llms.txt, kolejnym „formacie pod AI”, piszemy w rozdziale boty AI, robots.txt i llms.txt: nie ma dowodu, że poprawia cytowanie w którymkolwiek z dużych silników.
Przejrzyj wytyczne dla copywriterów, z których korzystasz (brief, checklistę, szablon w CMS). Zaznacz każdą liczbę dotyczącą formy: długość akapitu, liczbę nagłówków, długość tekstu, liczbę statystyk. Przy każdej sprawdź w tabeli wyżej, czy ma pokrycie. Liczby „obalone” zastąp regułą z ostatniej kolumny, a przy „spornych” dopisz, że to orientacja, nie wymóg.
Jak być cytowanym przez ChatGPT bez przepisywania całej strony
Stałe przepisy GEO, czyli ton autorytatywny, „styl pod AI” czy dopisane statystyki, nie przenoszą się na mocne modele, a samo przepisanie tekstu może obniżyć obecność strony w wynikach. W benchmarku C-SEO Bench przepisanie treści dało istotną poprawę tylko w 3 z 54 układów. W SAGEO Arena przepisanie samego tekstu obniżyło obecność w wynikach wyszukiwania o 9%, w pierwszej dziesiątce po ponownym rankingu o 16%, a cytowania o 6%. Zamiast przepisywać, dopisz brakującą odpowiedź, liczbę albo definicję tam, gdzie ich brakuje.
Moda na przepisywanie stron „pod AI” wzięła się z pracy Princeton z 2024 r. Pokazała ona, że dodanie cytatów i statystyk podnosi widoczność tekstu w odpowiedzi modelu o kilkadziesiąt procent. Test odbywał się jednak w silniku badawczym na starszym modelu, a przykłady zmian zawierały wymyślone źródła i liczby. Nowsze benchmarki, które sprawdzają te same zabiegi na mocniejszych modelach, dają znacznie słabszy obraz:
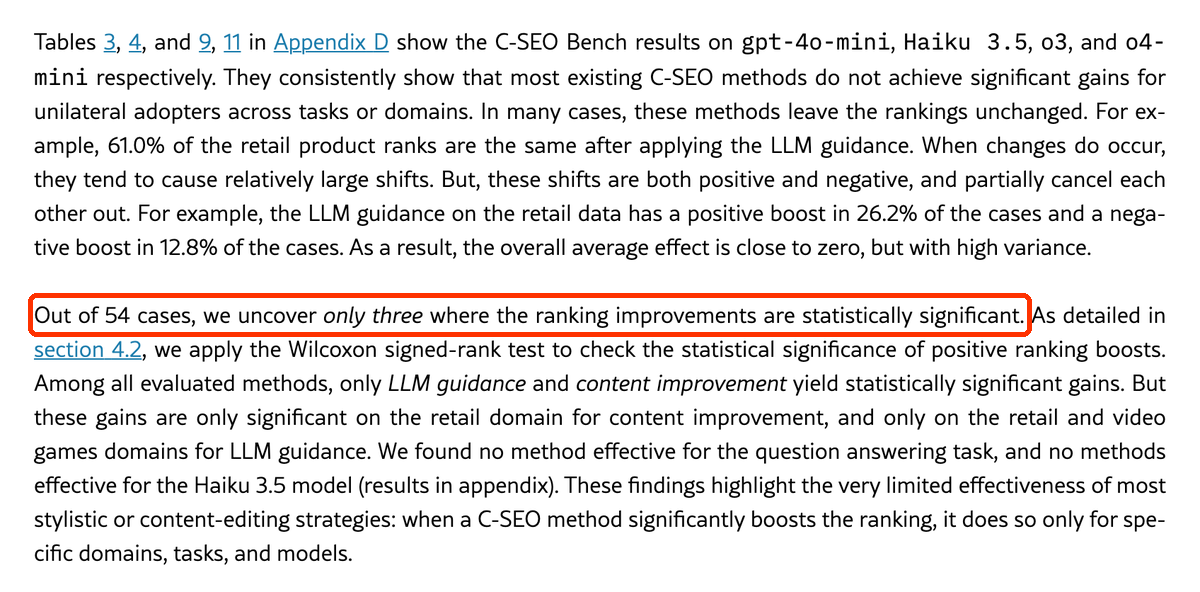
C-SEO Bench sprawdził metody przepisywania na czterech modelach i sześciu dziedzinach. Zmiany zwykle niczego nie ruszały, a gdy ruszały, to w obie strony i średnio blisko zera. Istotne zyski pojawiły się w trzech przypadkach, wszystkie w rekomendacjach produktów i tylko dla jednego modelu. W benchmarku E-GEO, opartym na rankingu produktów, na GPT-5 wszystkie 15 sprawdzonych heurystyk obniżało pozycję, a najbardziej ton autorytatywny.
Najważniejszy jest wynik SAGEO Arena, bo ten benchmark mierzy cały lejek: wyszukiwanie kandydatów, ponowny ranking i generowanie odpowiedzi. Przepisanie samego tekstu strony obniżało obecność na każdym etapie:
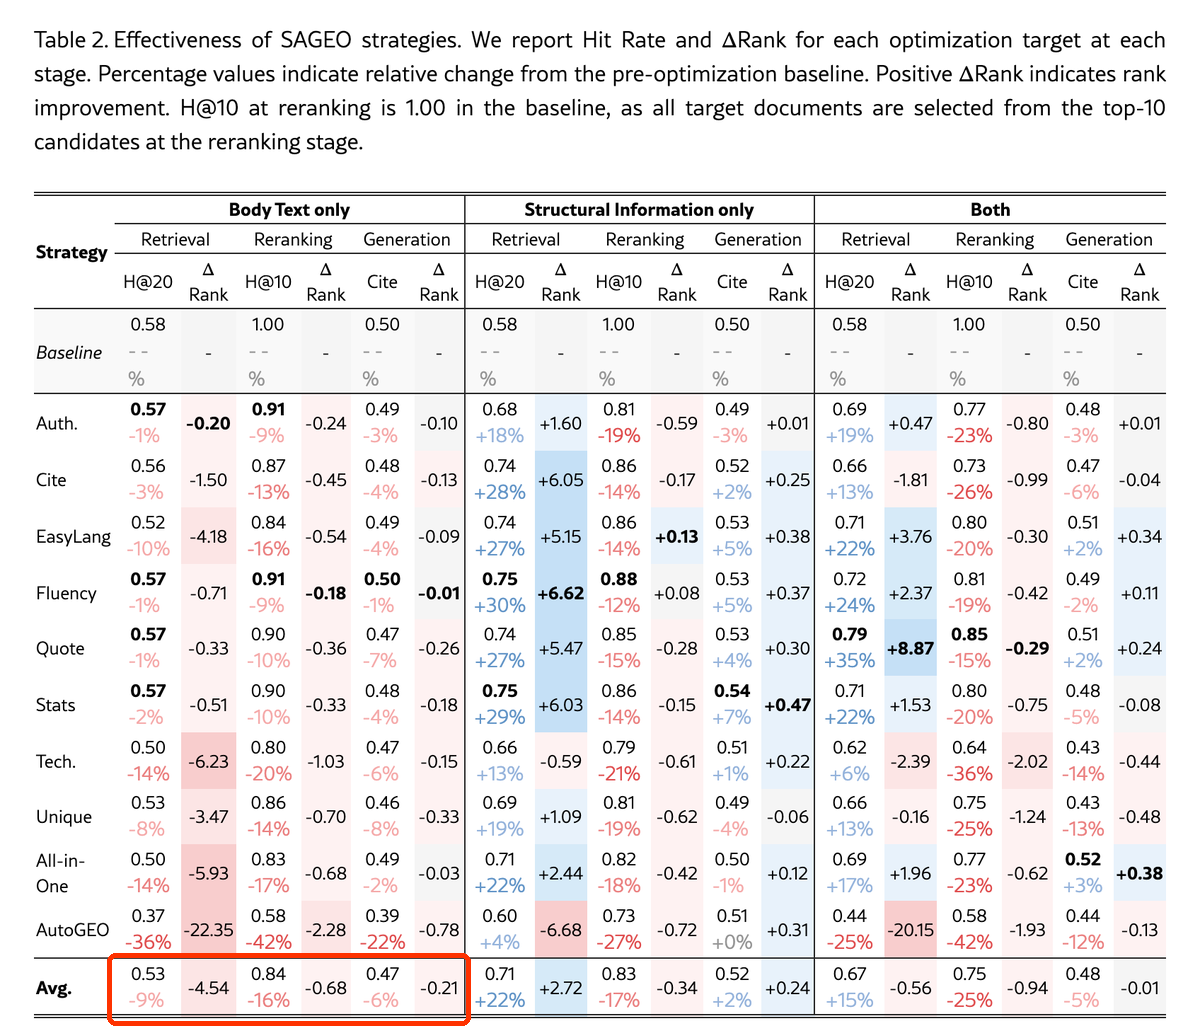
Ta sama tabela pokazuje coś jeszcze. Optymalizacja samej struktury, czyli tytułu, opisu meta, nagłówków i danych strukturalnych, bez ruszania tekstu podnosiła obecność w wynikach wyszukiwania średnio o 22%, ale na etapie ponownego rankingu traciła 17%. Wniosek: przepisanie słownictwa, którym strona dziś rankuje, to realne ryzyko. Dopisanie tego, czego brakuje, jest ryzykiem dużo mniejszym. To już nasza rekomendacja z praktyki, a nie wynik benchmarku.
Kiedy poprawiać, a kiedy nie ruszać
Poprawiaj stronę, gdy nie ma na niej zdania, które odpowiada na frazę, gdy ważna liczba siedzi tylko w grafice albo w treści ładowanej JavaScriptem, albo gdy akapity zaczynają się od odesłań. Nie przepisuj strony, która ma kliknięcia z Google. Taką stronę możesz uzupełnić o akapit-odpowiedź, ale jej obecny tekst zostaw. Jedna z platform do optymalizacji pod AI robi tak samo: strony z ruchem z Google wyłącza z przepisywania w ogóle.
Procedura „dopisz, nie przepisuj”
- Zapisz punkt wyjścia. Pozycje i kliknięcia strony z Search Console z ostatnich 28 dni oraz listę 5–10 pytań, na które strona ma odpowiadać, z informacją, czy dziś jest cytowana w AI.
- Znajdź luki. Przy każdym pytaniu sprawdź, czy na stronie jest zdanie, które na nie odpowiada i przechodzi test dwóch zdań. Brak takiego zdania to luka.
- Dopisz akapity-odpowiedzi. Na początku strony albo na początku pasującej sekcji, z liczbą i źródłem. Nie zmieniaj nagłówków i zdań, które już rankują.
- Zmierz po 4 i 8 tygodniach. Te same pozycje i kliknięcia oraz te same pytania w AI. Jeśli pozycje spadły, wycofaj zmianę.
Jeśli nie masz czasu prowadzić tego samodzielnie na kilkudziesięciu stronach, robimy to w ramach usługi SEO pod AI.
Zanim zlecisz „optymalizację treści pod AI”, poproś wykonawcę o listę zmian dla jednej strony. Sprawdź, ile z nich to dopisanie brakującej odpowiedzi, a ile przeformułowanie istniejącego tekstu. Jeśli przeważa przeformułowanie, a strona ma ruch z Google, poproś o wersję „dopisz, nie przepisuj” i o pomiar przed i po.
Czy Google karze za treści AI
Nie za samo użycie AI. Według Ahrefs 5,3% stron z pierwszych trzech pozycji w Google to tekst w 100% wygenerowany przez AI. W symulacji RAG oryginały napisane przez AI były cytowane w 9,4% przypadków, a napisane przez ludzi w 7,4%. Spadki przypisywane „AI slop” dotyczą serwisów, które masowo produkowały strony z jednego szablonu bez wartości dodanej. AI było w nich narzędziem, a nie przyczyną.
Ahrefs przebadał strony z pierwszej dziesiątki wyników dla 100 tysięcy zapytań (czerwiec 2026). Większość stron w czołówce to tekst w przewadze ludzki, ale strony w całości wygenerowane przez AI też tam są:
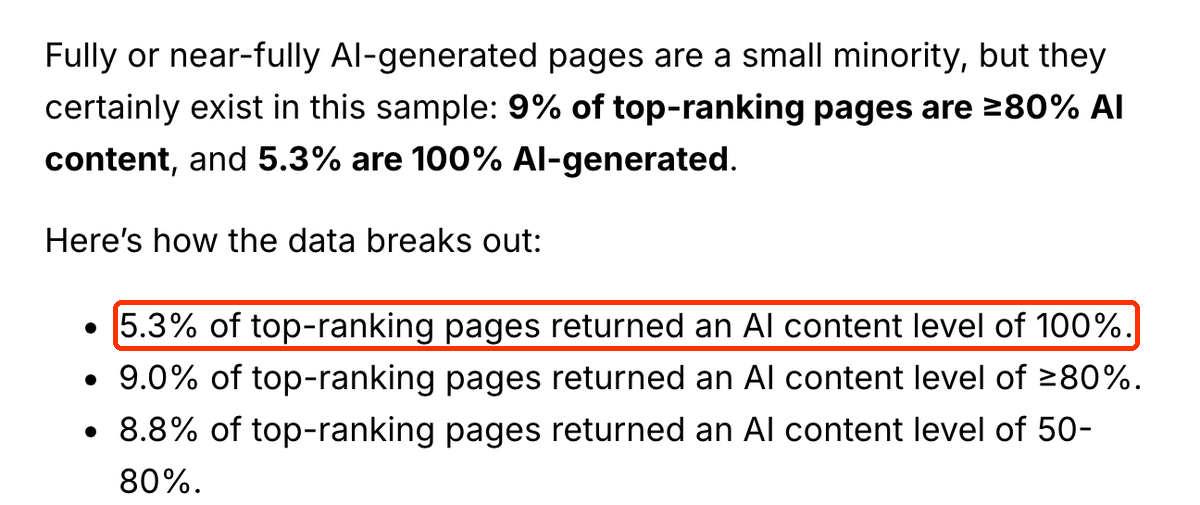
Udział stron w co najmniej 80% napisanych przez AI rośnie łagodnie od pozycji 1 do 10 (z 8,4% do 11,7%). To gradient, a nie próg, za którym zaczyna się kara. Podobnie wygląda to w odpowiedziach AI. W symulacji RAG tekst napisany przez AI nie był cytowany rzadziej niż ludzki, a w analizie regresji autorstwo nie miało osobnego efektu:
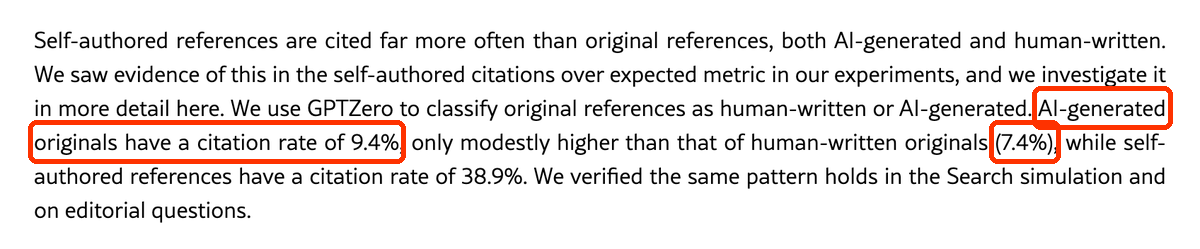
Ta sama symulacja pokazała jednak coś ważniejszego: model cytował 38,9% tekstów będących przeróbką jego własnej odpowiedzi. W tej symulacji odpowiedzi z kolejnymi rundami zbiegały do jednej wersji, a słabo widoczne firmy i pojęcia z nich wypadały. Tekst „w stylu modelu” łatwo wchodzi do odpowiedzi, ale niczym się w niej nie wyróżnia. Dlatego treść nieodtwarzalna z poprzednich lekcji ma większe znaczenie niż pytanie, kto napisał tekst.
Co naprawdę spada
Lily Ray przeanalizowała ponad 220 serwisów korzystających z platform do produkcji treści przez AI. 54% z nich straciło co najmniej 30% ruchu od szczytu. Wspólny mianownik to nie AI, tylko osiem powtarzalnych szablonów produkowanych hurtowo:
- porównania „X vs Y”,
- glosariusze i słowniki pojęć,
- rankingi „najlepsze X”,
- listy, na których firma promuje samą siebie,
- strony „alternatywy dla X”,
- strony lokalne różniące się tylko nazwą miasta,
- farmy FAQ,
- treści niezwiązane z tematem serwisu.
Glenn Gabe opisał cztery przypadki ze spam update z sierpnia 2026 r.: od stron programmatic z fragmentami AI po serwis afiliacyjny, który stracił większość widoczności. W każdym przypadku chodziło o skalę i brak wartości dodanej. Oba zbiory dobrano pod tezę i nie mają grupy kontrolnej, więc pokazują ryzyko, a nie jego wielkość.
Co się zmieniło 1 października 2026 r.
Google dopisał do dokumentacji sekcję o głównej treści i cztery cechy, które oceniają testerzy jakości: wkład pracy, oryginalność, umiejętności i poprawność (zrzut w części o treści nieodtwarzalnej). Jako przykład niskiego wysiłku dokumentacja podaje tekst wygenerowany przez AI w dużej ilości bez nadzoru i redakcji. To opis kryteriów oceny, a nie nowy filtr. Nie mów więc, że „Google wykrywa AI” ani że doszły „cztery nowe czynniki rankingowe”, bo dokumentacja tego nie mówi.
Z tego samego powodu „humanizowanie” tekstu pod detektor AI nic nie daje. Detektor mierzy styl, czyli to, czy tekst brzmi jak model. Google i testerzy oceniają wysiłek i oryginalność, czyli to, czy tekst zawiera coś, czego nie ma gdzie indziej. Przeredagowany pod detektor tekst bez własnych danych nadal jest tekstem bez własnych danych. Jak pracować z AI przy pisaniu tak, żeby to nie był problem, opisujemy w lekcji treści SEO, a szerszy kontekst w lekcji SEO w erze AI.
Policz, ile stron Twojego serwisu powstało z jednego szablonu: strony miast, porównania, hasła słownika, „najlepsze X”. Weź pięć losowych stron z największej grupy i przy każdej zapisz, co daje czytelnikowi poza podmienioną nazwą. Jeśli odpowiedź brzmi „nic”, ta grupa jest Twoim największym ryzykiem, niezależnie od tego, czy teksty pisał człowiek, czy AI.
FAQ — najczęściej zadawane pytania o treści pod AI
- Ile słów powinien mieć akapit pod AI?
Tyle, ile potrzeba, żeby akapit był zrozumiały bez reszty strony. Nie ma dowodu na żadną stałą długość. W naszym pomiarze polskich AI Overviews tylko co czwarty cytat (25,8%) pochodził z akapitu o długości 40–60 słów, a mediana cytowanego akapitu wyniosła 38 słów. Cytowane akapity były jednak dłuższe niż przeciętny akapit tych samych stron, więc nie dziel tekstu na jednozdaniowe kawałki.
- Czy sekcja FAQ pomaga w cytowaniu przez AI?
Trochę, ale efekt jest mały i niepewny. Pomiar vendora AirOps pokazuje wzrost, a benchmarki badawcze dają efekt bliski zera. FAQ ma sens, gdy odpowiada na pytania, które klienci naprawdę zadają, i gdy każda odpowiedź zaczyna się od konkretu. Dopisywanie FAQ wyłącznie „pod AI” nie jest dobrą inwestycją.
- Jak pisać teksty z AI, żeby nie zaszkodzić stronie?
Używaj AI do pracy nad tekstem, ale treść merytoryczną dostarczaj sam: własne liczby, przykłady, ceny, warunki, błędy z praktyki. Nie publikuj hurtowo stron z jednego szablonu, które różnią się tylko nazwą miasta albo produktu. Każdą stronę przed publikacją sprawdź pytaniem: co tu jest, czego nie ma u konkurencji? Proces redakcji z AI opisujemy w lekcji treści SEO.
- Czy Google wykrywa teksty pisane przez AI?
Nie ma dowodu, że Google obniża pozycję strony za samo użycie AI, a dokumentacja nie opisuje żadnego detektora tekstu AI w wyszukiwarce. Według Ahrefs 5,3% stron w top 3 to tekst w całości wygenerowany przez AI. Dokumentacja Google z 1 października 2026 r. ocenia wysiłek i oryginalność treści, a tekst AI produkowany masowo bez redakcji podaje jako przykład niskiego wysiłku. Problemem jest więc masowa produkcja bez wartości, a nie narzędzie.
Treść pod AI w ośmiu zdaniach
- 01AI cytuje fragment: zdanie z liczbą, definicję, porównanie — nie całą stronę.
- 02W polskich AI Overviews 40,5% cytatów pochodzi z pierwszych 30% treści strony, ale 60% spoza nich.
- 03Akapit musi przejść test dwóch zdań: wyjęty ze strony nadal odpowiada na pytanie.
- 04Cytowane akapity zawierają liczbę w 61% przypadków, pozostałe akapity tych samych stron w 38%.
- 05Nagłówek to adres odpowiedzi: im lepiej pasuje do pytania, tym częściej strona jest cytowana.
- 06Własne liczby, kompromisy i narzędzia to treść, której model nie odtworzy z parafrazy internetu.
- 07„Akapit 40–60 słów”, „7–20 nagłówków” i „61% vs 37%” nie mają pokrycia w danych.
- 08Przepisanie tekstu pod AI może obniżyć obecność w wynikach — dopisuj, nie przepisuj.
Ciąg dalszy przewodnika.
SEO, paid media i strategie widoczności w Double Digital