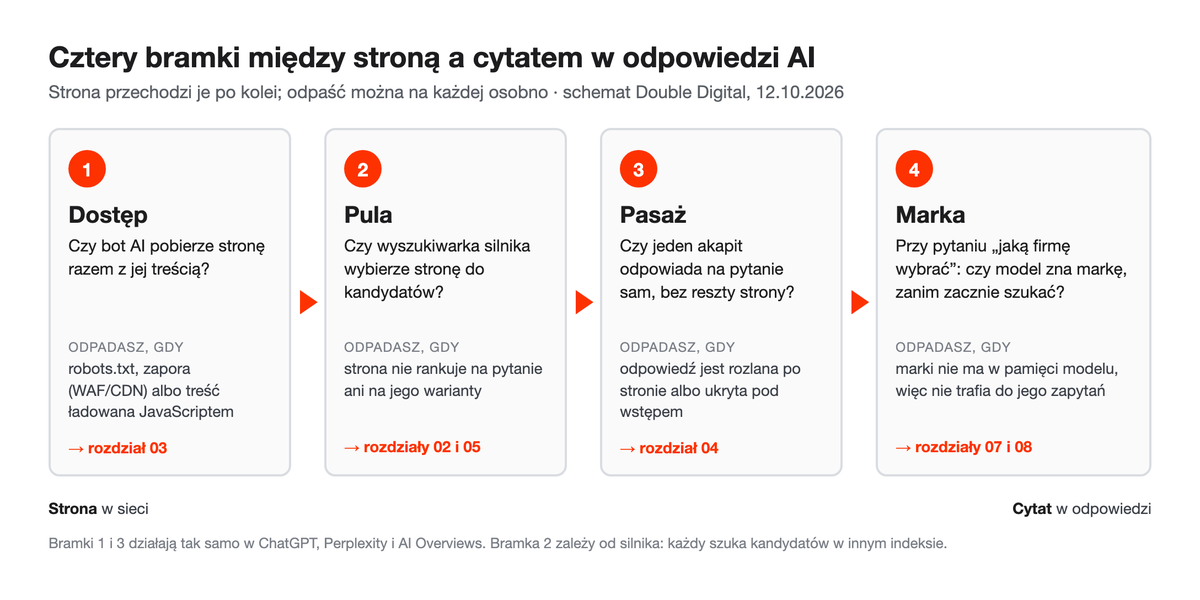
ChatGPT, AI Overviews i Perplexity odpowiadają z dwóch miejsc: z pamięci modelu albo z wyszukiwania na żywo. Żeby Twoja strona trafiła do odpowiedzi z cytatem, musi przejść cztery bramki po kolei.
Bot musi ją pobrać, wyszukiwarka musi ją wybrać do kandydatów, model musi wyjąć z niej pasujący akapit, a przy pytaniach o wybór firmy musi znać Twoją markę, zanim zacznie szukać. Odpaść można na każdej z nich osobno, dlatego najpierw ustal, gdzie odpadasz, a dopiero potem coś poprawiaj.
Mechanizm krok po kroku opisuje lekcja jak działają wyszukiwarki AI. Tutaj dostajesz diagnozę: cztery bramki, nasz pomiar 172 polskich fraz i test na 30 minut, z oceną dowodu przy każdej lekcji.
Cytat w AI to cztery osobne bramki: bot musi pobrać stronę, wyszukiwarka wybrać ją do kandydatów, model wyjąć z niej akapit, a przy pytaniach o wybór firmy znać markę. Najpierw ustal, na której odpadasz, potem poprawiaj.
- potwierdzoneco najmniej dwa niezależne pomiary zgodne co do kierunku
- pojedynczy pomiarjeden pomiar z jawną metodą: kierunek wiarygodny, liczba niepewna
- spornepomiary są sprzeczne albo spór o interpretację nie jest rozstrzygnięty
- mechanizmopis działania z dokumentacji platformy, patentu lub dokumentu sądowego
- praktykaobserwacja z pracy albo rekomendacja bez pomiaru
- obaloneliczba bez pokrycia w źródłach, zbita pomiarem albo wycofana przez autora
Ocena dotyczy tezy, nie źródła: dokumentacja Google opisuje mechanizm, ale nie mierzy jego efektu.
Skąd ChatGPT bierze informacje: z pamięci modelu czy z wyszukiwania
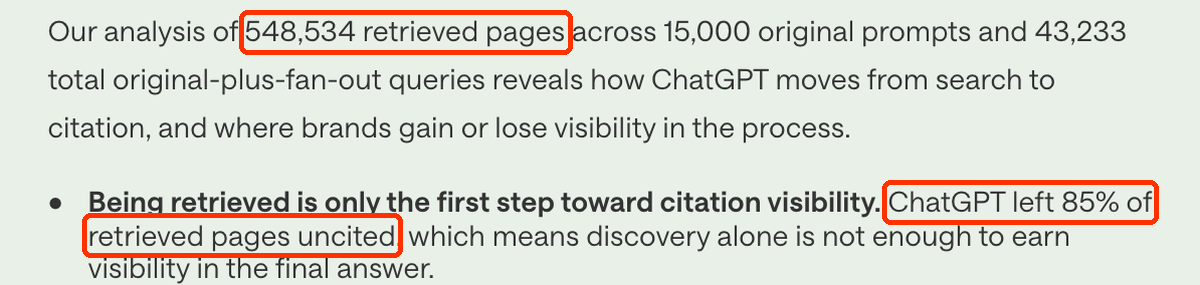
Z dwóch miejsc. Część pytań ChatGPT obsługuje z pamięci, czyli z danych, na których model był trenowany, bez wchodzenia do sieci. Na resztę odpowiada po wyszukiwaniu na żywo. Gdy szuka, Twoja strona może zostać pobrana, zacytowana albo tylko wspomniana z nazwy, a to trzy różne wyniki: w największym znanym pomiarze ChatGPT nie zacytował 85% stron, które pobrał.
Najpierw decyzja: szukać czy nie
Zanim ChatGPT cokolwiek wyszuka, przypisuje pytanie do jednej z kategorii: odpowiedź tekstowa, szybkie wyszukiwanie, zakupy, pytanie lokalne. Kategoria „tekst” oznacza zero ruchu w sieci, więc odpowiedź powstaje wyłącznie z pamięci modelu i żadna strona nie ma szansy na cytat. O kategorii decyduje sformułowanie pytania, a nie temat. Dlatego w jednej branży część pytań w ogóle nie dociera do wyszukiwarki, a część trafia do niej za każdym razem. Te reguły pochodzą z obserwacji z lipca 2026 r. i OpenAI może je zmienić bez zapowiedzi.
Pobrana, zacytowana, wspomniana
Kiedy model szuka, z Twoją stroną mogą stać się trzy rzeczy. Może zostać pobrana, czyli trafić do kontekstu modelu jako materiał do odpowiedzi. Może zostać zacytowana, czyli dostać odnośnik widoczny dla użytkownika. Twoja marka może też zostać wspomniana z nazwy w samym tekście odpowiedzi. Cytaty to tylko część pobrań, a wzmianka to osobna decyzja modelu przy pisaniu odpowiedzi. AirOps przeanalizował 548 534 strony pobrane przez ChatGPT i 85% z nich nie dostało cytatu:
Dejan Petrovic, który opisał te trzy zdarzenia jako osobne decyzje systemu, pokazuje, że zdarzają się wszystkie kombinacje. Strona bywa pobrana i odrzucona. Bywa zacytowana, choć nazwa marki w tekście nie pada. Bywa też odwrotnie: marka pojawia się w odpowiedzi, chociaż żadna jej strona nie została pobrana, bo model zna ją z treningu.
| Zdarzenie | Co znaczy | Jak to zobaczyć |
|---|---|---|
| Pobranie | strona trafiła do kontekstu modelu jako materiał do odpowiedzi | wizyty OAI-SearchBota i ChatGPT-User w logach serwera; „źródła” w części narzędzi do śledzenia AI |
| Cytat | odnośnik do strony pokazany użytkownikowi przy odpowiedzi | przypis lub panel źródeł w odpowiedzi; wejścia z chatgpt.com w GA4 |
| Wzmianka | nazwa marki w tekście odpowiedzi | sam tekst odpowiedzi; nie wymaga ani pobrania, ani cytatu |
Ta różnica ma praktyczny skutek. Narzędzie, które liczy każde pobranie jako „cytowanie”, pokaże Ci wyższą widoczność, niż widzi użytkownik. Zanim uwierzysz raportowi, sprawdź, które z trzech zdarzeń on liczy.
Cztery bramki do cytatu
Żeby dojść od strony w sieci do cytatu w odpowiedzi, trzeba przejść cztery bramki. Każda odcina inną grupę stron i każdą naprawia się czymś innym. Kolejne części rozdziału omawiają je po kolei, a każdą z nich rozwija osobny rozdział akademii.
Zadaj ChatGPT trzy pytania z Twojej branży: jedno o definicję, jedno o koszt w tym roku i jedno „jaką firmę wybrać do…”. Przy każdym zanotuj, czy odpowiedź ma odnośniki do źródeł. Pytania bez odnośników najpewniej poszły z pamięci modelu, więc przy nich żadna strona, także Twoja, nie miała szansy na cytat.
Bramka 1: czy bot AI w ogóle widzi Twoją stronę
To najczęstsza i najtańsza do naprawienia blokada. Strona, której bot nie pobierze albo pobierze bez treści, bo treść ładuje JavaScript, odpada przed wszystkimi innymi bramkami. Plik robots.txt to tylko część obrazu: 7 ze 100 największych polskich serwisów odrzuca boty wyszukiwarek AI na serwerze, choć robots.txt je wpuszcza.
Dostęp blokują trzy rzeczy, każda na innym poziomie.
- robots.txt. Każda firma AI ma osobne boty do treningu i do wyszukiwania. U OpenAI za trening odpowiada GPTBot, a za wyniki wyszukiwania ChatGPT OAI-SearchBot. Kto blokuje GPTBota w przekonaniu, że „wyłącza ChatGPT”, wyłącza tylko trening. Kto blokuje wszystko z „GPT” albo „OAI” w nazwie, znika też z wyszukiwarki.
- Zapora i CDN. Serwer może odrzucić bota, zanim ten w ogóle przeczyta robots.txt. Tak dzieje się w 7 ze 100 największych polskich serwisów: robots.txt wpuszcza OAI-SearchBota, ChatGPT-User albo PerplexityBota, a serwer odsyła im kod 402, 403 lub 410.
- Treść w JavaScripcie. Boty AI nie wykonują JavaScriptu. Jeśli cena, opis usługi albo cała treść pojawia się dopiero po uruchomieniu skryptu, bot pobierze pustą stronę i nie będzie miał czego zacytować.
W robots.txt blokady botów AI są częste. 35 ze 100 największych polskich serwisów blokuje co najmniej jednego, najczęściej GPTBota (23 serwisy). Ciekawe jest to, że 17 z tych 23 jednocześnie wpuszcza OAI-SearchBota, czyli świadomie oddziela trening od wyszukiwania:
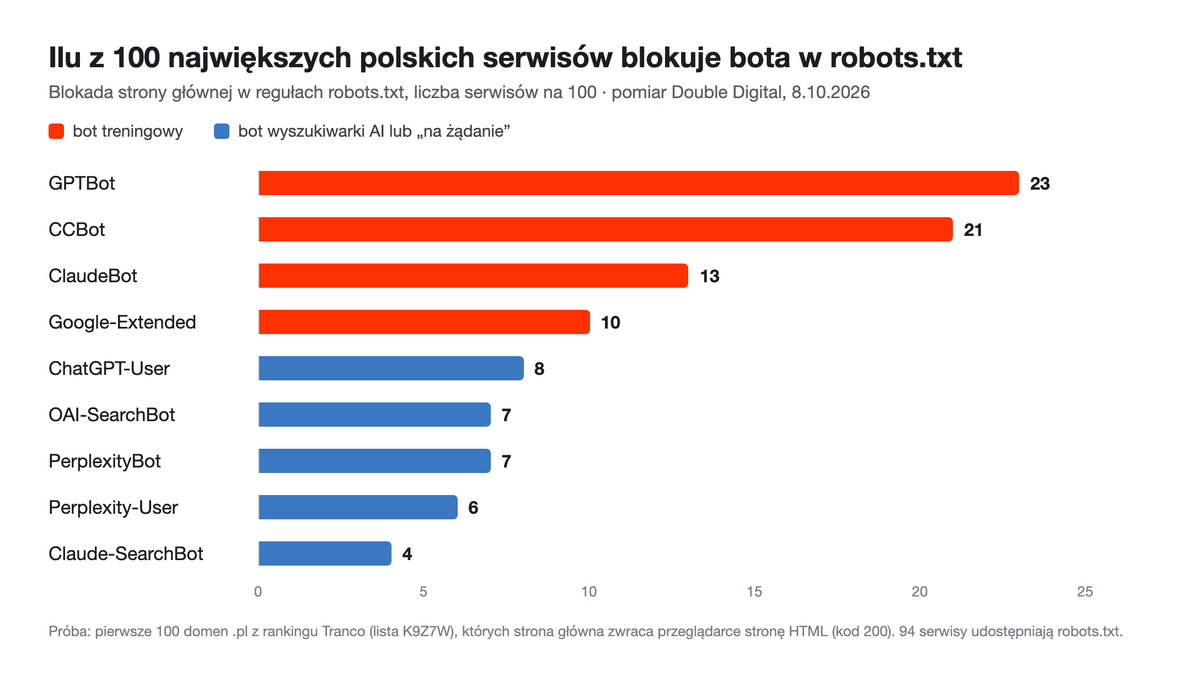
Duże portale chronią treść przed treningiem, ale chcą ruchu z ChatGPT. Typowa firma rzadko blokuje boty świadomie: w portfelu klientów Double Digital GPTBota blokowała 1 z 29 domen. Dlatego w firmie zacznij od zapory, CDN i treści ładowanej skryptem, bo te blokady działają bez wiedzy właściciela. Szczegóły, w tym gotowe reguły robots.txt i test w logach serwera, znajdziesz w rozdziale boty AI, robots.txt i llms.txt.
Otwórz twojadomena.pl/robots.txt i sprawdź, czy któraś reguła dotyczy OAI-SearchBota, PerplexityBota albo całej grupy *. Potem pobierz stronę w terminalu jako bot: curl -A "OAI-SearchBot" -I https://twojadomena.pl/. Kod 200 to dobry znak, a 402, 403 lub 410 oznacza blokadę na serwerze. Na koniec wyłącz JavaScript w przeglądarce i otwórz najważniejszą podstronę: to, czego wtedy nie widać, nie istnieje dla bota AI.
Bramka 2: czy ranking w Google decyduje o cytowaniu w AI
Tak, ranking jest biletem do puli kandydatów, ale nie gwarancją cytatu. W naszym pomiarze polskich AI Overviews, sprawdzonym w przeglądarce na 26 frazach, 63% źródeł stało na pierwszej stronie wyników, a wynik #1 był cytowany w 23 z 26 fraz. Te same przeglądy porównane z wynikami pobranymi przez narzędzie dają obraz odwrotny: tylko 35% źródeł w czołówce i prawie połowa „spoza top 100”. Dlatego liczby o cytatach „spoza top 100” trzeba czytać ostrożnie.
Asystent AI nie przeszukuje całej sieci. Pyta wyszukiwarkę, bierze z jej wyników kandydatów i dopiero spośród nich wybiera źródła. Strona, której wyszukiwarka nie pokaże wysoko na pytanie użytkownika ani na żadne z pytań pomocniczych, które model zadaje w tle, nie trafi do puli. Dlatego pozycjonowanie nie przestało mieć znaczenia: jest warunkiem wejścia do gry, choć samo cytatu nie daje. Szerzej o tym, co z klasycznego SEO zostaje ważne, piszemy w lekcji SEO w erze AI.
Co mierzyli inni
Najczęściej cytowane pomiary dotyczą różnych silników i liczą co innego, więc ich liczb nie da się wprost porównać.
| Kto mierzył | Silnik | Co liczył | Wynik | Ocena |
|---|---|---|---|---|
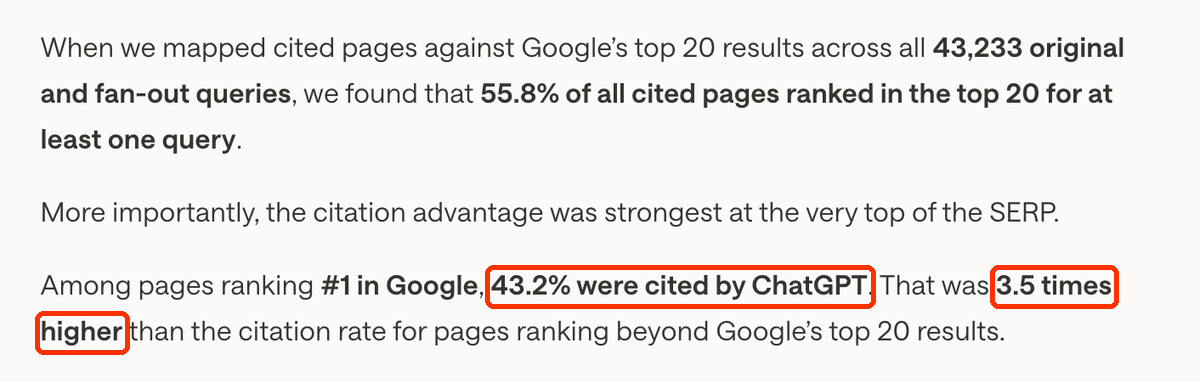
| AirOps | ChatGPT | jak często ChatGPT cytuje stronę z danej pozycji w Google | #1: 43,2%; poza top 20: 12,3% | pojedynczy pomiar, vendor |
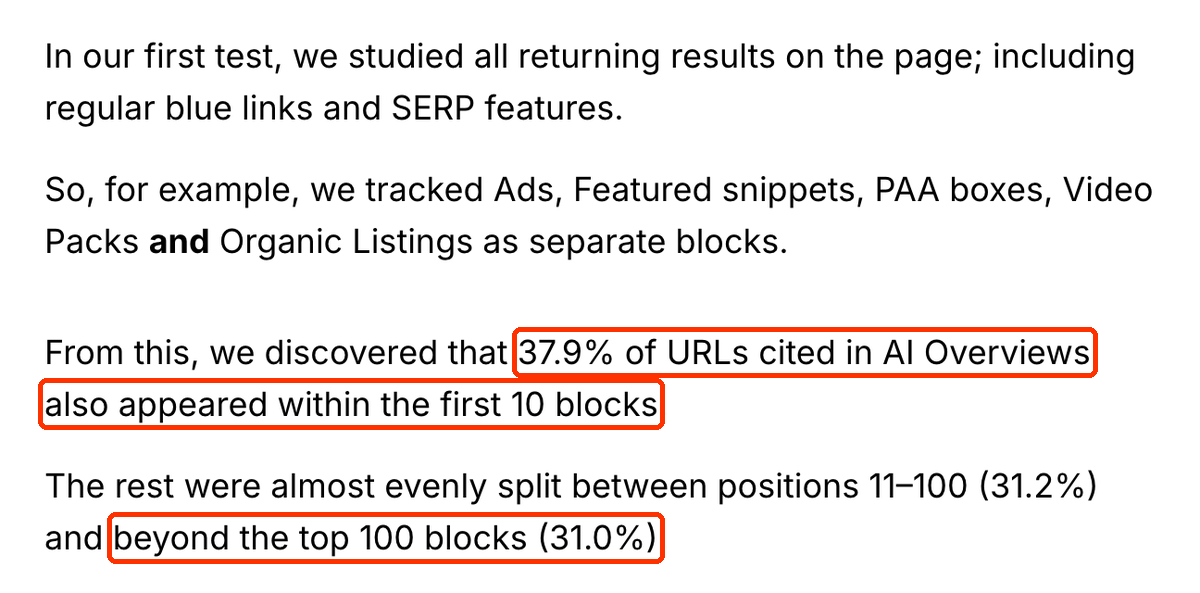
| Ahrefs | AI Overviews | gdzie w wynikach Google stoją adresy cytowane w przeglądzie | 37,9% w pierwszych 10 blokach, 31,0% poza top 100 | pojedynczy pomiar, vendor; wcześniejsza wersja badania dawała 76% |
| Double Digital | AI Overviews, google.pl | to samo co Ahrefs, ale w przeglądarce | 63,3% źródeł na 1. stronie; #1 cytowany w 88,5% fraz | pojedynczy pomiar, 26 fraz |
W ChatGPT efekt pozycji jest wyraźny: strona z pierwszego miejsca w Google była cytowana 3,5 raza częściej niż strona spoza pierwszej dwudziestki.
W AI Overviews Ahrefs zobaczył słabszy związek. Jego „blokiem” jest każdy element strony wyników, także reklama, fragment z odpowiedzią i pytania z sekcji „Podobne pytania”, więc „pierwsze 10 bloków” to mniej niż 10 wyników organicznych. To ten pomiar najczęściej stoi za zdaniem, że AI Overviews „cytują strony spoza top 100”:
Nasz pomiar: 172 polskie frazy
Dla polskiego Google nie było takiego pomiaru, więc zrobiliśmy własny. Wzięliśmy 172 frazy o największym wolumenie z 12 branż, od zdrowia i podatków po elektronikę i motoryzację. 12 października 2026 r. pobraliśmy dla nich przez DataForSEO wyniki Google (google.pl, język polski, desktop, 100 wyników) razem z przeglądem od AI. Przegląd pojawił się na 113 frazach, czyli na 66%, a cytował w medianie 6 źródeł. Te same frazy odczytaliśmy ponownie 20 października: po 8 dniach zostało 67% adresów źródeł. Jak sprawdzać cytaty w AI Overviews w czasie, opisujemy w rozdziale jak mierzyć widoczność w AI.
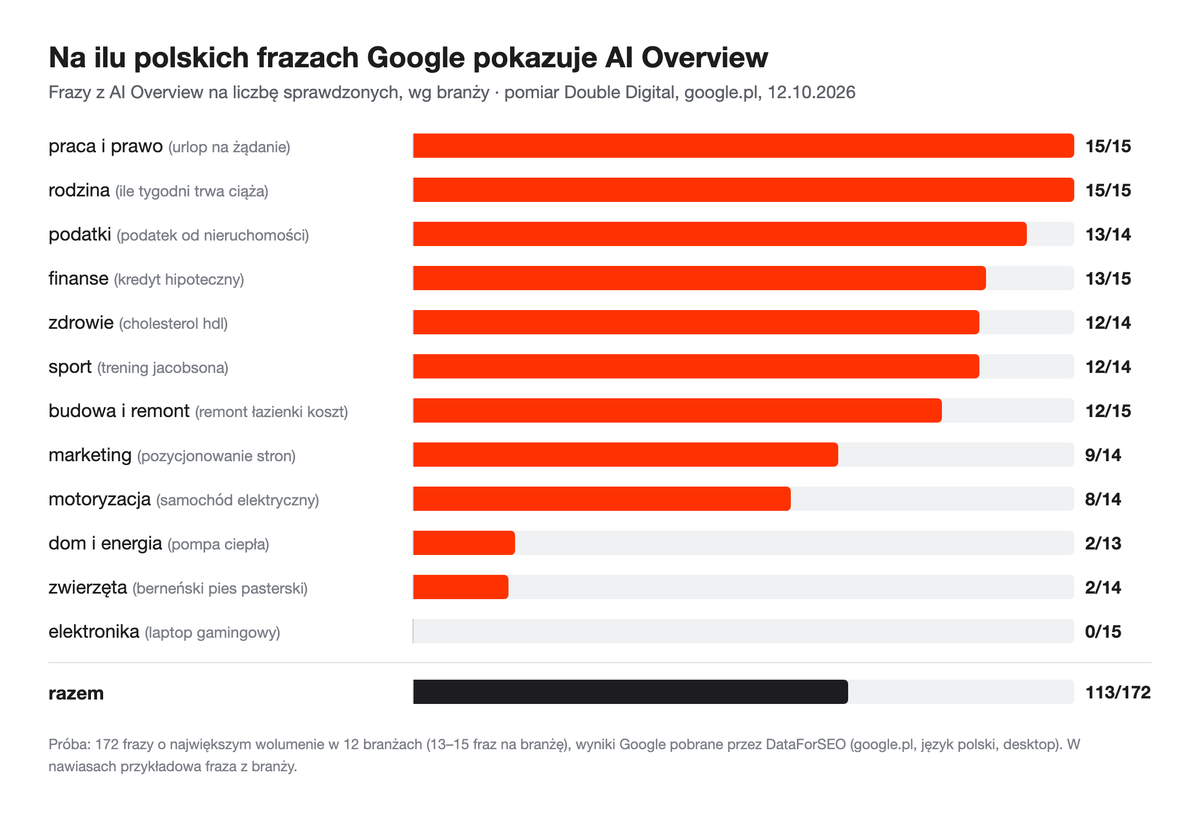
O tym, czy przegląd się pojawi, decyduje rodzaj pytania. Pytania o przepisy, zdrowie, podatki i koszty dostawały go prawie zawsze: urlopy i ciąża na 15 z 15 fraz. Frazy produktowe i hasła typu „pies” prawie nigdy: laptopy na 0 z 15, rasy psów na 2 z 14. Jeśli Twoja branża przypomina elektronikę, AI Overviews nie są dziś Twoim największym zmartwieniem.
Przeglądarka a narzędzie: dwa obrazy tego samego AI Overview
Wyniki z narzędzia porównaliśmy z tym, co widzi człowiek. Dla 26 fraz z przeglądem otworzyliśmy Google w przeglądarce i zapisaliśmy zarówno źródła przeglądu, jak i wyniki organiczne z pierwszej strony. Obraz okazał się zupełnie inny niż w danych z narzędzia:
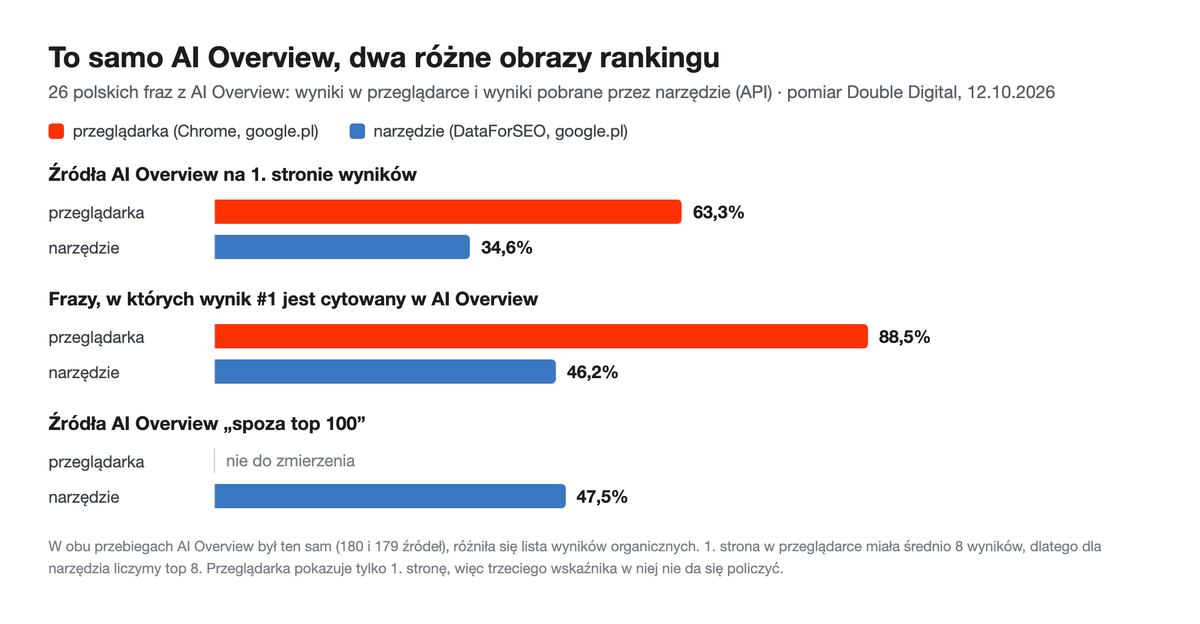
Sam przegląd był w obu przypadkach ten sam: 180 źródeł w przeglądarce i 179 w narzędziu. Różniła się lista wyników organicznych, z którą go porównywaliśmy. W przeglądarce 63% źródeł przeglądu stało na pierwszej stronie, a wynik #1 był cytowany w 23 z 26 fraz. Według narzędzia tylko 35% źródeł było w czołówce, a 47,5% „poza top 100”. Najlepiej widać to na frazie „urlop rodzicielski”. Przegląd cytuje trzy strony i w przeglądarce są to trzy pierwsze wyniki organiczne. W danych z narzędzia żadnej z nich nie ma w pierwszej setce.
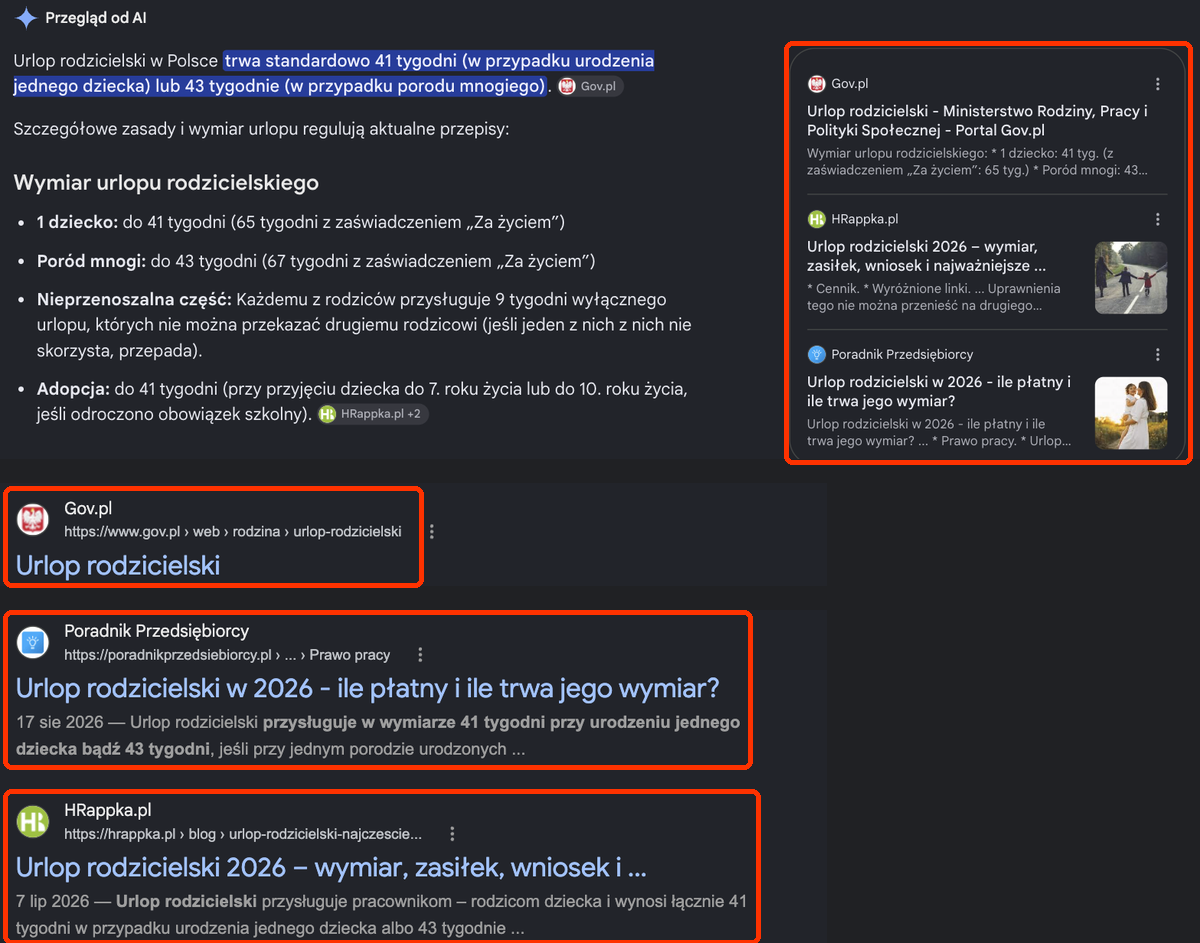
Narzędzie ustawione na google.com zamiast google.pl dawało jeszcze gorszą zgodność: 29% źródeł w czołówce i 56% „poza top 100”. Wniosek jest dla nas taki: część „cytatów spoza top 100” w raportach może wynikać z porównywania przeglądu z inną wersją wyników niż ta, którą widzi użytkownik. To hipoteza, nie dowód, że cudze badania są błędne, bo nie znamy dokładnie sposobu, w jaki ich autorzy pobierali wyniki.
W Google Search Console znajdź 3–5 fraz, na które Twoja strona ma pozycję w pierwszej dziesiątce. Wpisz każdą w Google w przeglądarce i sprawdź, czy pojawia się przegląd od AI i czy Twoja strona jest w jego źródłach. Zapisz też, które miejsca w wynikach zajmują strony cytowane. Nie opieraj tej oceny na samym narzędziu do śledzenia pozycji, bo jak widać wyżej, może pokazywać inną listę wyników niż ta, którą widzi klient.
Bramka 3: model cytuje fragment, nie stronę
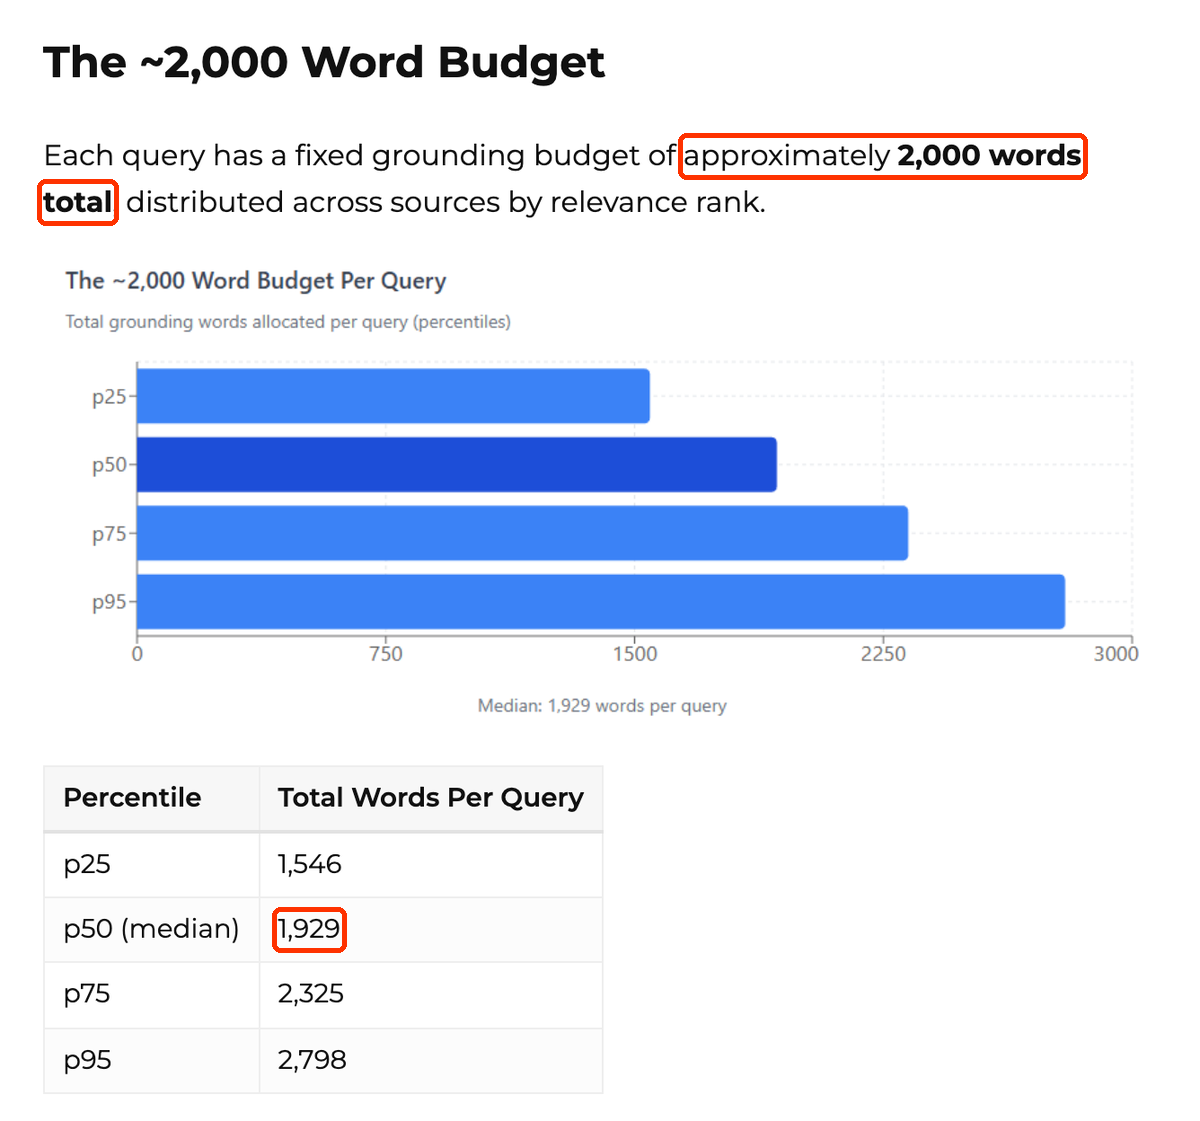
Nawet strona z puli rzadko trafia do modelu w całości. Gemini dostaje na całe zapytanie w medianie około 2 000 słów z kilku stron i około 540 słów z jednej, więc o cytacie decyduje to, czy jeden akapit odpowiada na pytanie sam, bez reszty strony. Dłuższa strona nie daje modelowi więcej tekstu.
System, który buduje odpowiedź, nie czyta strony od góry do dołu. Tnie ją na fragmenty, ocenia każdy fragment względem pytania i wybiera najlepsze zdania. Dejan Petrovic przeanalizował dane, które Gemini zwraca razem z odpowiedzią, dla 7 060 zapytań. Na jedno zapytanie model dostał łącznie w medianie 1 929 słów ze wszystkich źródeł:
Ilość tekstu z pojedynczej strony zatrzymywała się na około 540 słowach, niezależnie od tego, jak długa była strona. Przy tekstach do 1 000 słów to 61% treści, przy tekstach powyżej 3 000 słów już tylko 13%:
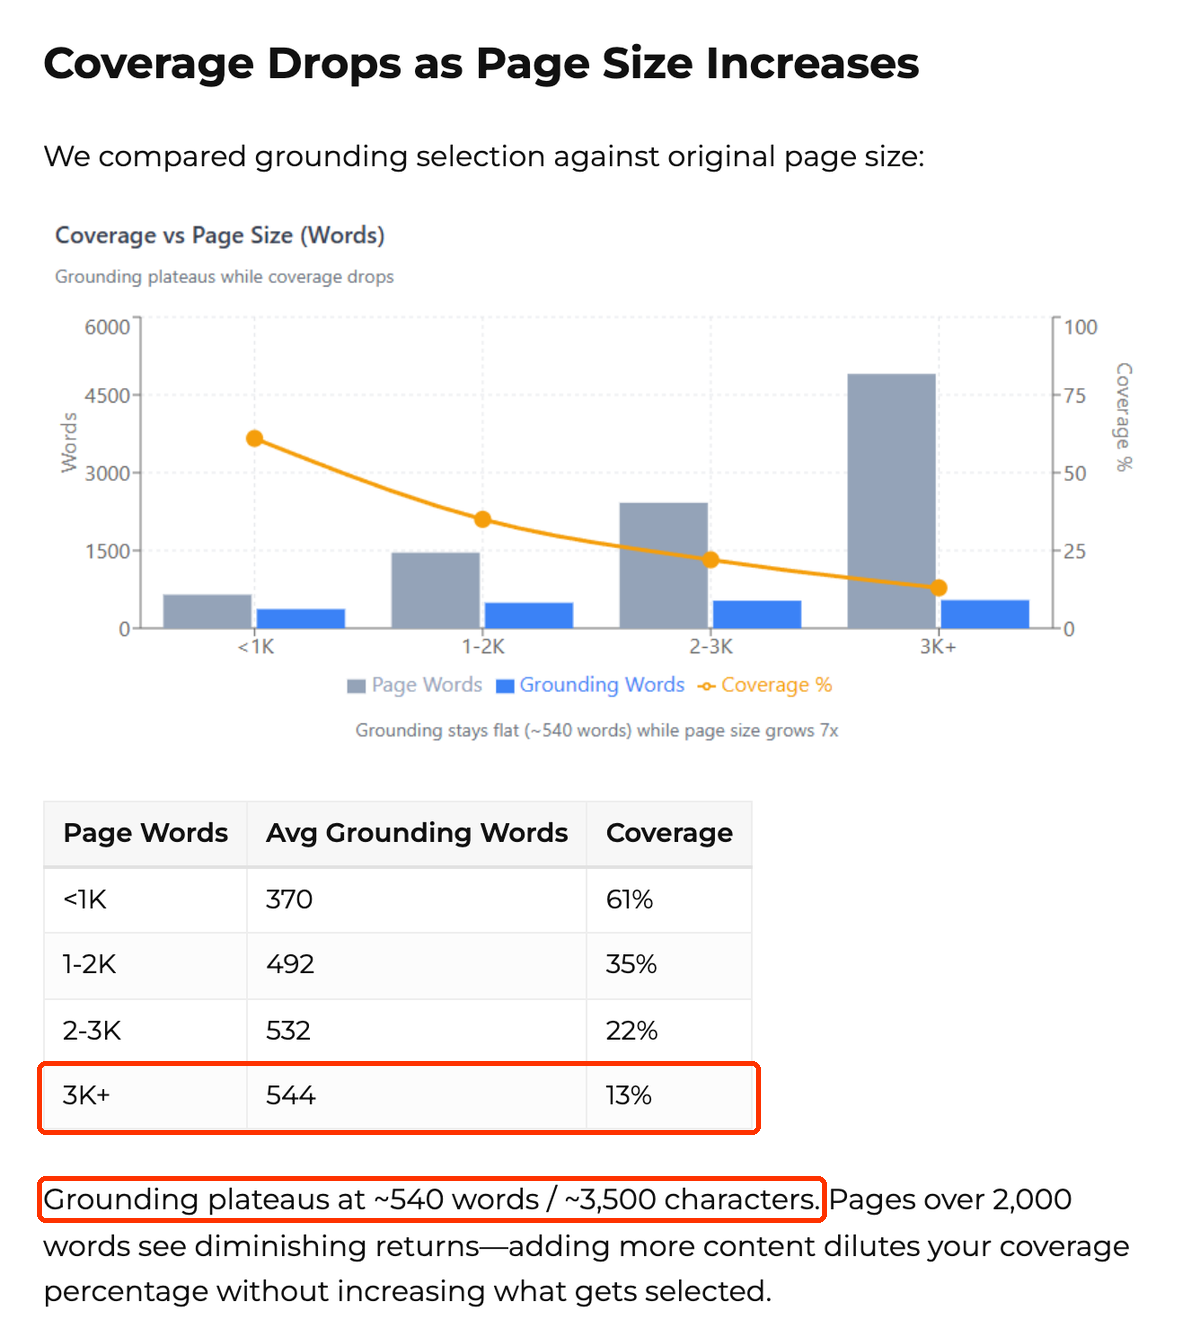
Sam autor nazywa te liczby sygnałem kierunkowym, a w innym jego pomiarze ilość tekstu rośnie z liczbą źródeł, więc „2 000 słów” traktuj jako medianę, a nie sztywny limit. Wniosek nie zależy jednak od dokładnej liczby: model widzi wycinek strony, a nie całość.
Co z tego wynika dla treści
- Odpowiedź na początku akapitu. System chętniej bierze początki akapitów, więc zdanie, które odpowiada na pytanie, powinno stać na początku, a nie po trzech zdaniach wstępu. Mechanizm tego zjawiska opisuje lekcja jak działają wyszukiwarki AI.
- Akapit bez odwołań. Fragment zaczynający się od „jak wspomniano wyżej” albo „w tym przypadku” traci sens po wycięciu ze strony i przegrywa z fragmentem, który da się zrozumieć sam.
- Jedno twierdzenie w jednym zdaniu. Zgłoszenie patentowe Google opisuje dopasowanie cytatu już po napisaniu odpowiedzi: zdanie z odpowiedzi porównuje się ze zdaniami z pobranych stron i link dostaje strona, której zdanie pasuje. Jednoznaczne zdanie z liczbą łatwiej dopasować niż myśl rozłożoną na cały akapit.
Jak pisać takie akapity w praktyce, z przykładami przed i po, omawiamy w jednym z kolejnych rozdziałów akademii.
Weź stronę, która ma odpowiadać na ważne dla Ciebie pytanie. Skopiuj pierwszy akapit pod nagłówkiem tej sekcji i wklej go do pustego dokumentu. Przeczytaj go tak, jakbyś nie znał reszty strony: czy odpowiada na pytanie, czy tylko zapowiada odpowiedź? Jeśli zapowiada, przenieś odpowiedź na początek.
Bramka 4: skąd ChatGPT bierze informacje o firmie
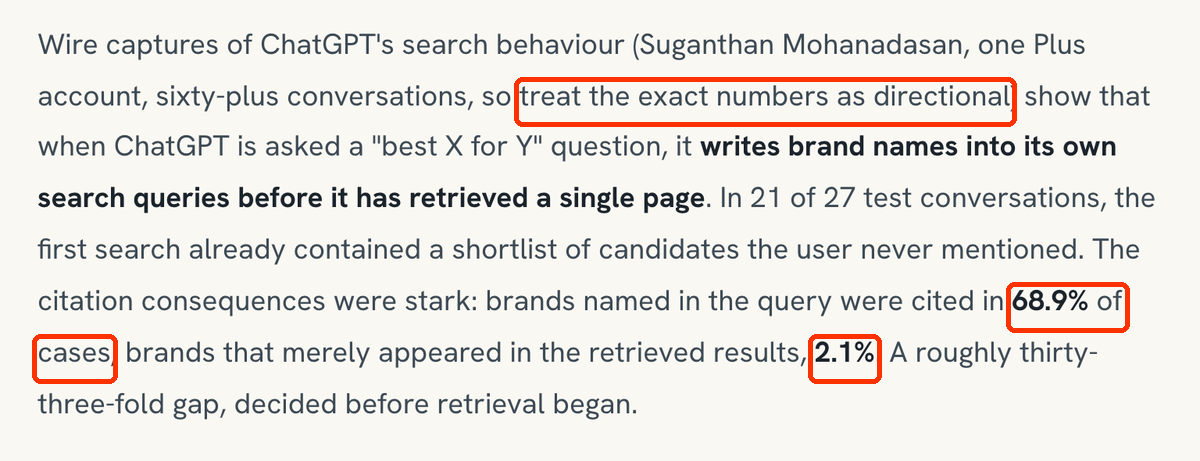
Przy pytaniach „jaką firmę albo jaki produkt wybrać” model najczęściej zaczyna od marek, które zna z treningu, i wpisuje je do własnych zapytań. W jednym pomiarze marki nazwane w zapytaniu modelu były cytowane w 68,9% przypadków, a marki, które tylko pojawiły się w wynikach, w 2,1%. Strona zamienia obecność marki na cytat, ale jej nie wytwarza.
Shortlista powstaje, zanim model cokolwiek pobierze
Suganthan Mohanadasan podejrzał ruch sieciowy ChatGPT w ponad 60 rozmowach. Gdy pytał o „najlepsze X do Y”, w 21 z 27 rozmów pierwsze wyszukiwanie modelu zawierało już nazwy marek, których użytkownik nie wymienił. Model wpisywał je do zapytania, zanim pobrał jakąkolwiek stronę. Stephen Sumner, który opisał ten pomiar, sam zaznacza, że liczby trzeba traktować kierunkowo:
Inną metodą doszedł do tego samego geoSurge. W 66 pytaniach z dziewięciu branż najpierw sprawdził, które marki model pamięta z treningu, a potem, których marek szuka model odpowiadający z wyszukiwaniem (oba pomiary na osobnych modelach). Marka z pierwszej dziesiątki pamięci modelu trafiała do jego wyszukiwań w 55,7% przypadków, marka spoza pamięci w 17,4%:
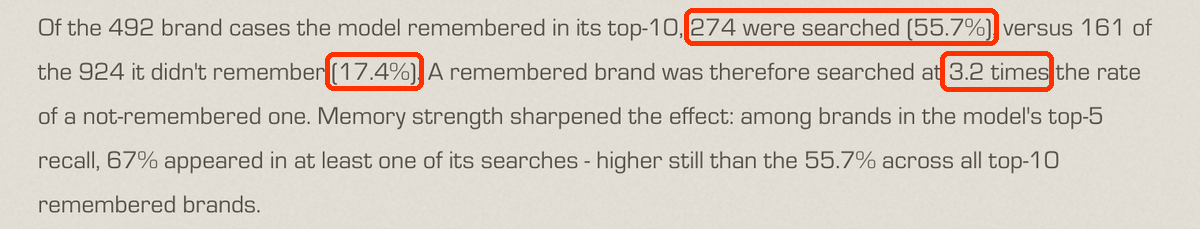
To związek, a nie dowód przyczyny, bo marki, które model pamięta, mogą być po prostu silniejsze także w sieci. Kierunek z obu pomiarów jest jednak ten sam. Przy pytaniach o wybór firmy o liście kandydatów w dużej mierze decyduje to, co model wie przed wyszukiwaniem. Jak sprawdzić, czy model zna Twoją markę bez wyszukiwania, i co pokazał ten sam test na 300 polskich odpowiedziach, opisujemy w rozdziale o marce poza stroną.
Drzwi nie są zamknięte
geoSurge zobaczył dwa typy kategorii. W jednych, na przykład w motoryzacji i finansach, model szuka prawie wyłącznie marek, które pamięta. W innych, na przykład w fitnessie, szuka szerzej i potrafi wciągnąć do odpowiedzi markę, której nie pamiętał. W wąskiej niszy żywa treść ma więc więcej miejsca niż w kategorii zdominowanej przez kilku dużych graczy.
Skąd model wie o firmie? Z tekstów, na których się uczył: artykułów prasowych, porównań, rankingów, forów i opinii. Tę wiedzę buduje się poza własną stroną, więc ta bramka wymaga innej pracy niż trzy poprzednie. Wrócimy do niej w rozdziale o marce poza stroną. Jeśli chcesz wiedzieć, jak modele opisują Twoją firmę dziś, sprawdzamy to w ramach analizy widoczności marki w AI.
Zadaj ChatGPT pytanie o wybór firmy z Twojej kategorii, na przykład „jaką firmę wybrać do [usługa] w [miasto]”, najpierw z wyłączonym wyszukiwaniem, potem z włączonym. Powtórz każde pytanie pięć razy w nowych rozmowach. Jeśli Twoja marka nie pojawia się bez wyszukiwania, model jej nie pamięta i przy takich pytaniach startujesz z gorszej pozycji niż konkurenci, których wymienia.
ChatGPT, Perplexity i AI Overviews: trzy silniki, trzy różne pule
Każdy silnik szuka kandydatów w innym indeksie: ChatGPT głównie przez Bing, AI Overviews w Google, a Perplexity we własnym. Dlatego wygrana w jednym nie przenosi się na pozostałe. Dla tego samego promptu tylko 2,37% cytowanych adresów pojawia się we wszystkich trzech.
Kevin Indig przeanalizował 20 000 promptów śledzonych w narzędziu Omnia, głównie na rynkach europejskich. Tylko 2,37% cytowanych adresów pojawiło się w ChatGPT, Perplexity i AI Overviews jednocześnie, a 91,07% w jednym silniku:
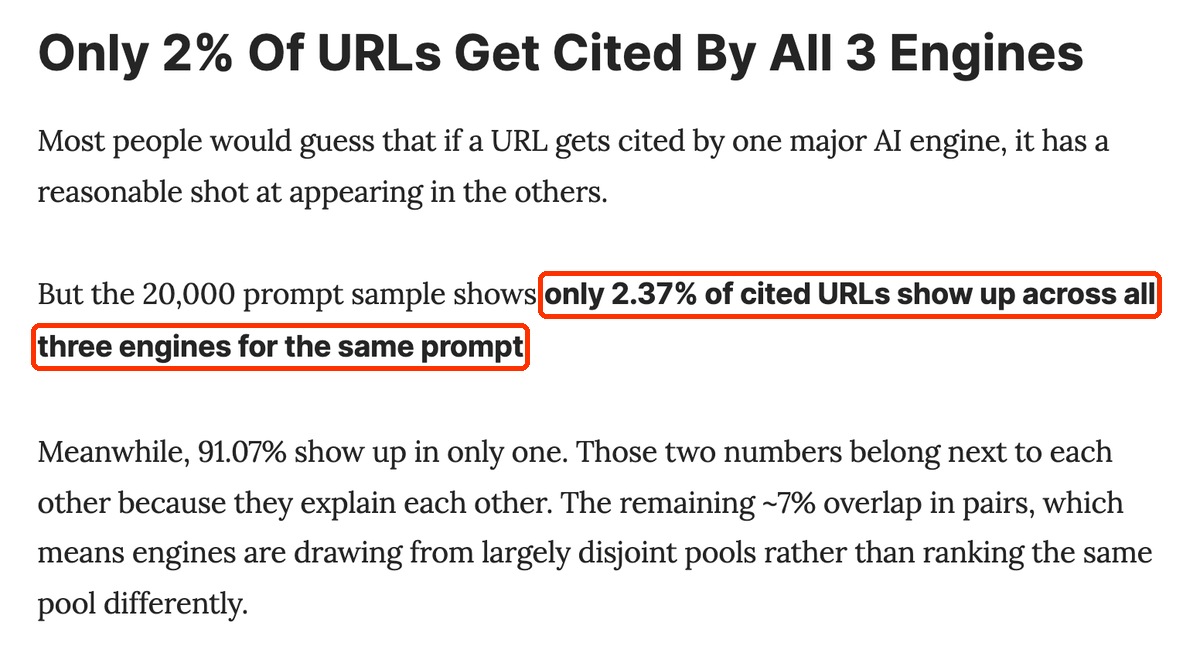
Inne badania dają podobny obraz. W recenzowanym pomiarze 11 500 zapytań podobieństwo zbiorów adresów między zwykłymi wynikami Google, AI Overviews i Gemini (współczynnik Jaccarda) wynosiło zaledwie 0,11–0,18, choć to produkty jednej firmy. Silniki nie układają tej samej listy w innej kolejności, tylko sięgają do różnych zbiorów stron.
| Silnik | Skąd bierze kandydatów | Co to znaczy dla Ciebie |
|---|---|---|
| ChatGPT | głównie wyniki Bing; przy zakupach dane z Google Shopping | pozycja w Bing i dostęp dla OAI-SearchBota; zgłoś stronę w Bing Webmaster Tools |
| AI Overviews | indeks i ranking Google | zwykłe SEO w Google i prawo do snippetu; osobnego bota nie ma (z czego korzysta AI Mode, Google nie ujawnia) |
| Perplexity | własny indeks budowany przez PerplexityBota | dostęp dla PerplexityBota; pozycja w Google nie przekłada się tu wprost |
Dwie bramki działają wszędzie tak samo. Strona niedostępna dla bota odpada w każdym silniku, a akapit, który odpowiada sam, ma przewagę w każdym. Różni się pula, czyli bramka 2, i częściowo pamięć modelu, czyli bramka 4. Z tego wynika jedna zasada dla raportów: każda liczba o widoczności w AI musi mówić, o który silnik chodzi, w jakim trybie i z którego dnia. „Jesteśmy widoczni w AI” bez tych trzech informacji nic nie znaczy. Jak mierzyć to rzetelnie, omawiamy w rozdziale o pomiarze widoczności.
Jak sprawić, żeby AI cytowało Twoją stronę: test czterech bramek
Weź jedną frazę, na której Ci zależy, i sprawdź bramki po kolei. Pierwsza, która nie przechodzi, jest Twoim zadaniem. Poprawianie treści nie pomoże, jeśli odpada dostęp, a PR nie pomoże, jeśli strony nie ma w puli.
Test zajmuje około 30 minut. Wybierz frazę, przy której pojawia się przegląd od AI albo którą klienci mogą zadać ChatGPT, oraz stronę, która ma na nią odpowiadać.
- Dostęp (5 minut). Sprawdź robots.txt pod kątem OAI-SearchBota i PerplexityBota. Pobierz stronę poleceniem
curl -A "OAI-SearchBot" -Ii zobacz kod odpowiedzi. Otwórz stronę z wyłączonym JavaScriptem i sprawdź, czy widać odpowiedź na pytanie. - Pula (10 minut). W Google Search Console sprawdź pozycję strony na frazę i na 2–3 jej warianty. Potem wpisz frazę w Google w przeglądarce, nie w narzędziu do śledzenia pozycji, i zobacz, które strony cytuje przegląd od AI. Dla ChatGPT powtórz to samo w Bing.
- Pasaż (10 minut). Skopiuj pierwszy akapit sekcji, która ma odpowiadać na pytanie, i przeczytaj go bez reszty strony. Porównaj go z akapitem ze strony, którą cytuje przegląd: który szybciej i konkretniej odpowiada?
- Marka (5 minut). Jeśli fraza dotyczy wyboru firmy lub produktu, zadaj ChatGPT pytanie kategorialne z wyłączonym wyszukiwaniem, pięć razy w nowych rozmowach. Zapisz, które marki wymienia.
Wynik czytaj od góry. Jeśli strona odpada na bramce 1, wyniki z bramek 2–4 nie mają jeszcze znaczenia, bo bot i tak nie dostanie treści.
| Wynik testu | Co robić | Gdzie czytać dalej |
|---|---|---|
| Bot dostaje kod 402, 403 lub 410 albo robots.txt blokuje bota wyszukującego | odblokuj bota w robots.txt, zaporze lub CDN | boty AI, robots.txt i llms.txt |
| Bez JavaScriptu nie widać odpowiedzi | przenieś treść, ceny i linki do HTML-a z serwera | boty AI, robots.txt i llms.txt |
| Strona jest poza pierwszą stroną wyników na frazę i jej warianty | najpierw zwykłe SEO: pozycja w Google lub Bing | AI Overviews i AI Mode, SEO w erze AI |
| Strona jest w czołówce, ale nie jest cytowana | przepisz akapit tak, żeby odpowiadał sam, na początku sekcji | kolejne rozdziały akademii o treści cytowanej przez AI |
| Model nie wymienia Twojej marki bez wyszukiwania | buduj obecność marki poza stroną: prasa, porównania, rankingi, opinie | kolejne rozdziały akademii o marce poza stroną |
Test nie gwarantuje cytatu. Mówi tylko, od czego zacząć, żeby nie wydawać pieniędzy na bramkę, która i tak jest otwarta. Co robić tydzień po tygodniu, od testu dostępu do odczytu wobec grupy kontrolnej, rozpisaliśmy w rozdziale plan wdrożenia na 30 dni. Jeśli wolisz, żeby ktoś przeprowadził go na wielu frazach i kilku silnikach naraz, zrobimy to w ramach analizy widoczności marki w AI.
FAQ — najczęściej zadawane pytania o to, jak AI wybiera źródła
- Czy ChatGPT podaje prawdziwe informacje?
Nie zawsze. Model może się pomylić zarówno wtedy, gdy odpowiada z pamięci, jak i wtedy, gdy podaje źródło. Cytat pokazuje, skąd model wziął materiał, ale nie gwarantuje, że odpowiedź wiernie go oddaje. Przy ważnych decyzjach otwórz cytowaną stronę i sprawdź liczbę u źródła.
- Czy trzeba być w top 10 Google, żeby AI Overview zacytował stronę?
Nie trzeba, ale bardzo pomaga. W naszym pomiarze polskich przeglądów, sprawdzonym w przeglądarce, 63% źródeł stało na pierwszej stronie wyników, a wynik #1 był cytowany w 23 z 26 fraz. Część źródeł pochodzi jednak spoza pierwszej strony, prawdopodobnie dlatego, że Google szuka też odpowiedzi na pytania pomocnicze, których w wynikach nie widać.
- Czy ChatGPT korzysta z Google?
W zwykłym wyszukiwaniu ChatGPT opiera się głównie na wynikach Bing, nie Google. Wyjątkiem są zakupy: według przechwyconego ruchu sieciowego ChatGPT Shopping bierze produkty, ceny i oceny z wyników Google Shopping. Dlatego sklep powinien dbać o Merchant Center, a firma usługowa także o pozycję w Bing.
- Dlaczego narzędzie do śledzenia AI pokazuje inne źródła niż widzę w Google?
Bo Google nie pokazuje wszystkim tej samej strony wyników. Lista zależy od lokalizacji, ustawień konta, wersji domeny (google.pl albo google.com) i chwili pobrania. W naszym pomiarze ten sam przegląd od AI porównany z wynikami z przeglądarki i z narzędzia dawał 63% albo 35% źródeł w czołówce. Ostateczną ocenę rób w przeglądarce, na tej domenie Google i w tej lokalizacji, w której szukają Twoi klienci.
Cztery bramki w ośmiu zdaniach
- 01Część pytań ChatGPT obsługuje z pamięci modelu, bez wyszukiwania — przy nich żadna strona nie dostaje cytatu.
- 02Pobranie, cytat i wzmianka to trzy różne zdarzenia: ChatGPT nie cytuje 85% stron, które pobrał.
- 03Bramka 1: bot musi dostać treść — blokuje robots.txt, zapora, CDN i treść ładowana JavaScriptem.
- 04Bramka 2: ranking to bilet do puli, nie gwarancja — w polskich AI Overviews 63% źródeł stoi na 1. stronie.
- 05Narzędzie i przeglądarka potrafią pokazać dwa różne obrazy tego samego przeglądu — oceniaj w przeglądarce.
- 06Bramka 3: model widzi z jednej strony ok. 540 słów, więc wygrywa akapit, który odpowiada sam.
- 07Bramka 4: przy pytaniach o wybór firmy model zaczyna od marek, które zna z treningu.
- 08ChatGPT, Perplexity i AI Overviews cytują w dużej mierze różne strony — raport musi nazwać silnik i datę.
Ciąg dalszy przewodnika.
SEO, paid media i strategie widoczności w Double Digital