Widoczność w AI mierzy się jak rozkład, a nie jak pozycję w Google.
W naszym pomiarze ten sam polski prompt zadany 10 razy ani razu nie dał identycznej listy marek we wszystkich odpowiedziach (0 z 22 kategorii w GPT-6, 0 z 25 w Gemini). Dlatego jeden zrzut z ChatGPT niczego nie dowodzi, a jeden prompt powtórzony pięć razy wciąż myli się średnio o 13–17 punktów procentowych.
Stabilny wynik daje dopiero portfel: 22–25 promptów zadanych raz myli się średnio o 7–10 pp, zadanych pięć razy o 3–4 pp (pomiar Double Digital, 575 polskich odpowiedzi AI).
Wymienienia marki, cytaty i linki liczysz osobno dla każdego silnika, bo ChatGPT częściej cytuje, a Gemini częściej wymienia. Cytaty w AI Overviews zmienia czas, nie przypadek: po 15 minutach zostaje 88% źródeł, po 8 dniach 67%.
W GA4 Google dodał w maju 2026 kanał „AI Assistant”, ale kanał nie działa wstecz i nie obejmuje Perplexity, więc ruch z AI filtruj po źródle. Narzędzie kupuj dopiero wtedy, gdy dostawca powie, czy mierzy przez API, czy przez aplikację.
Jak zwiększać widoczność, opisują rozdziały 01–08; ten rozdział uczy, jak sprawdzić, czy to działa.
Widoczność w AI to rozkład, nie pozycja: jeden zrzut z ChatGPT niczego nie dowodzi. Wynik daje portfel 30–50 promptów z Search Console, liczony osobno dla każdego silnika i porównywany z progiem szumu.
- potwierdzoneco najmniej dwa niezależne pomiary zgodne co do kierunku
- pojedynczy pomiarjeden pomiar z jawną metodą: kierunek wiarygodny, liczba niepewna
- spornepomiary są sprzeczne albo spór o interpretację nie jest rozstrzygnięty
- mechanizmopis działania z dokumentacji platformy, patentu lub dokumentu sądowego
- praktykaobserwacja z pracy albo rekomendacja bez pomiaru
- obaloneliczba bez pokrycia w źródłach, zbita pomiarem albo wycofana przez autora
Ocena dotyczy tezy, nie źródła: dokumentacja Google opisuje mechanizm, ale nie mierzy jego efektu.
Jak sprawdzić widoczność marki w AI: rozkład zamiast pozycji
Widoczność w AI to odsetek odpowiedzi, w których marka się pojawia, liczony na wielu odpowiedziach. Miejsce na liście w jednej odpowiedzi nie jest dobrą miarą, bo ta sama lista prawie się nie powtarza. Celem jest być w „rdzeniu”, czyli w odpowiedziach, które model daje niemal zawsze, a nie „na 1. miejscu”.
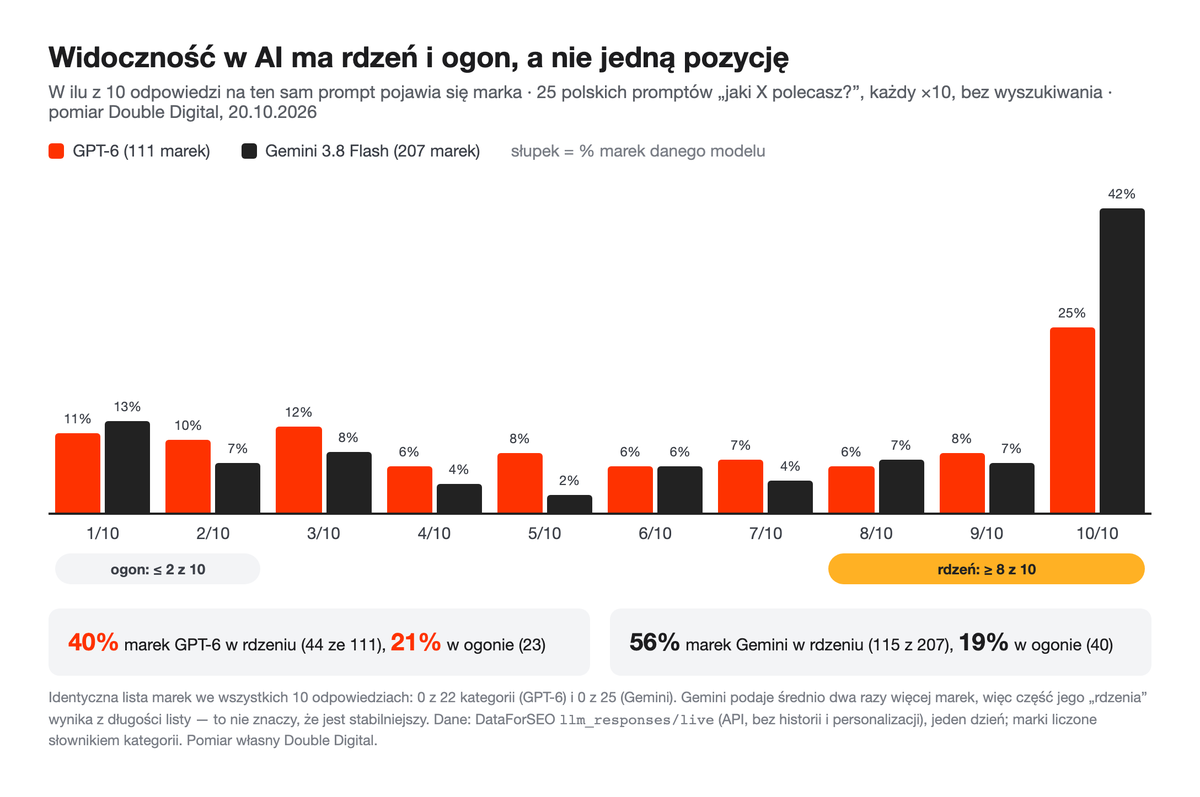
Zadaliśmy GPT-6 i Gemini 3.8 Flash po 25 polskich pytań w stylu „Jaki system CRM polecasz dla małej firmy usługowej?”, każde 10 razy, w nowych rozmowach, bez wyszukiwania. Identyczna lista marek we wszystkich 10 odpowiedziach nie padła ani razu: 0 z 22 kategorii w GPT-6 (w trzech model nie podał żadnej marki) i 0 z 25 w Gemini. Dwie losowe odpowiedzi na to samo pytanie dzielą średnio 63% marek w GPT-6 i 73% w Gemini. Z włączonym wyszukiwaniem GPT-6 jest jeszcze mniej stały: wspólnych marek 53%, wspólnych cytowanych domen 42%.
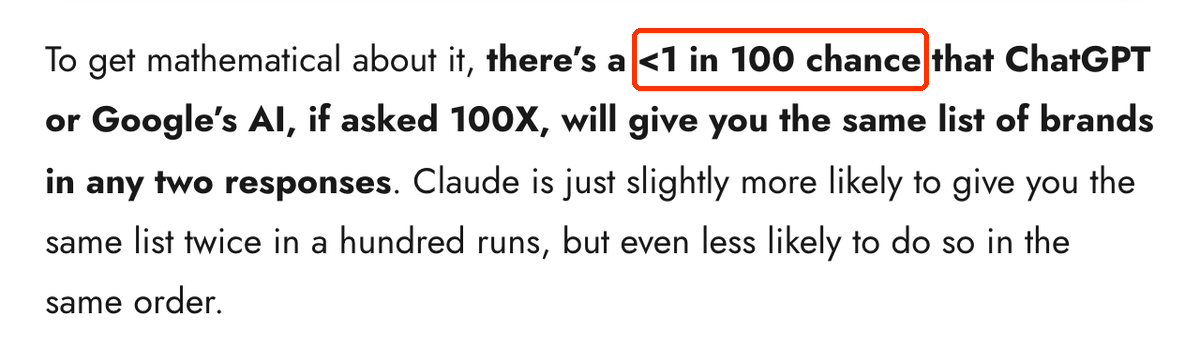
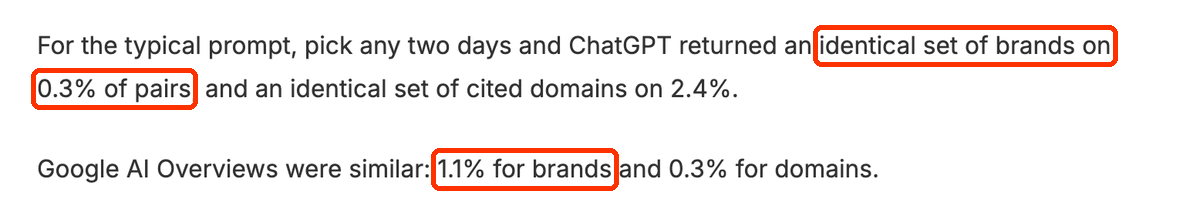
Za granicą wychodzi to samo. W badaniu SparkToro 600 osób zadało 12 promptów w ChatGPT, Claude i AI Overviews łącznie 2961 razy. Szansa, że w 100 zapytaniach dwie odpowiedzi podadzą tę samą listę marek, wyszła mniejsza niż 1 na 100, a w tej samej kolejności — mniejsza niż 1 na 1000. Detailed sprawdzał ponad 1300 promptów codziennie i dla dwóch losowych dni dostał identyczny zestaw marek w 0,3% par w ChatGPT i 1,1% w AI Overviews.
Rdzeń i ogon: jak naprawdę wygląda wynik
Zmienność nie oznacza chaosu: część marek pada prawie zawsze, część raz na kilka odpowiedzi. W naszym pomiarze w rdzeniu (marka w co najmniej 8 z 10 odpowiedzi) było 40% marek wymienianych przez GPT-6 (44 ze 111) i 56% marek Gemini (115 z 207). W ogonie (najwyżej 2 z 10) — 21% i 19%. Uwaga przy porównaniu: Gemini podaje średnio dwa razy więcej marek, więc część jego rdzenia wynika z samej długości listy. To nie znaczy, że Gemini jest „stabilniejszy”.
Najlepiej widać to na jednej kategorii. Przy pytaniu „Gdzie kupić dobre meble do salonu?” Agata, IKEA i VOX wracają w 9 z 10 odpowiedzi GPT-6, a Bonami, Kler czy Meble Wójcik raz albo dwa razy. Gdyby ktoś zrobił jeden zrzut i trafił na odpowiedź z Klerem, zaraportowałby „jesteśmy widoczni w ChatGPT”. Przy kolejnym zrzucie Kleru by nie było.
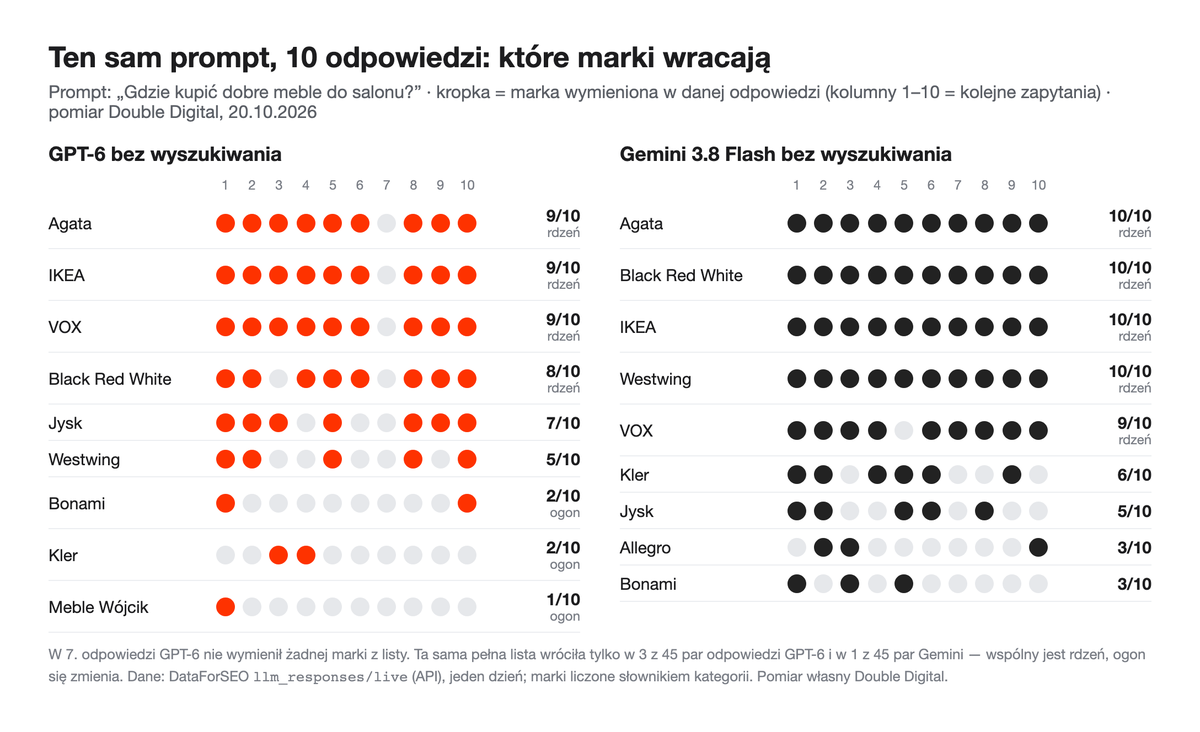
Dlatego „pozycja w ChatGPT” to słaba metryka: kolejność zmienia się jeszcze bardziej niż skład listy (Detailed, SparkToro). Mierz obecność, czyli liczbę odpowiedzi z Twoją marką podzieloną przez liczbę wszystkich odpowiedzi (mention rate).
Jeszcze jedno ograniczenie. Wszystkie te pomiary, nasz też, dotyczą pierwszego pytania w nowej rozmowie. Gdy użytkownik dopisze jeden szczegół („do 2000 zł”), z pierwszej listy zostaje około 28% marek, a przy samym powtórzeniu pytania około 90% (Clovion, pojedynczy pomiar dostawcy). Pierwsze pytanie to punkt odniesienia, nie pełny obraz rozmowy.
Test pamięci modelu z rozdziału marka poza stroną mówi, czy model zna Twoją markę; tu mierzysz, jak często ją wymienia. Jednorazowe zdjęcie stanu na portfelu promptów, z konkurencją i powtórzeniami, robimy w ramach analizy widoczności marki w AI.
Wybierz jedno pytanie, które zadaje Twój klient, bez nazwy Twojej firmy. Zadaj je 10 razy w ChatGPT, za każdym razem w nowej rozmowie, i zapisz marki z każdej odpowiedzi. Policz, w ilu odpowiedziach jesteś: 8–10 to rdzeń, 1–2 to ogon. To test, nie pomiar — pomiar budujesz w lekcjach 3 i 4.
Co mierzyć: wymienienie marki, cytat i link osobno dla ChatGPT, Gemini i AI Overviews
Liczysz cztery rzeczy, każdą osobno i dla każdego silnika osobno: czy marka jest wymieniona z nazwy, czy Twoja strona jest cytowana jako źródło, czy odpowiedź ma klikalny link do Ciebie i czy to, co AI mówi o marce, jest prawdą. Jeden „wynik widoczności w AI” uśrednia silniki, które działają inaczej.
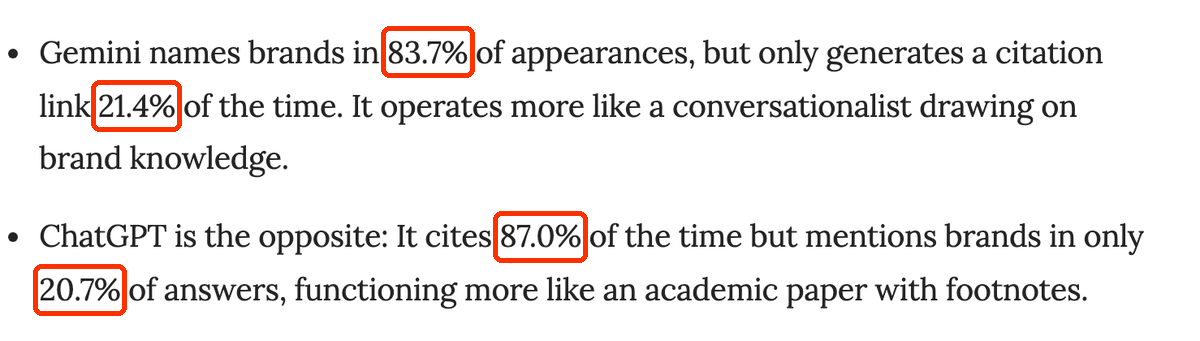
Silniki robią z marką co innego. W pomiarze Kevina Indiga (115 promptów, 14 krajów) Gemini wymieniał markę z nazwy w 83,7% wystąpień, a link-cytat dawał tylko w 21,4%. ChatGPT odwrotnie: cytował w 87,0%, a markę wymieniał w 20,7% odpowiedzi. Tylko 13,2% wystąpień to jednocześnie cytat i wymienienie. Suma jednego i drugiego zrówna więc oba silniki, choć użytkownik zobaczy w Gemini Twoją nazwę, a w ChatGPT przypis.
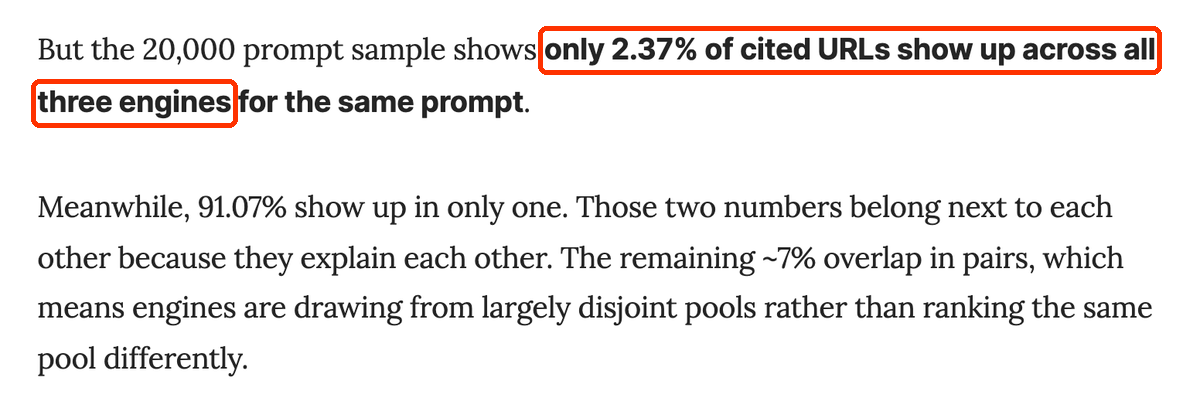
Silniki sięgają też po różne źródła. W drugim zbiorze Indiga (próba 20 tys. promptów, rynek europejski) tylko 2,37% cytowanych adresów pojawiło się przy tym samym prompcie w ChatGPT, Perplexity i AI Overviews naraz, a 91,07% tylko w jednym silniku. Dobra widoczność w AI Overviews nic więc nie mówi o ChatGPT.
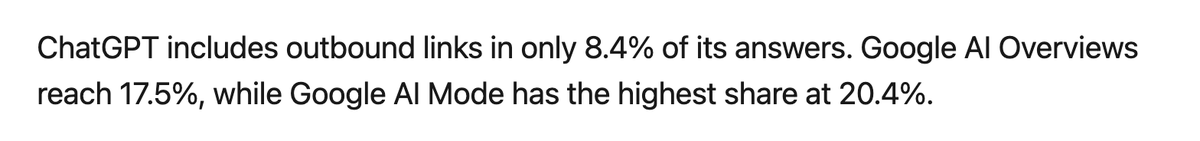
Czwarta rzecz to link w treści odpowiedzi, czyli klikalny odnośnik w tekście, a nie przypis na dole. Według Peec AI (blisko 9 mln odpowiedzi) ma go 8,4% odpowiedzi ChatGPT, 17,5% AI Overviews i 20,4% AI Mode. Od 58% do 71% tych linków prowadzi na stronę główną, a z adresem cytowanym w przypisie pokrywa się tylko w 4–24% przypadków. Cytat buduje zaufanie, ruch daje link — i to często inna strona Twojego serwisu.
Co liczyć w raporcie
| Metryka | Jak liczyć | Gdzie ją widać | Pułapka |
|---|---|---|---|
| Obecność (mention rate) | odpowiedzi z nazwą marki ÷ wszystkie odpowiedzi w portfelu | tekst odpowiedzi | prompty z nazwą marki zawyżają wynik do 100% — licz je osobno |
| Cytat | odpowiedzi z Twoją domeną w źródłach ÷ wszystkie odpowiedzi | przypisy, lista źródeł | narzędzia mylą stronę „w kontekście” modelu ze stroną pokazaną użytkownikowi |
| Link w treści | odpowiedzi z klikalnym linkiem do Ciebie ÷ wszystkie | tekst odpowiedzi | link prowadzi zwykle na stronę główną, cytat na podstronę |
| Udział głosu (share of voice) | Twoje wymienienia ÷ wymienienia wszystkich marek w kategorii | tekst odpowiedzi | zależy od listy konkurentów, którą ułożysz — zamroź ją |
| Poprawność opisu | twierdzenia o marce zgodne z faktami ÷ wszystkie sprawdzone | tekst odpowiedzi | ceny promocyjne i warianty łatwo uznać za błąd |
Model może przeczytać Twoją stronę (źródło w kontekście, ang. grounding), a użytkownikowi pokazać inne źródła. Tracker, który raportuje jedno jako drugie, zawyża widoczność stronami, których nikt nie zobaczył — zapytaj dostawcę, co liczy (lekcja 7).
Ostatnia rubryka bywa pomijana, a w handlu jest kluczowa: czy AI podaje o Tobie aktualne ceny i warunki. Zapisuj błędne twierdzenia razem ze źródłem, z którego model je wziął — to lista stron do poprawienia. Skąd AI bierze źródła, opisuje rozdział jak AI wybiera źródła, a czym różnią się AI Overviews od AI Mode — rozdział AI Overviews i AI Mode.
Weź swój ostatni raport „widoczności w AI” (z narzędzia albo od agencji) i sprawdź, czy rozdziela silniki i czy osobno pokazuje wymienienia, cytaty i linki. Jeśli widzisz jedną liczbę dla „AI”, poproś o rozbicie albo o surowe odpowiedzi.
Jak dobrać prompty do monitorowania widoczności marki w AI: portfel z fraz Search Console
Prompty bierzesz z własnych danych, nie z głowy: z niebrandowych fraz w Search Console, z pytań klientów i z segmentów, które obsługujesz. Układasz je według etapów decyzji — obawy, porównanie, wybór — i trzymasz prompty z nazwą marki w osobnej grupie. Na start wystarczy 30–50 promptów po polsku, zamrożonych na cały okres porównania.
Peec AI proponuje na start 10–20 promptów „świadomości” (obawy wobec kategorii), 20–30 promptów „rozważania” (ogólnych i dla segmentów) i 30 dni śledzenia — rozsądny rząd wielkości, ale to rama dostawcy, nie wynik badania. AirOps zauważył, że marki monitorują zwykle prompty 6–7-słowne, a ludzie częściej piszą do AI pytania dziesięciowyrazowe i dłuższe. Część portfela pisz więc pełnymi zdaniami, z kryteriami klienta.

Portfel w czterech krokach
- Frazy z Search Console bez marki. Wyeksportuj zapytania z ostatnich 3 miesięcy, odfiltruj nazwę firmy i zamień najczęstsze tematy w pytania.
- Pytania z rozmów z klientami. Dopisz 5–10 pytań, które słyszą handlowcy, support albo które przychodzą formularzem. Tych nie ma w żadnym narzędziu do fraz.
- Podział na etapy i grupa brandowa. Świadomość („czy warto…”, „jakie są ryzyka…”), porównanie („X czy Y”, „jakie są najlepsze…”), wybór („kogo polecasz w Poznaniu…”). Prompty z nazwą Twojej marki trzymaj osobno: z definicji dają 100% obecności i zawyżają średnią.
- Zamrożenie. Ten sam zestaw promptów przez cały okres porównania. Każda zmiana promptów to nowy punkt startu, a nie „wzrost” albo „spadek”.
Przykład na danych z naszej Search Console (zapytania wokół widoczności marki w AI). To pokaz metody, nie wynik:
| Etap | Prompt w portfelu | Skąd fraza | Marka w prompcie |
|---|---|---|---|
| Świadomość | Dlaczego warto sprawdzać, czy ChatGPT poleca moją firmę, i od czego zacząć? | GSC: „dlaczego warto monitorować widoczność marki w wyszukiwarkach ai” | nie |
| Świadomość | Jak sprawdzić, czy ChatGPT i Gemini wymieniają moją markę, kiedy klient pyta o usługi takie jak moje? | GSC: „jak sprawdzić widoczność marki w ai?” | nie |
| Porównanie | Ile kosztuje miesięczny monitoring widoczności marki w ChatGPT i Gemini w Polsce i od czego zależy cena? | GSC: „ile kosztuje audyt widoczności w wyszukiwarkach ai” | nie |
| Wybór | Kto w Polsce robi audyt widoczności marki w AI i pokaże twarde dane, a nie ogólniki? | GSC: zapytanie pisane pełnym zdaniem, prawie słowo w słowo | nie |
| Wybór, lokalnie | Jaką agencję od widoczności w AI polecasz w Warszawie dla firmy usługowej? | GSC: „audyt widoczności ai warszawa” + segment | nie |
| Marka | Co wiesz o Double Digital i czym się zajmuje? | grupa brandowa | tak — liczona osobno |
Dwie zasady. Po pierwsze, prompty po polsku: pula źródeł i lista marek zmieniają się prawie całkowicie ze zmianą języka pytania (Chen i in.), więc tracker na angielskich promptach nic nie mówi o polskich odpowiedziach. Po drugie, prompty z nazwą miasta trzymaj osobno, bo odpowiedzi na nie mają inne źródła. Dłuższe pytania wywołują też więcej podzapytań — opisujemy to w rozdziale fan-out i architektura.
Wyeksportuj z Search Console zapytania z 3 miesięcy, usuń te z nazwą firmy i wybierz 25 tematów. Przepisz je na pytania po polsku, dopisz 5 pytań od klientów i oznacz etap. Masz arkusz 30 promptów — to Twój portfel startowy.
Jak monitorować widoczność marki w odpowiedziach AI: ile promptów i powtórzeń odróżnia zmianę od szumu
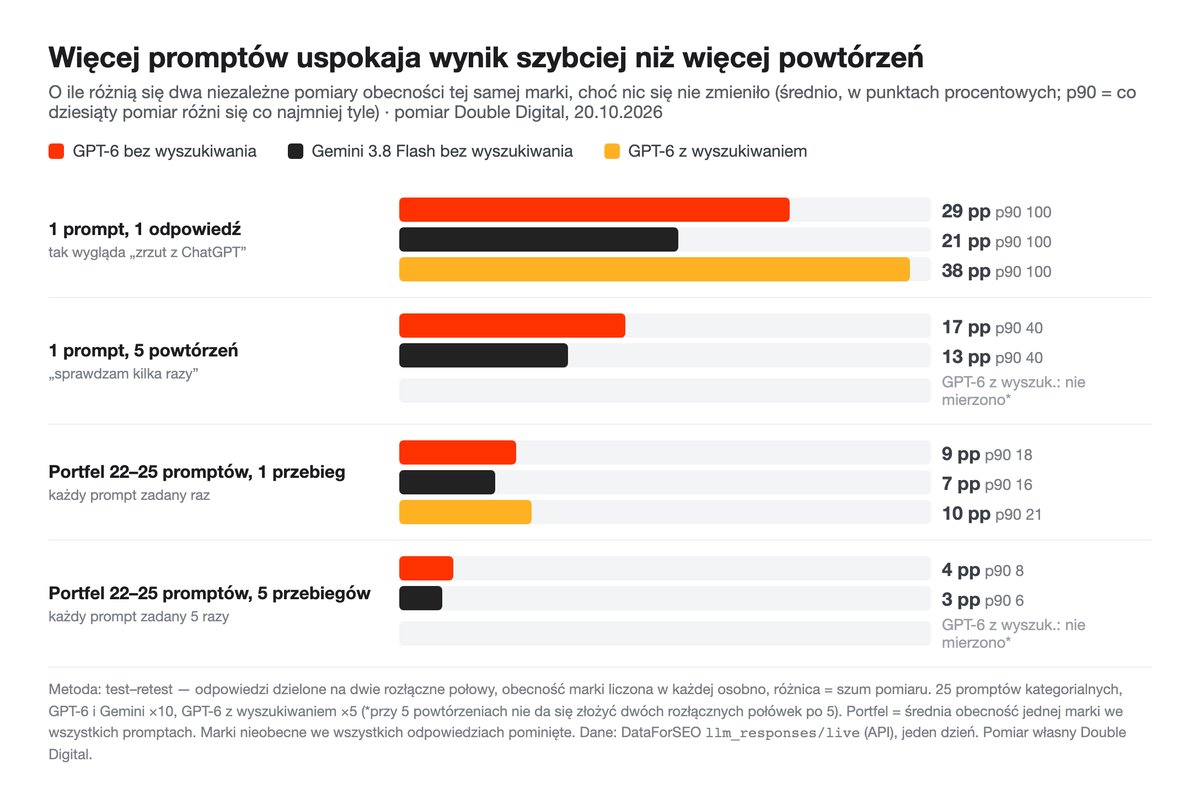
Więcej promptów daje więcej niż więcej powtórzeń. W naszym pomiarze obecność marki w jednym prompcie, zmierzona dwa razy po 5 powtórzeń, różniła się średnio o 17 pp w GPT-6 i 13 pp w Gemini, choć nic się nie zmieniło. Portfel 22–25 promptów — o 7–10 pp przy jednym przebiegu i 3–4 pp przy pięciu. Zmiana mniejsza niż ten szum to brak zmiany.
Jak to zmierzyliśmy? Odpowiedzi na to samo pytanie podzieliliśmy na dwie rozłączne połowy i w każdej policzyliśmy, w ilu odpowiedziach pada dana marka. Świat się między połowami nie zmienił, więc każda różnica to szum pomiaru (test–retest):
- 1 prompt, 1 odpowiedź (zrzut ekranu): średnio 29 pp w GPT-6, 21 pp w Gemini, 38 pp w GPT-6 z wyszukiwaniem. Co dziesiąty pomiar to różnica 100 pp, czyli „jest” kontra „nie ma”.
- 1 prompt, 5 powtórzeń: 17 pp i 13 pp, co dziesiąty pomiar o 40 pp i więcej.
- Portfel 22–25 promptów, 1 przebieg: 9 pp (GPT-6), 7 pp (Gemini), 10 pp (GPT-6 z wyszukiwaniem).
- Portfel, 5 przebiegów: 4 pp i 3 pp.
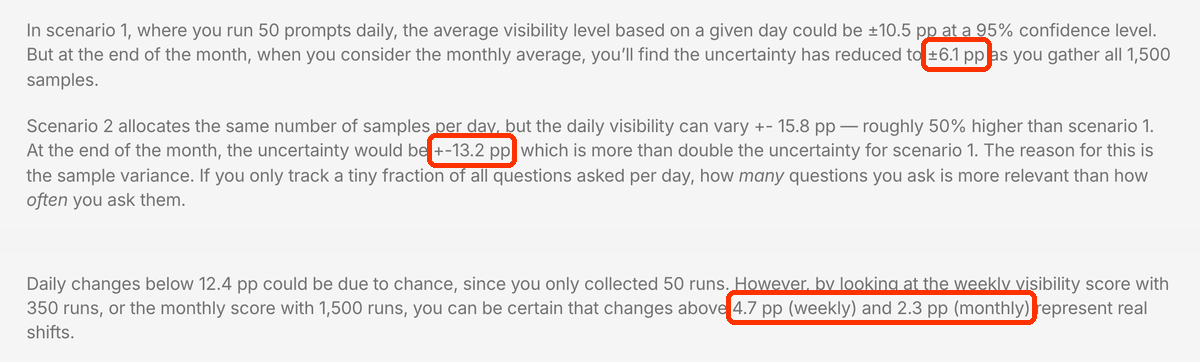
Ten sam rząd wielkości daje model statystyczny Peec AI: 50 promptów zadawanych raz dziennie daje w skali miesiąca niepewność ±6,1 pp, a 10 promptów zadawanych pięć razy dziennie — ±13,2 pp, choć liczba odpowiedzi jest ta sama. Przy poziomie widoczności liczy się więc, ile różnych pytań zadajesz. Do wykrycia zmiany na tym samym zestawie liczy się z kolei łączna liczba odpowiedzi: przy 50 promptach dziennie zmiana jest prawdziwa dopiero powyżej 4,7 pp w tygodniu i 2,3 pp w miesiącu. Model zakłada niezależne przebiegi i stałą widoczność, więc to rząd wielkości, nie norma.
Co z tego wynika dla Twojego pomiaru
- „Sprawdzam trzy razy” to za mało. Trzy przebiegi jednego pytania, polecane w części poradników, myliły się w naszym pomiarze średnio o 21 pp (GPT-6) i 16 pp (Gemini). Nawet zalecenie SparkToro (60–100 powtórzeń jednego promptu) to wskazówka autora bez rachunku.
- Mierz portfel i porównuj okresy. Średnia obecność na 30–50 promptach, odczytywana co tydzień, a oceniana w skali miesiąca.
- Ustal próg, zanim zobaczysz wynik. Pojedynczy odczyt portfela myli się średnio o 7–10 pp, więc różnica 3 pp między dwoma tygodniami to szum. Średnia z pięciu odczytów myli się o 3–4 pp, a co dziesiąta o 6–8 pp — zmianę uznawaj dopiero powyżej tego pułapu.
- Porównuj siebie z sobą i z konkurentami na tych samych pytaniach. „Powyżej 50% to dobry wynik” nic nie znaczy bez portfela i silnika.
Ograniczenia naszego pomiaru: odpowiedzi przez API (bez historii i personalizacji użytkownika), jeden dzień, 25 promptów pisanych przez nas, marki nieobecne we wszystkich odpowiedziach pominięte (to lekko zaniża szum ogona). Nasze warianty mają różną liczbę odpowiedzi, więc tezę „przy tej samej liczbie odpowiedzi lepiej dołożyć prompty niż powtórzenia” opieramy na zgodności z modelem Peec, który porównuje równe próby. Stały pomiar na portfelu promptów, z progiem szumu w raporcie, prowadzimy w ramach usługi monitoringu widoczności w AI.
W arkuszu z portfelem dodaj kolumny dla każdego tygodnia i silnika. Wpisuj 1, jeśli marka padła, 0, jeśli nie. Licz średnią z całego portfela, a nie z pojedynczych pytań, i porównuj miesiąc do miesiąca. Zmianę mniejszą niż szum Twojego odczytu traktuj jako brak zmiany.
Śledzenie widoczności w Google AI Overviews: jak sprawdzać cytowania i jak szybko się zmieniają
Cytaty w AI Overviews sprawdzasz na stałym zestawie fraz, zawsze z datą odczytu, co 1–2 tygodnie. Zmienia je przede wszystkim czas, nie przypadek: w naszym pomiarze 172 polskich fraz dwa odczyty w odstępie 15 minut zostawiły 88% adresów źródeł, a odczyty w odstępie 8 dni — 67%. Pojedynczy odczyt jest więc wiarygodny na dziś, ale nie na przyszły tydzień.
Wzięliśmy 172 frazy z AI Overview z pomiaru w rozdziale 01 i zapisaliśmy adresy wszystkich źródeł przeglądu. Dwa odczyty 20.10 w odstępie około 15 minut: 88% adresów z pierwszego odczytu było też w drugim, a 87 ze 112 zestawów źródeł było identycznych. Odczyt z 12.10 wobec odczytu z 20.10: zostało 67% adresów, identyczny był tylko 1 zestaw ze 108, a na 14 frazach przegląd pojawił się albo zniknął.
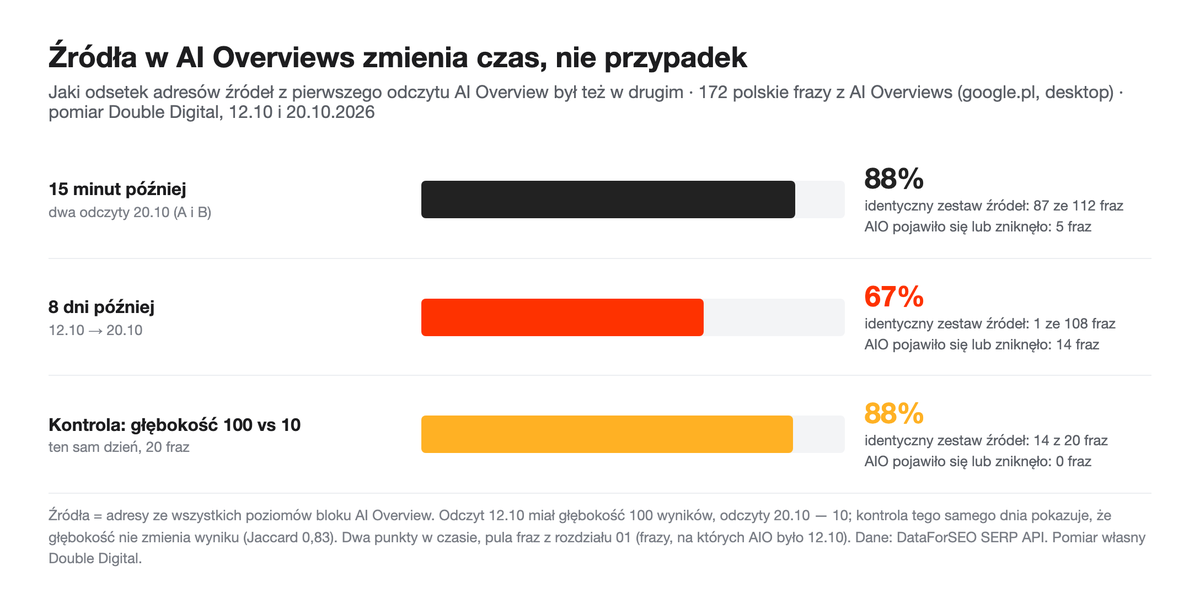
Czy to nie artefakt ustawień? Odczyt z 12.10 pobierał 100 wyników, odczyty z 20.10 — 10. Kontrola tego samego dnia na 20 frazach (100 wobec 10 wyników) dała prawie te same źródła: 14 z 20 zestawów identycznych, podobieństwo 0,83, zero pojawień i zniknięć. Różnicę po 8 dniach robi więc czas.
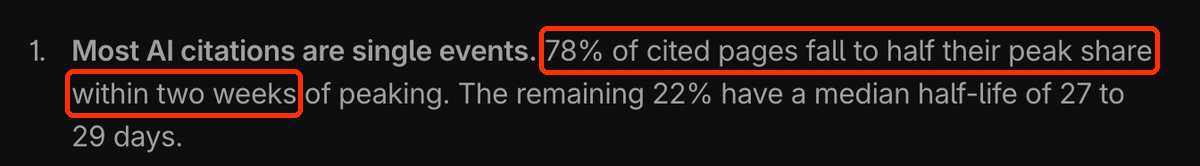
Inni widzą to samo. Profound przeanalizował 883 tys. stron w kilku silnikach: 78% cytowanych stron spada do połowy szczytowego udziału w ciągu dwóch tygodni od szczytu, a pozostałe 22% ma medianę półtrwania 27–29 dni. Cytat w AI to częściej zdarzenie niż trwały stan.
Jak sprawdzać cytaty w AI Overviews
- Stały zestaw fraz. 30–100 fraz z Search Console, na których pokazuje się przegląd, ten sam przez cały okres porównania.
- Odczyt co 1–2 tygodnie, z datą. Zapisuj listę adresów źródeł dla każdej frazy, a nie tylko „jestem / nie ma mnie”.
- Licz odsetek, który został. Ile Twoich adresów z poprzedniego odczytu jest w obecnym i ile doszło nowych.
- API kontroluj przeglądarką. Wynik z API bywa inną wersją wyników niż ta, którą widzi użytkownik (rozdział 01). Kilka fraz z każdego odczytu sprawdź ręcznie.
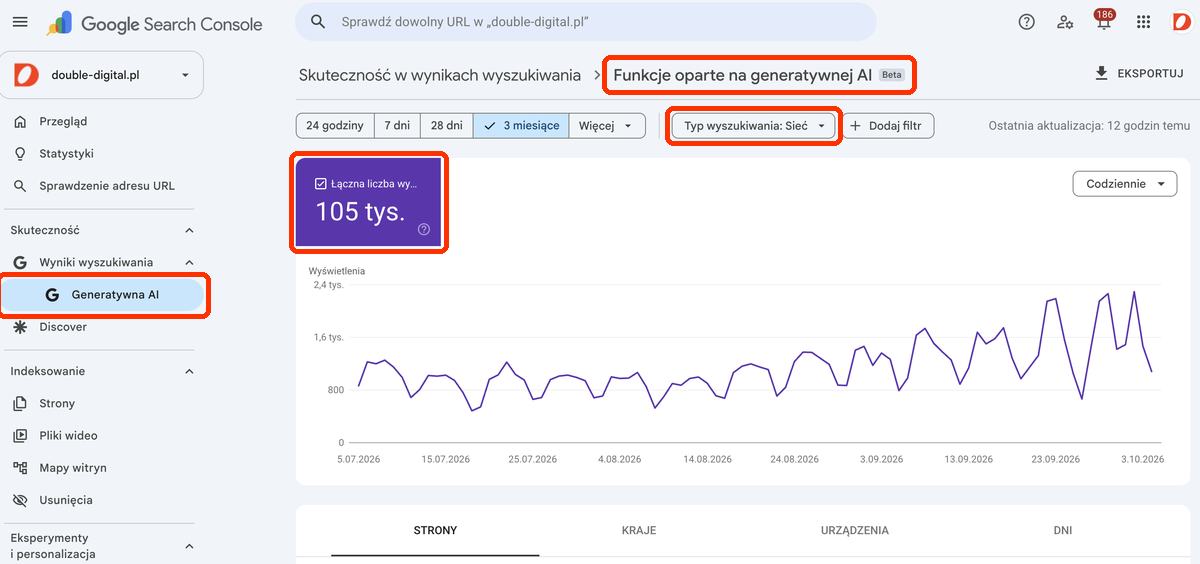
Search Console pomoże częściowo. Raport „Funkcje oparte na generatywnej AI” (Beta) pokazuje wyświetlenia Twoich stron w odpowiedziach AI Google, ale na naszym koncie bez kliknięć i bez API (więcej w rozdziale AI Overviews i AI Mode). Na Search Central Live w Barcelonie Google zapowiedział kolejne dane o wyszukiwaniu z AI, ale bez dat. Podzapytań (fan-outów) AI Overviews w konsoli nie zobaczysz, bo nie pochodzą od użytkowników.
Ograniczenia naszego pomiaru: dwa punkty w czasie, pula fraz z rozdziału 01 i odczyty przez API po 13.09.2026, odkąd Google części zapytań automatycznych podsuwa zmienione wyniki organiczne (to dotyczy organiku; nie wiemy, czy także przeglądów). Dlatego piszemy „po 8 dniach”, a nie „co tydzień”. Czy świeżość treści pomaga utrzymać cytat, opisujemy w rozdziale świeżość treści.
Wybierz 30 fraz z Search Console, przy których Google pokazuje przegląd AI. Dziś zapisz dla każdej listę źródeł, za tydzień zrób to samo. Policz, ile Twoich adresów zostało. W naszym pomiarze po 8 dniach zostawały dwie trzecie — taki wynik to normalna rotacja, nie spadek.
utm_source=chatgpt.com i ruch z AI w GA4: gdzie go szukać i czego nie pokaże Search Console
utm_source=chatgpt.com to znacznik, który ChatGPT dokleja do linków w odpowiedziach, a GA4 zapisuje go jako źródło sesji. Ruch z asystentów AI znajdziesz filtrem po źródle, a nie po kanale: kanał „AI Assistant” z maja 2026 nie działa wstecz i nie obejmuje Perplexity. Część wpływu AI nie zostawia źródła i widać ją tylko pośrednio.
Kanał „AI Assistant” a filtr po źródle
13 maja 2026 Google ogłosił w informacjach o wersji GA4 kanał „AI Assistant”: gdy strona odsyłająca jest na liście asystentów AI, GA4 ustawia medium ai-assistant i przypisuje sesję do nowego kanału. Tej listy Google nie publikuje. Jako przykłady padają ChatGPT, Gemini, Claude, Deepseek, Copilot i Grok, ale Perplexity nie pada w żadnym oficjalnym tekście. AI Overviews i AI Mode zostają w Organic Search.
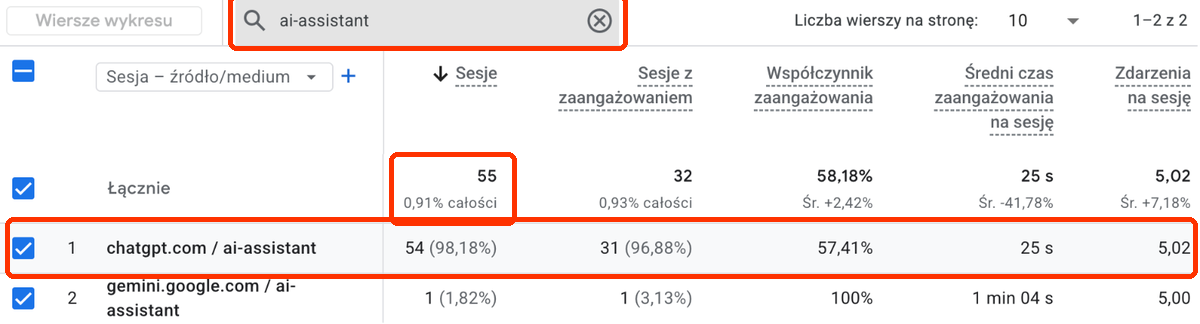
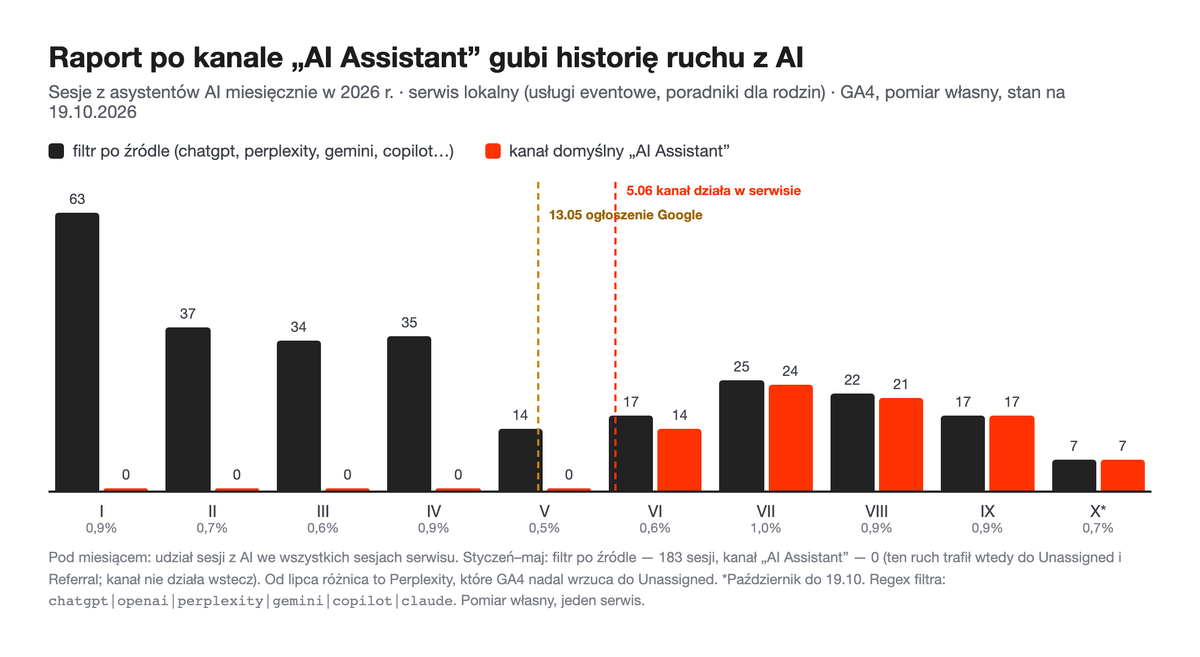
W badanym serwisie ruch z chatgpt.com trafia do kanału „AI Assistant” od 5 czerwca 2026, wcześniej lądował w Unassigned albo Referral. Raport po kanałach pokazuje więc za styczeń–maj 2026 zero sesji z AI, a filtr po źródle — 183. Kanał nie przepisał historii, a Google nie deklaruje, że to zrobi. Perplexity nadal wpada do Unassigned: w ostatnich 90 dniach kanał pokazuje 55 sesji, filtr po źródle 57.
Dlatego do raportów używaj filtra po źródle sesji, z typem dopasowania „częściowo pasuje do wyrażenia regularnego”:
chatgpt|openai|perplexity|gemini|copilot|claudeBez „.com”, bo przy utm_source=chatgpt GA4 zapisuje źródło jako gołe „chatgpt”. Przy typie „pasuje do wyrażenia regularnego” (całe źródło) dopisz na początku i końcu .*. Kanał „AI Assistant” zostaw do szybkiego podglądu od czerwca 2026. O samym narzędziu więcej w słowniku: Google Analytics 4.
Skala bywa mała i to też jest wynik. W badanym serwisie asystenci AI dali 57 z 6 095 sesji w 90 dni (0,9%): 54 z ChatGPT, 2 z Perplexity, 1 z Gemini. W całym 2026 udział trzyma się 0,5–1,0% miesięcznie — sesje z AI spadają razem z całym ruchem serwisu.
Na którą stronę trafia ruch z AI
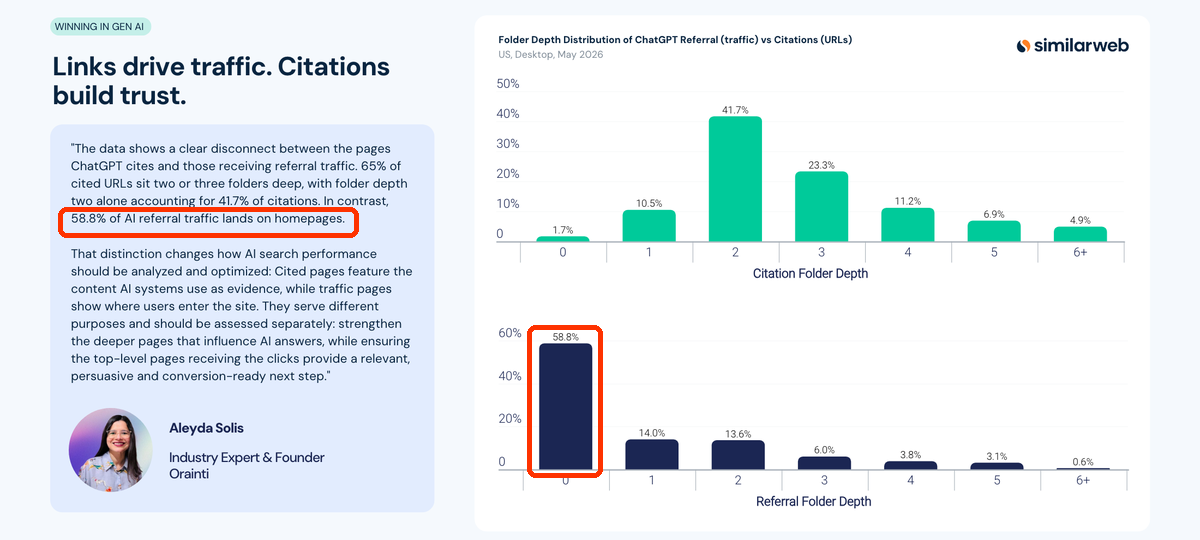
Tu dane się kłócą. Similarweb (USA, desktop, maj 2026) podaje, że 58,8% ruchu z ChatGPT trafia na stronę główną, choć cytowane adresy leżą zwykle dwa–trzy foldery w głąb; podobnie wychodzi Peec AI dla linków w treści (lekcja 2). W naszym serwisie lokalnym jest odwrotnie: 0 z 57 sesji z AI zaczęło się na stronie głównej, a 27 z 57 (47%) na jednym poradniku. Reszta trafiła na inne poradniki, rankingi atrakcji i strony usług w miastach.
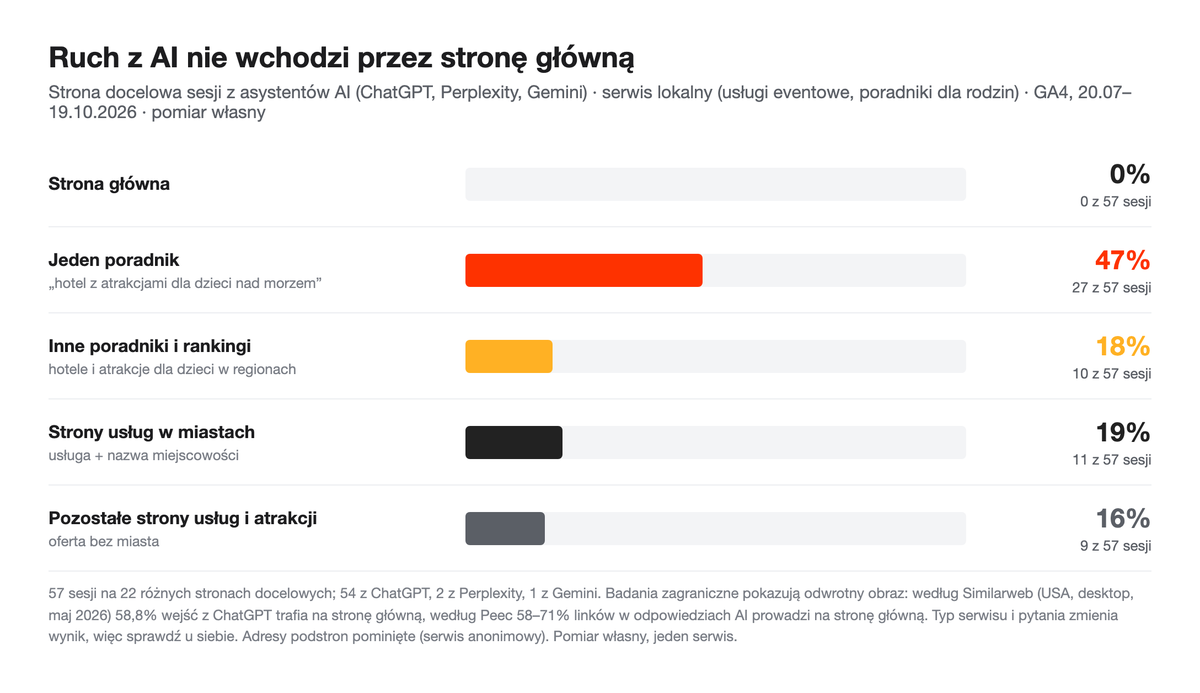
Wyjaśnienie jest prawdopodobnie w typie serwisu: badania zagraniczne dotyczą głównie pytań o marki, gdzie AI odsyła na stronę marki, a serwis poradnikowy odpowiada na konkretne pytania, więc AI linkuje do konkretnej odpowiedzi. Nie zakładaj więc, gdzie wchodzi ruch z AI. Sprawdź strony docelowe z filtrem po źródle i zadbaj, żeby prowadziły dalej — do oferty albo kontaktu.
Czego nie pokaże Search Console i co zrobić zamiast tego
Kliknięcia z AI Overviews i AI Mode GA4 liczy jako Organic Search, a wejścia z aplikacji mobilnych bez strony odsyłającej mogą trafić do Direct (Peec AI). Search Console nie ma osobnych danych o asystentach AI. Zostają ślady pośrednie:
- Frazy brandowe w GSC. Działają na dużej skali. W badanym serwisie jedyne zapytanie brandowe miało 318 wyświetleń w 90 dni i było płaskie przez cały 2026 r. — za mało, żeby zobaczyć wpływ AI.
- Pole „skąd o nas wiesz” w formularzu z odpowiedzią „ChatGPT / inny asystent AI”. Najtańszy pomiar, łapie też polecenia bez kliknięcia.
- Bing Webmaster Tools. Raport z zapytaniami, przy których AI Binga cytuje Twoje strony, z liczbą cytowań (stan na październik 2026) — dane jednego silnika, ale z prawdziwych zapytań.
Które strony czytają same boty AI, pokażą logi serwera (rozdział boty AI i llms.txt).
Czy ruch z AI rośnie kosztem wyszukiwarki, opisujemy w rozdziale Akademii SEO SEO w erze AI.
W GA4 otwórz Pozyskiwanie ruchu, ustaw wymiar „Sesja – źródło/medium” i dodaj filtr źródła z wyrażeniem regularnym z ramki wyżej. Porównaj wynik z kanałem „AI Assistant” za ten sam okres, a potem dodaj wymiar „Strona docelowa”.
Narzędzia do monitoringu widoczności AI (Peec, Otterly, Profound, Ahrefs Brand Radar): co sprawdzić przed zakupem
Zanim zapłacisz, zadaj dostawcy sześć pytań z listy niżej. Najważniejsze dwa: czy mierzy przez API, czy przez aplikację, którą widzi klient, i ile odpowiedzi zbiera na jeden prompt. Rankingu narzędzi tu nie ma, bo każde odpowiada na te pytania inaczej, a dobór zależy od Twojego portfela.
Dlaczego pierwsze pytanie brzmi „API czy aplikacja”
Narzędzie, które pobiera odpowiedzi przez API modelu, może mierzyć inny produkt niż ten, z którego korzysta Twój klient. 5 promptów z naszego pomiaru zadaliśmy w aplikacji chatgpt.com (bez logowania, z polskiego IP). Aplikacja sama włączyła wyszukiwanie we wszystkich 5 przypadkach i podała średnio 3,8 marki, a GPT-6 przez API z wyszukiwaniem — 1,8 (bez wyszukiwania 2,8). Przy pytaniu o hosting dla WordPressa aplikacja wymieniła cyber_Folks, LH.pl i dhosting, a Hostingera, którego API z wyszukiwaniem podało w 4 z 5 odpowiedzi, nie wymieniła wcale.
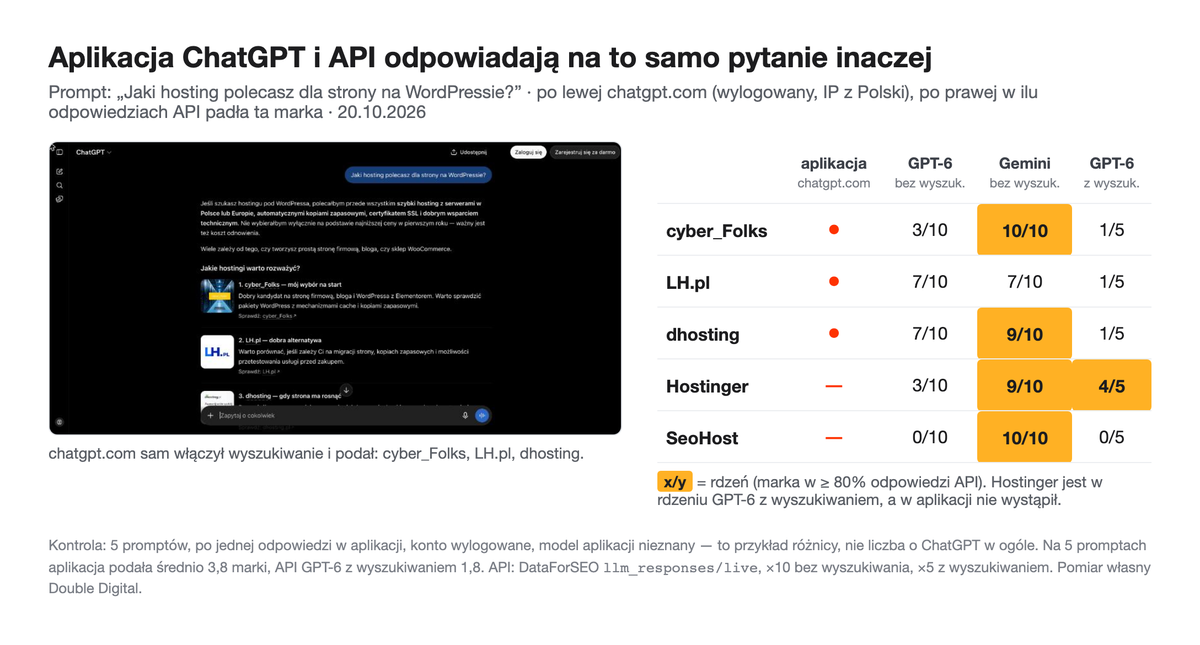
To przykład, nie liczba o ChatGPT w ogóle: 5 promptów, po jednej odpowiedzi w aplikacji, konto niezalogowane, nieznany model po stronie aplikacji, a konto z historią rozmów może dostać jeszcze inną listę. Wystarczy jednak, żeby zapytać dostawcę o metodę.
Sześć pytań do dostawcy
- API czy aplikacja? I dla którego silnika — część narzędzi miesza oba sposoby.
- Ile przebiegów na prompt i jak często? Jedna odpowiedź na prompt dziennie to jeden rzut kostką; szum gasi dopiero duży portfel i średnia z wielu dni (lekcja 4).
- Polska i język polski? Kraj jako ustawienie, a nie tylko język interfejsu.
- Co dokładnie liczy? Wymienienia, cytaty i linki osobno, dla każdego silnika osobno (lekcja 2), a nie jedną liczbę „AI visibility”.
- Eksport pełnych odpowiedzi? Bez surowego tekstu nie sprawdzisz wyniku ani błędnych twierdzeń o marce.
- Cena i jednostka? Za prompt, za prompt × silnik, za odpowiedź?
Co deklarują dostawcy (stan na 20.10.2026)
Kolejność alfabetyczna, bez ocen, tylko to, co dostawca pisze na własnych stronach. „Nie zadeklarowano” znaczy, że nie znaleźliśmy tej informacji, a nie, że funkcji nie ma. Oferty często się zmieniają — przed zakupem sprawdź stronę narzędzia.
| Narzędzie | Silniki | API czy aplikacja | Powtórzenia | Polska | Eksport odpowiedzi | Cena wejścia |
|---|---|---|---|---|---|---|
| Ahrefs Brand Radar | AI Overviews, AI Mode, ChatGPT, Perplexity, Gemini, Copilot (+ Claude we własnych promptach) | aplikacja („publicznie dostępne interfejsy”) | indeks: ponowny test co miesiąc; własne prompty: dziennie, tygodniowo lub miesięcznie | tak, kod kraju pl we własnych promptach | tak, przez API | własne prompty w płatnych planach Ahrefs (Lite: 5 promptów); ceny dodatków na stronie niejednoznaczne |
| Otterly.AI | ChatGPT, AI Overviews, Perplexity, Copilot; Claude, AI Mode, Gemini jako dodatki | aplikacja (poza Claude przez API) | codziennie | tak, dla wszystkich silników | tak, przez API | od 29 USD/mies. (15 promptów) |
| Peec AI | ChatGPT, AI Mode, AI Overviews, Copilot, Gemini i inne; Perplexity w Enterprise | mieszane, oznaczone dla każdego silnika | codziennie, 1 odpowiedź na prompt × silnik × dzień | tak, bez dopłaty | tak, przez API i CSV | od 95 USD/mies. (50 promptów, 3 silniki) |
| Profound | wersja próbna: ChatGPT, Gemini, AI Overviews; Enterprise do 9 silników | aplikacja („z przeglądarki”) | codziennie, wynik jako średnia z odpowiedzi | Polski nie wymieniono (30+ języków) | tak, w Enterprise (CSV, JSON, API) | wersja próbna bezpłatna; Enterprise wycena indywidualna |
| Semrush AI Visibility Toolkit | ChatGPT, Google AI, Gemini, Perplexity | „nie przez API modeli” | codziennie lub co tydzień, zależnie od raportu | tak | nie zadeklarowano (CSV raportów) | 99 USD/mies. (25 promptów) |
| SE Ranking AI Search Toolkit | AI Overviews, AI Mode, ChatGPT, Gemini (Perplexity tylko w części opisów) | aplikacja | codziennie | Polski nie wymieniono | nie zadeklarowano | plan Core 129 USD/mies. + dodatek AI Search 89 USD/mies. |
| Senuto LLM Monitor (wczesny dostęp) | ChatGPT, Gemini, Perplexity, Copilot, AI Mode, AI Overviews, Grok (API) | nie zadeklarowano | cyklicznie, „liczymy wynik na powtórzeniach” | tak, monitoring per kraj | tak (CSV, surowe odpowiedzi, API) | wycena indywidualna za prompt |
Wynik liczony na wielu odpowiedziach na ten sam prompt deklarują wprost tylko Senuto i Profound; Senuto jako jedyne nie podaje metody zbierania. Część dostawców podaje różne listy silników na różnych stronach, więc zapisuj datę sprawdzenia.
Arkusz czy narzędzie
Do około 30 promptów w 1–2 silnikach z odczytem raz w tygodniu wystarczy arkusz i godzina pracy. Narzędzie opłaca się przy kilku silnikach, kilkudziesięciu promptach i częstszych odczytach, gdy ręczne zbieranie zajmuje więcej czasu niż analiza. Jeśli wolisz zlecić pomiar, robimy jednorazową analizę widoczności w AI i stały monitoring widoczności w AI na portfelu promptów z progiem szumu.
Wyślij dostawcy sześć pytań z listy wyżej i poproś o eksport surowych odpowiedzi z wersji próbnej. 3 prompty z eksportu zadaj ręcznie w aplikacji, z której korzysta Twój klient. Jeśli listy marek wyraźnie się różnią, wiesz, co naprawdę mierzy narzędzie.
FAQ — najczęściej zadawane pytania o pomiar widoczności w AI
- Jak sprawdzić widoczność marki w AI za darmo?
Ręcznie, w arkuszu: 20–30 promptów z Search Console i rozmów z klientami, zadawanych raz w tygodniu w nowych rozmowach w ChatGPT i Gemini. Wpisujesz 1, jeśli marka padła, 0, jeśli nie, i liczysz średnią z portfela osobno dla każdego silnika. Darmowe „checkery” robią zwykle jeden przebieg, więc dają test, a nie pomiar.
- Ile kosztuje monitoring widoczności w AI?
Koszt zależy od liczby promptów, silników i częstotliwości odczytu. Najtańsze publiczne plany narzędzi kosztowały w październiku 2026 od 29 do 129 USD miesięcznie za 15–100 promptów, a plany dla firm są wyceniane indywidualnie (tabela w lekcji 7). Monitoring prowadzony przez agencję wyceniamy po ustaleniu portfela promptów — szczegóły na stronie monitoringu widoczności w AI.
- Czy istnieje pozycja w ChatGPT?
Nie w sensie stałym, jak w Google. Kolejność marek zmienia się między odpowiedziami jeszcze bardziej niż ich skład, więc mierzy się obecność: w ilu odpowiedziach marka pada. Jeśli chcesz śledzić kolejność, licz udział odpowiedzi, w których jesteś na pierwszym miejscu, a nie „średnią pozycję”.
- Jak często mierzyć widoczność w AI?
Portfel promptów odczytuj co tydzień, a oceniaj w skali miesiąca, z progiem szumu. Cytaty w AI Overviews sprawdzaj co 1–2 tygodnie, zawsze z datą. Częściej warto mierzyć ChatGPT, bo cytaty trzyma krócej niż Perplexity.
- Jaki wynik widoczności w AI jest dobry?
Nie ma uniwersalnej normy. Wynik zależy od portfela promptów, silnika i tego, ile marek działa w Twojej kategorii. Liczy się trend w czasie i udział względem konkurencji na tych samych pytaniach. Hasła typu „powyżej 50% to dobry wynik” nic nie znaczą bez portfela i progu szumu.
Pomiar widoczności w AI w ośmiu zdaniach
- 01Ten sam polski prompt zadany 10 razy ani razu nie dał identycznej listy marek (0 z 22 kategorii w GPT-6, 0 z 25 w Gemini).
- 02Mierz obecność marki w odpowiedziach, a nie „pozycję w ChatGPT” — kolejność zmienia się bardziej niż skład listy.
- 03Wymienienia, cytaty i linki licz osobno dla każdego silnika: Gemini częściej wymienia markę, ChatGPT częściej cytuje.
- 04Portfel 30–50 promptów z niebrandowych fraz Search Console, po polsku, zamrożony na cały okres porównania; prompty z marką osobno.
- 05Więcej promptów daje więcej niż więcej powtórzeń: portfel myli się o 7–10 pp przy jednym przebiegu i 3–4 pp przy pięciu, jeden prompt ×5 o 13–17 pp.
- 06Cytaty w AI Overviews zmienia czas: po 15 minutach zostaje 88% źródeł, po 8 dniach 67%.
- 07Ruch z AI w GA4 filtruj po źródle: kanał „AI Assistant” z maja 2026 nie działa wstecz i nie obejmuje Perplexity.
- 08Przed zakupem narzędzia zapytaj, czy mierzy przez API, czy przez aplikację, i ile odpowiedzi zbiera na prompt.
Ciąg dalszy przewodnika.
SEO, paid media i strategie widoczności w Double Digital