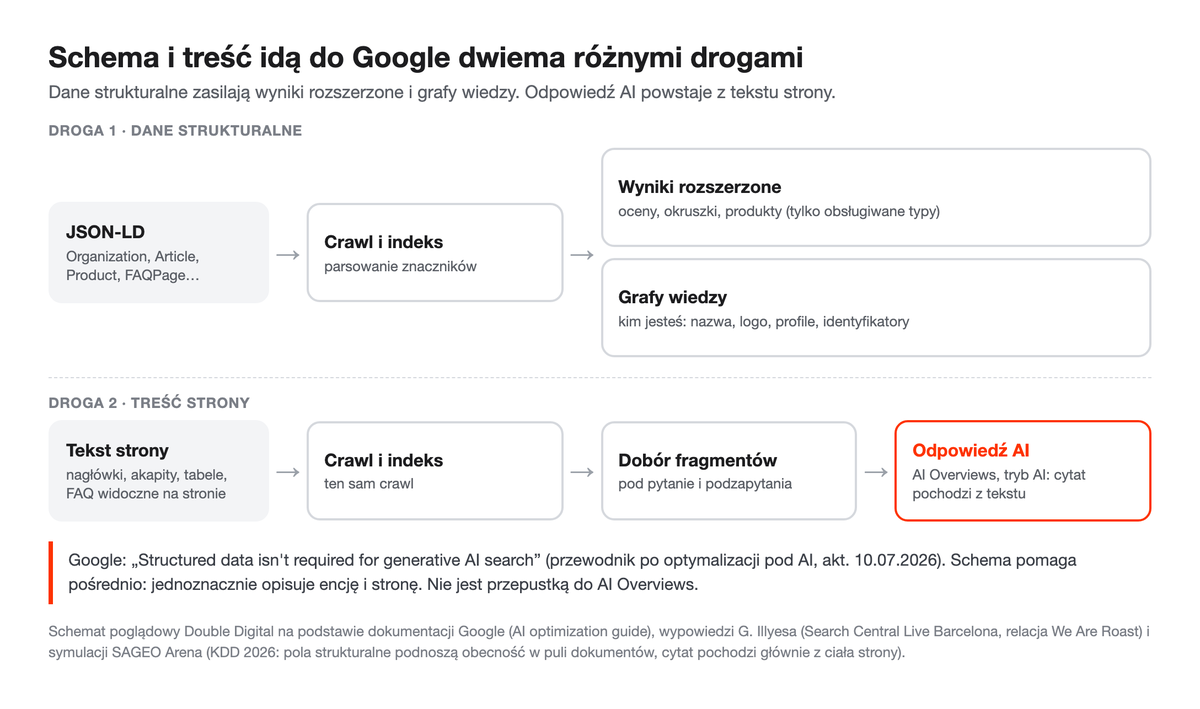
Model językowy nie czyta JSON-LD, gdy pisze odpowiedź, a Google pisze wprost, że dane strukturalne nie są wymagane w wynikach generatywnej AI. Odpowiedź AI powstaje z tekstu strony.
Schema działa pośrednio, przez wyniki rozszerzone i grafy wiedzy: ma jednoznacznie powiedzieć, kim jesteś i co jest na stronie, a nie „wpuścić” Cię do AI Overviews.
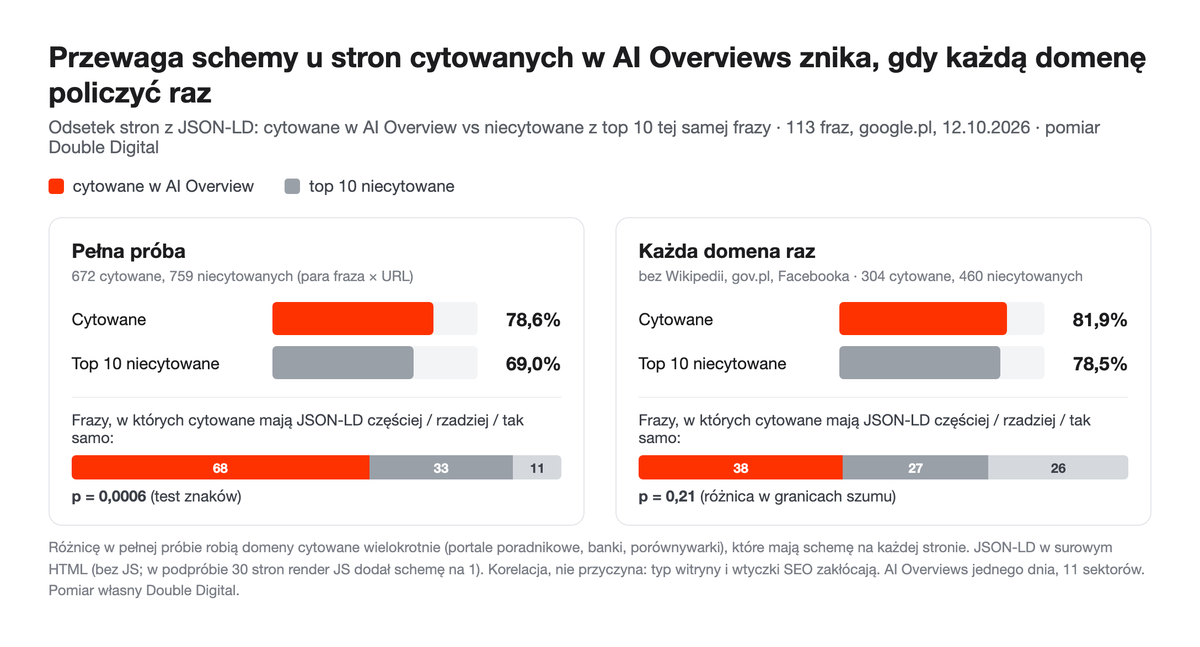
W polskich AI Overviews strony cytowane mają JSON-LD częściej niż niecytowane z top 10 tej samej frazy (78,6% wobec 69,0%), ale gdy każdą domenę policzyć raz, różnica spada do ok. 3 punktów procentowych i mieści się w szumie (pomiar Double Digital, 113 fraz).
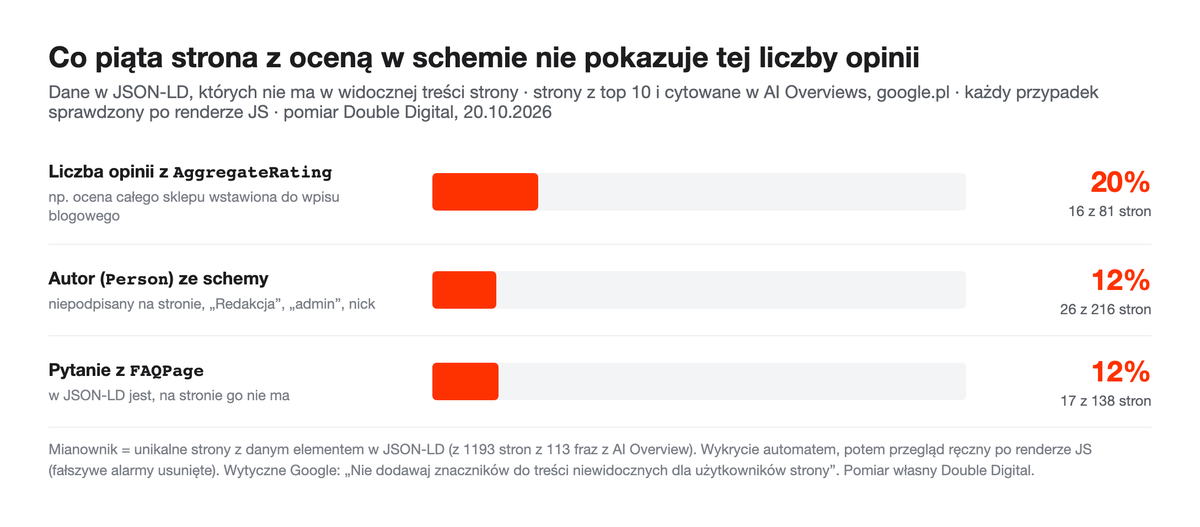
Większym problemem niż brak schemy jest schema zepsuta albo nieprawdziwa. W audycie 5000 witryn 71% ma schemę, a tylko 22% przechodzi test Google bez błędu (Digital Applied). Na polskich stronach co piąta strona z oceną w schemie nie pokazuje tej liczby opinii.
W tym rozdziale sprawdzisz swoją schemę, zrobisz test encji w Knowledge Graph i Wikidata i ułożysz fakty o firmie tak, żeby wszędzie brzmiały tak samo.
Schema nie jest przepustką do AI: odpowiedź powstaje z tekstu strony. Najpierw napraw schemę zepsutą i nieprawdziwą, potem sprawdź encję marki i ułóż te same fakty o firmie wszędzie.
- potwierdzoneco najmniej dwa niezależne pomiary zgodne co do kierunku
- pojedynczy pomiarjeden pomiar z jawną metodą: kierunek wiarygodny, liczba niepewna
- spornepomiary są sprzeczne albo spór o interpretację nie jest rozstrzygnięty
- mechanizmopis działania z dokumentacji platformy, patentu lub dokumentu sądowego
- praktykaobserwacja z pracy albo rekomendacja bez pomiaru
- obaloneliczba bez pokrycia w źródłach, zbita pomiarem albo wycofana przez autora
Ocena dotyczy tezy, nie źródła: dokumentacja Google opisuje mechanizm, ale nie mierzy jego efektu.
Czy AI czyta dane strukturalne? Schema.org i JSON-LD w ChatGPT i AI Overviews
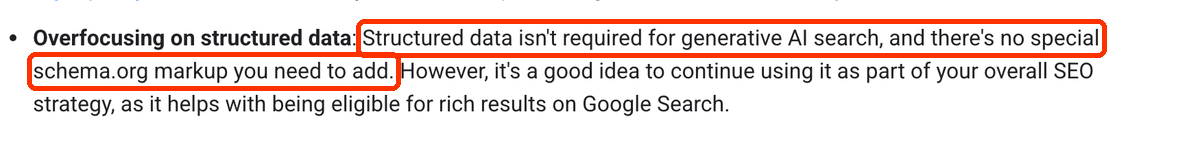
W rozmowie nie. Model językowy nie parsuje JSON-LD w chwili, gdy pisze odpowiedź. Korzysta z tekstu stron, które wyszukiwarka dla niego pobrała i podzieliła na fragmenty. Google pisze to w przewodniku po optymalizacji pod funkcje generatywnej AI: „Structured data isn’t required for generative AI search, and there’s no special schema.org markup you need to add”, czyli dane strukturalne nie są wymagane w wyszukiwaniu z generatywną AI i nie ma specjalnych znaczników schema.org, które trzeba dodać. W tym samym akapicie Google radzi schemę utrzymywać, bo daje kwalifikację do wyników rozszerzonych.
Gary Illyes powiedział w Barcelonie, że wyniki AI nie potrzebują danych strukturalnych, bo biorą tekst strony i z niego budują wynik (relacja We Are Roast). Schema pracuje gdzie indziej. Google używa jej do wyników z elementami rozszerzonymi (oceny, okruszki, produkty) i do zbierania wiedzy o ludziach, firmach i rzeczach. Projekty takie jak Web Data Commons wyciągają dane strukturalne z sieci osobno i zasilają nimi grafy wiedzy (Alhena). Tą drogą schema może dotrzeć do modelu: pośrednio, przez to, co system już wie o Twojej firmie, a nie przez kod czytany w trakcie rozmowy. Czym dokładnie są dane strukturalne, wyjaśniamy w słowniku.
Ta reguła ma dwie granice. Pierwsza: przeglądarka z AI to nie model. Chrome odczytuje z JSON-LD oznaczenie treści płatnej (isAccessibleForFree), zanim przekaże stronę Gemini (analiza Dejan), a agenci przeglądarkowi czytają cały kod strony. Zdanie „AI nie czyta schemy” dotyczy modelu, który pisze odpowiedź, a nie każdego systemu po drodze. Druga: boty AI zwykle nie wykonują JavaScriptu, więc schemy wstrzykniętej skryptem w ogóle nie zobaczą (szczegóły w rozdziale o botach AI i llms.txt).
W polskich poradnikach często pada zdanie, że bez schemy AI może pominąć stronę. Nie ma na to dowodu, a dokumentacja Google mówi coś przeciwnego. Bliżej prawdy jest symulacja SAGEO Arena (KDD 2026): tytuł, meta opis, nagłówki i JSON-LD razem zwiększyły obecność dokumentu w puli kandydatów o ok. 22%, ale cytowania tylko o ok. 2%. Cytat pochodził głównie z ciała strony, a wkładu samego JSON-LD nie dało się w tej symulacji wydzielić.
Co z tego wynika dla kolejności prac
Najpierw tekst, który odpowiada na pytanie, bo to on trafia do odpowiedzi AI (zobacz, jaką treść AI cytuje). Potem poprawna i prawdziwa schema dla tego, co już jest na stronie. Dopiero na końcu nowe typy znaczników. Schema dodana do słabej strony nie zmieni tego, co model z niej zacytuje.
Wybierz 3 pytania ze swojej branży, przy których pojawia się AI Overview, i otwórz cytowane strony. Wklej każdą do testu wyników z elementami rozszerzonymi Google. Jeśli cytowana jest strona bez żadnej schemy, a pominięta strona ze schemą, masz odpowiedź, co zdecydowało o cytacie: treść.
Schema markup pod AI Overviews: dane strukturalne a cytowania na polskich stronach
Związek jest, ale umiarkowany i nie działa jak bramka. Sprawdziliśmy 113 polskich fraz z AI Overview (google.pl, 12.10.2026). Strony cytowane w AI Overview miały JSON-LD częściej niż niecytowane strony z top 10 tej samej frazy: 78,6% wobec 69,0%. W 68 frazach cytowane miały go częściej, w 33 rzadziej, w 11 tak samo. Mimo to ok. 1/5 cytowanych stron nie miała JSON-LD wcale, a 7 na 10 niecytowanych go miało.
Najważniejszy wynik daje drugie liczenie. Część domen AI Overviews cytuje wielokrotnie: portale poradnikowe, banki i porównywarki pojawiały się w próbie nawet 11–17 razy i mają schemę na każdej stronie. Gdy każdą domenę policzyliśmy raz (i odjęliśmy Wikipedię, gov.pl i Facebooka), zostało 81,9% wobec 78,5%, a frazy rozłożyły się 38 do 27 przy 26 remisach. Taka różnica mieści się w szumie (p = 0,21).
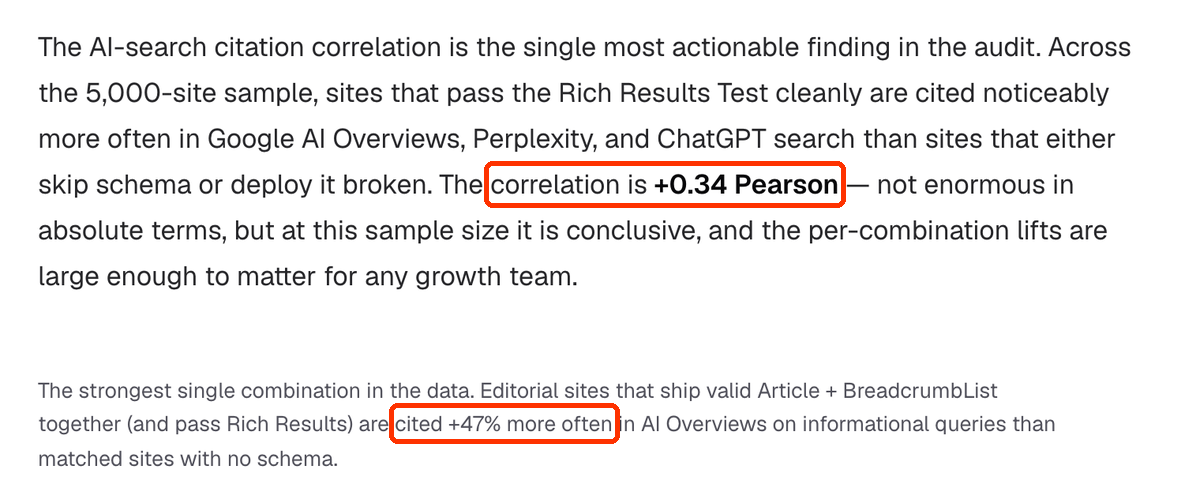
Inne badania mówią więcej, niż mogą. SE Ranking (w relacji Alheny) podaje, że schemę ma 65% stron cytowanych przez tryb AI i 71% cytowanych przez ChatGPT. Bez wiedzy, ile mają strony niecytowane, nic z tego nie wynika: w naszej próbie niecytowane z top 10 miały JSON-LD w 69%. Digital Applied w audycie 5000 witryn podaje korelację +0,34 między poprawną schemą a częstością cytowań w AI i 47% więcej cytowań dla stron z Article i BreadcrumbList niż dla stron bez schemy. To pomiar agencji, bez kontroli typu witryny.
| Kto mierzył | Co | Wynik | Ograniczenia |
|---|---|---|---|
| SE Ranking (przez Alhenę) | odsetek cytowanych stron ze schemą | 65% tryb AI, 71% ChatGPT | bez grupy porównawczej |
| Digital Applied, IV 2026 | 5000 witryn: poprawna schema a cytowania AI | korelacja +0,34; Article + BreadcrumbList +47% | pomiar agencji, bez kontroli typu witryny |
| SAGEO Arena, KDD 2026 | symulacja wyszukiwania z AI | pola strukturalne: pula kandydatów +22%, cytowania +2% | symulacja, JSON-LD niewydzielony |
| Double Digital, X 2026 | 113 fraz PL: cytowane vs top 10 tej samej frazy | 78,6% vs 69,0%; każda domena raz: 81,9% vs 78,5% | korelacja, jeden dzień |
| Data World, 2023 | pytania GPT-4 do firmowej bazy SQL | 16% → 54% nad grafem wiedzy | nie dotyczy schemy na stronach |
Ostatni wiersz to liczba do niepowtarzania. „GPT-4: 16% → 54% dzięki schemie” krąży jako dowód na schemę na stronach, a pochodzi z benchmarku pytań do firmowej bazy danych SQL. Graf wiedzy podniósł tam dokładność odpowiedzi z 16% do 54%. Ze stronami WWW i JSON-LD nie ma to nic wspólnego.
Dlaczego cytowane strony mają schemę częściej
Bo częściej są stronami określonego typu. Duże portale, poradniki i sklepy na popularnych CMS-ach dostają Organization, Article i BreadcrumbList automatycznie z wtyczki SEO. Te same serwisy AI Overviews cytuje często, bo mają treść pod dane pytanie. Różnica zależy też od branży: wyraźna jest w sporcie, zdrowiu i tematach rodzinnych, nie ma jej w finansach, sprawach pracy i prawa ani w podatkach.
Które typy schemy różnią cytowane od niecytowanych
W pełnej próbie najmocniej FAQPage (21,1% wobec 11,6%) i Organization (70,2% wobec 58,8%), słabiej Article (53,4% wobec 44,5%), BreadcrumbList (57,7% wobec 50,3%) i sameAs (46,7% wobec 39,0%). Przy jednej stronie na domenę zostaje tylko kierunek przy FAQPage (18,4% wobec 12,0%, bez istotności), a sameAs się wyrównuje (42,4% wobec 43,0%). Jak AI Overviews wybiera strony do odpowiedzi, opisujemy w rozdziale o AI Overviews i trybie AI.
Dla 3 swoich fraz z AI Overview porównaj cytowane strony ze swoją dwa razy: w teście wyników z elementami rozszerzonymi i w samej treści. Zwykle różnica jest w treści (krótka odpowiedź, tabela, liczby z datą), a nie w schemie.
Test danych strukturalnych: zepsuta schema i schema niezgodna z treścią
Większym problemem niż brak schemy jest schema wdrożona źle albo nieprawdziwie. W audycie 5000 witryn Digital Applied 71% ma przynajmniej jeden typ schemy, a tylko 22% przechodzi test Google bez błędu na każdym typie; 49% trafia do grupy „wdrożona, ale zepsuta”. Google pozwala oznaczać tylko to, co użytkownik widzi na stronie. Za oceny, autorów czy FAQ, których nie ma w treści, grozi ręczne działanie. Zabiera ono kwalifikację do wyników rozszerzonych, a według Google nie wpływa na pozycję strony.

Najczęstsze błędy da się wykryć automatem. Digital Applied wymienia pięć wzorców:
| Błąd | Udział stron z błędem |
|---|---|
| Brak wymaganych właściwości | 38% |
| Data spoza formatu ISO-8601 | 24% |
Zły @type | 12% |
| Złe wymiary obrazów | 9% |
Ten sam @id dla różnych bytów | 7% |
W polskich wynikach wygląda to podobnie. Na 1193 stronach z naszej próby JSON-LD nie dało się odczytać na 17 (1,4%), a błąd poprawności (brak wymaganego pola, zła data, konflikt @id) miały 73 z 866 stron z JSON-LD (8,4%). Najczęściej powtarzał się ten sam @id dla różnych bytów, daty spoza ISO-8601 i FAQPage bez pytań. Daty mają tu dodatkowe znaczenie: dateModified musi zgadzać się z widoczną datą (więcej w rozdziale o świeżości treści).
Gorsza od błędu składni jest schema, która mówi co innego niż strona. Sprawdziliśmy to na stronach z tej samej próby: każdy wykryty przypadek ręcznie, po wyrenderowaniu strony z JavaScriptem. Liczby opinii z AggregateRating nie było widać na 16 z 81 stron (20%). Autora (Person) ze schemy nie było podpisanego na stronie na 26 z 216 (12%). Pytania z FAQPage nie było na stronie na 17 ze 138 (12%). Typowe przypadki: ocena całego sklepu (9 033 opinii) wstawiona do schemy wpisu blogowego, ocena serwisu na każdym artykule poradnikowym, „Redakcja” albo „admin admin” zamiast osoby, FAQ w JSON-LD z pytaniami, których na stronie nie ma.
Jak sprawdzić dane strukturalne
Masz trzy narzędzia i każde widzi co innego. Test wyników z elementami rozszerzonymi Google pokazuje typy, które mogą dać wynik rozszerzony, i braki wymaganych pól. Walidator schema.org sprawdza składnię i słownik dla wszystkich typów, także tych, których Google nie wyświetla. Sprawdzenie adresu URL w Search Console pokazuje, co Google wykrył w zaindeksowanej wersji strony. Żadne z nich nie sprawdza prawdziwości: test przepuści ocenę 4,9 z 2000 opinii, nawet jeśli na stronie nie ma ani jednej. To trzeba porównać ręcznie. Wdrożenie i renderowanie schemy opisujemy w lekcji o technicznym SEO, a jeśli wolisz zlecić przegląd, robimy audyt danych strukturalnych w ramach technicznego SEO.
Wklej stronę główną i jedną stronę usługi lub produktu do testu wyników z elementami rozszerzonymi. Wypisz każdą liczbę ze schemy: ocenę, liczbę opinii, cenę, autora, datę. Przy każdej zaznacz, czy widać ją na stronie. Każda niewidoczna liczba to poprawka: dopisz ją do treści albo usuń ze schemy.
FAQ schema i FAQPage po wycofaniu wyników rozszerzonych FAQ
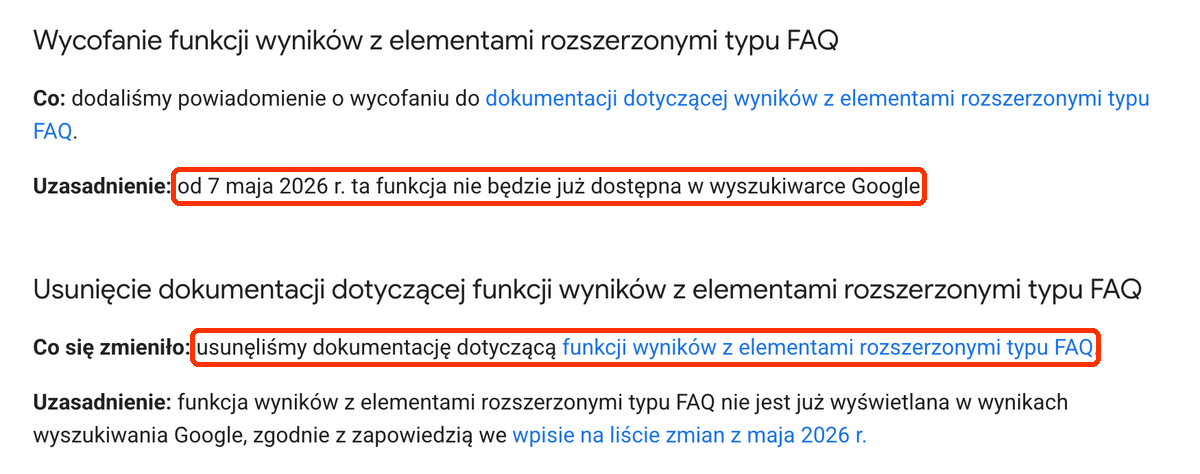
Od 7 maja 2026 r. Google nie pokazuje wyników rozszerzonych typu FAQ, a 15 czerwca usunął ich dokumentację. Nie ma powodu, by kasować FAQPage, który opisuje pytania i odpowiedzi widoczne na stronie: to nadal czytelny materiał dla parserów i grafów wiedzy. Nie ma też powodu, by dokładać go pod AI.
W naszej próbie cytowane strony miały FAQPage prawie dwa razy częściej niż niecytowane z top 10 (21,1% wobec 11,6%). Przy jednej stronie na domenę zostaje 18,4% wobec 12,0%, bez istotności. To mówi raczej o treści niż o znaczniku: strony z FAQ mają krótkie odpowiedzi na konkretne pytania, a taką formę AI cytuje chętnie (więcej w rozdziale o treści cytowanej przez AI). HowTo zniknęło z wyników rozszerzonych jeszcze wcześniej: w galerii funkcji wyszukiwarki Google nie ma dziś ani FAQ, ani HowTo.
Otwarte pozostaje pytanie, czy Gemini przy groundingu bierze tekst z FAQPage, czy z ukrytego akordeonu. Jedyny opisany przypadek (Dejan: odpowiedź z FAQ Salesforce) tego nie rozstrzyga, bo ten sam tekst był w JSON-LD, w zwiniętym akordeonie i w snippecie wyników. Rozstrzygnie to dopiero test z innym tekstem w schemie i innym na stronie. Do tego czasu trzymaj się reguły Google: schema opisuje to, co widać.
Wyszukaj w kodzie strony FAQPage i sprawdź, czy każde pytanie z JSON-LD jest na stronie. Pytanie w akordeonie, który użytkownik może rozwinąć, jest na stronie. Pytania, którego na stronie nie ma, nie powinno być w schemie: dopisz je do treści albo usuń ze znacznika.
Encja marki w Google Knowledge Graph: jak sprawdzić, czy Google zna Twoją firmę
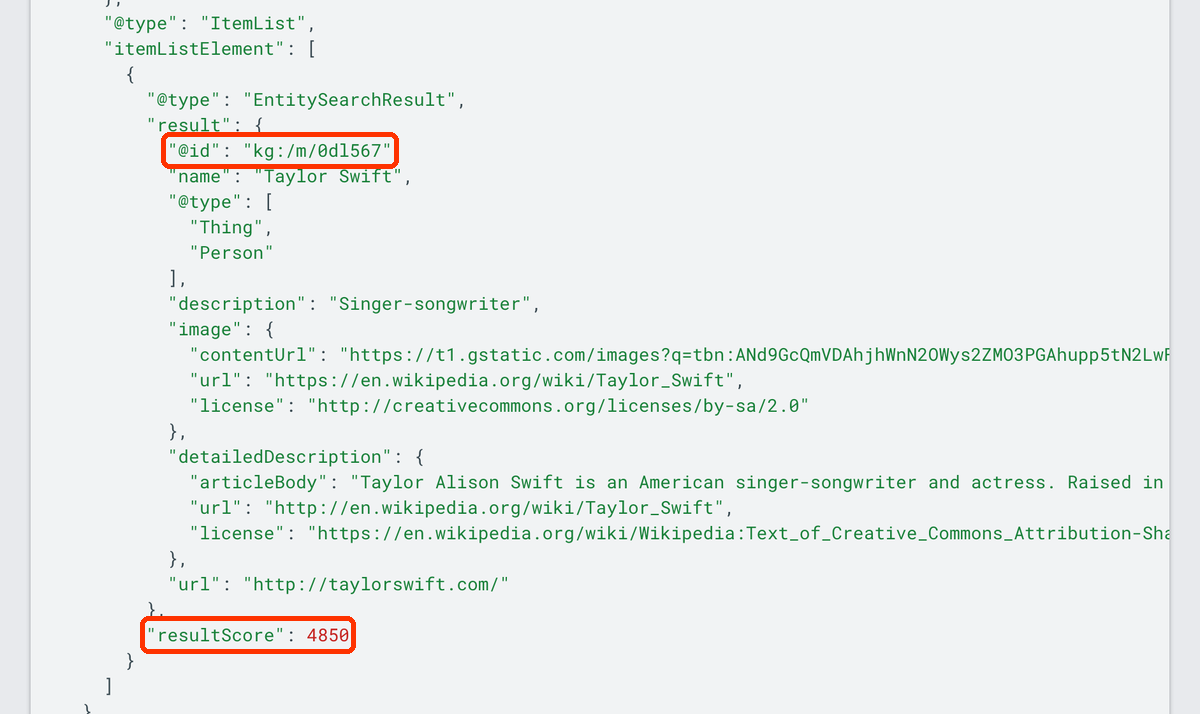
Sprawdź, a nie pytaj modelu. Knowledge Graph Search API zwraca encje Google z typem schema.org, identyfikatorem i polem resultScore. Wikidata pokazuje, czy marka ma otwarty węzeł, do którego możesz prowadzić sameAs. Model językowy chętnie „potwierdzi” encję, której nie ma. Jeśli Google Cię nie zna, zacznij od jednej strony tożsamości z Organization, stałym @id i sameAs do profili, które naprawdę należą do firmy.
Test encji w trzech krokach
- Knowledge Graph Search API. Zapytanie z nazwą firmy (potrzebny klucz API z Google Cloud) zwraca listę encji. Każda ma identyfikator (
kg:/m/…albokg:/g/…), typy (np.Organization,LocalBusiness) iresultScore. To wskaźnik dopasowania encji do zapytania, a nie miara autorytetu marki. Liczy się, czy w wynikach jest Twoja firma z właściwym typem i opisem. - Wikidata. Wyszukaj nazwę firmy i sprawdź, który wynik to naprawdę Ty. Przy krótkich nazwach pierwsze trafienia bywają fałszywe.
- Panel wiedzy. Wpisz nazwę marki w Google. Panel wiedzy z nazwą, logo i profilami oznacza, że Google łączy zapytanie z encją. Wizytówka Profilu Firmy to co innego: dotyczy lokalizacji, nie encji marki.
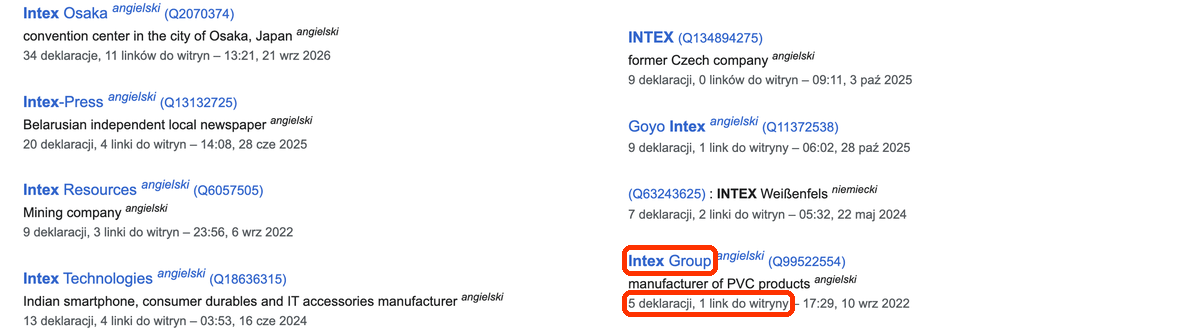
Przykład z kursu SEO semantycznego: model językowy uznał, że producent basenów Intex „przeszedłby test Wikipedii”. Artykułu o tej firmie nie ma ani w polskiej, ani w angielskiej Wikipedii. W Wikidata wyszukanie „Intex” pokazuje najpierw centrum konferencyjne w Osace, białoruską gazetę, firmę wydobywczą i indyjskiego producenta smartfonów. Węzeł Intex Group (opis: producent wyrobów z PVC) jest dopiero ósmy i ma 5 deklaracji (stan z 20.10.2026). Tak wygląda typowa marka o krótkiej nazwie: węzeł istnieje, ale jest ubogi i łatwo go pomylić z innym. Jeśli Twoja nazwa koliduje z pojęciem albo inną firmą, sameAs i spójny opis są ważniejsze niż dla marki o nazwie unikalnej.
Strona tożsamości (Entity Home)
Google pisze, że dodanie danych organizacji do strony głównej „może pomóc Google lepiej zrozumieć informacje administracyjne organizacji i uniknąć niejasności dotyczących organizacji w wynikach wyszukiwania”. Strona główna jest też stroną, którą boty AI pobierają najczęściej: Orbit Media w pomiarze na 74 witrynach zauważył, że jest czytana wielokrotnie częściej, niż wynikałoby z jej udziału w serwisie (pomiar dostawcy, korelacja). Dlatego to tam umieść Organization ze stałym @id i połącz z nim resztę: WebSite, autorów (Person) i artykuły.
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://twojafirma.pl/#organization",
  "name": "Twoja Firma",
  "url": "https://twojafirma.pl/",
  "logo": "https://twojafirma.pl/logo.png",
  "description": "Jedno zdanie: co robisz i dla kogo.",
  "foundingDate": "2015-03-01",
  "address": {
    "@type": "PostalAddress",
    "addressLocality": "Warszawa",
    "addressCountry": "PL"
  },
  "sameAs": [
    "https://www.linkedin.com/company/twoja-firma/",
    "https://www.wikidata.org/wiki/Q…"
  ]
}
Każda wartość musi zgadzać się z tym, co widać na stronie i w profilach. sameAs prowadzi tylko do profili, które istnieją, należą do firmy i pokazują tę samą nazwę. Link do Wikidata dodaj tylko wtedy, gdy węzeł opisuje Twoją firmę. Firmy lokalne dokładają LocalBusiness i Profil Firmy (zobacz lekcję o SEO lokalnym), a jak Google buduje Knowledge Graph, wyjaśniamy w lekcji o tym, jak działa wyszukiwarka. Porządkowanie encji marki to też część naszej usługi SEO pod widoczność marki w AI.
Praktycy opisują to ramą NEEATT: przejrzystość (kto jest właścicielem, kto pisze, po co strona istnieje) jest warunkiem koniecznym, a rozpoznawalność działa jak mnożnik. Niszowa marka może być bardziej rozpoznawalna w swojej wąskiej dziedzinie niż korporacja.
Wikidata: kiedy warto
Tylko gdy firma spełnia kryteria Wikidata, czyli opisują ją poważne, publicznie dostępne źródła niezależne od niej. Wpis założony dla firmy bez takich źródeł może zostać usunięty. Najpierw zbuduj wzmianki w niezależnych źródłach, potem węzeł. Gdzie je zdobywać, żeby budowały pamięć modelu, piszemy w rozdziale o wzmiankach o marce i widoczności w AI.
Wpisz nazwę firmy w wyszukiwarce Wikidata i w Knowledge Graph Search API (zapytanie entities:search?query=…). Zapisz identyfikator, typ i opis albo to, że firmy nie ma. Potem otwórz kod strony głównej i sprawdź, czy każdy adres w sameAs działa, należy do firmy i pokazuje tę samą nazwę.
Entity SEO: spójność faktów o marce i strona faktów
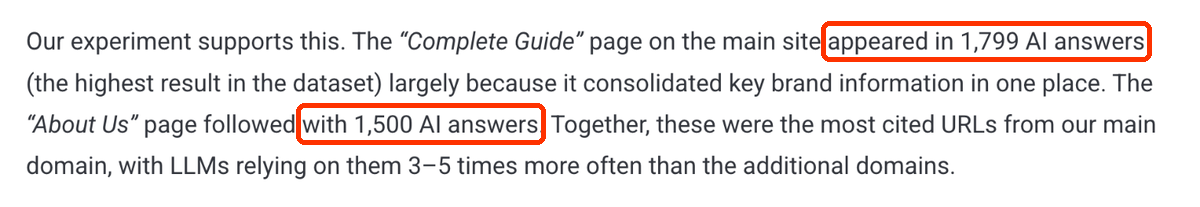
Model opisuje firmę z tego, co znajdzie, więc fakty o marce muszą być te same na stronie, w schemie, w katalogach i w profilach. W eksperymencie SE Ranking z fikcyjną marką najczęściej cytowane były strony, które zbierały fakty w jednym miejscu: strona „Complete Guide” pojawiła się w 1799 odpowiedziach AI, a „About Us” w 1500. Gdy w sieci krąży szczegółowa, konkurencyjna wersja, oficjalne FAQ nie zawsze wygrywa. W eksperymencie Ahrefs ChatGPT cytował FAQ marki w 84% odpowiedzi, ale Gemini i Perplexity powtarzały podłożoną dezinformację w 37–39% odpowiedzi.
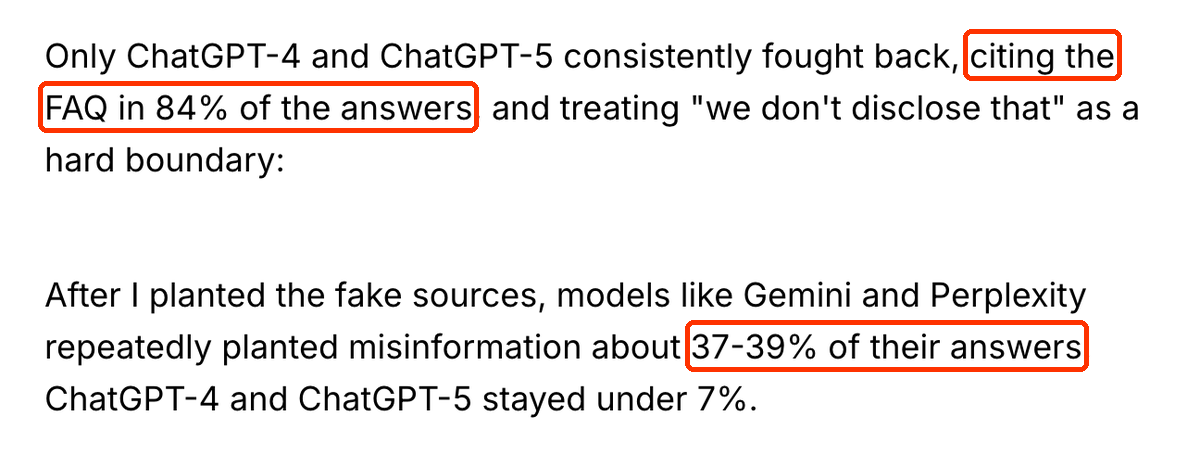
Eksperyment Ahrefs uczy jeszcze jednego: konkret wygrywa z ogólnikiem. FAQ marki mówiło, że firma nie publikuje liczby sprzedanych sztuk, a fałszywe źródła podawały konkretne liczby. Modele prawie zawsze wybierały liczby. Jeśli nie podasz faktu, model wypełni lukę cudzą wersją.
Strona faktów
Strona faktów to zwykła, indeksowana strona HTML z aktualnymi danymi o firmie: co robisz i dla kogo, zakres i ceny (choćby widełki), certyfikaty, liczby z datą, dane rejestrowe. Link do niej umieść w stopce i w mapie witryny, a najważniejsze fakty powtórz w jednym akapicie na stronie głównej. To nie jest llms.txt, tylko strona dla ludzi i botów jednocześnie. Uwaga na samą formę: w raporcie Trellner o źródłach rekomendacji AI farmy rankingów oprogramowania nazywają swoje strony „facts and grounding”. Nazwa niczego nie dowodzi, fakty muszą potwierdzać źródła niezależne od Ciebie.
Spójność psują najczęściej dwie rzeczy. Pierwsza to warianty nazwy: według Detailed 36% pozornych „zniknięć” marki z odpowiedzi ChatGPT to w rzeczywistości ta sama marka pod inną nazwą. Jedna nazwa firmy i produktów w całej sieci pomaga modelowi rozpoznać jedną encję. Druga to stare fakty w obiegu. Full Fact zauważył, że część czatbotów po publikacji sprostowania poprawiała odpowiedź po kilku dniach, często cytując to sprostowanie, ale część dalej powtarzała błąd. Korekta na własnej stronie to początek, a nie koniec.
Audyt spójności w 30 minut
| Fakt | Strona główna | O nas | Schema | Katalogi, Profil Firmy | |
|---|---|---|---|---|---|
| Nazwa firmy | … | … | … | … | … |
| Rok założenia, „lat na rynku” | … | … | … | … | … |
| Ocena i liczba opinii | … | … | … | … | … |
| Liczba klientów lub projektów | … | … | … | … | … |
| Adres i obszar działania | … | … | … | … | … |
| Nazwy usług i produktów | … | … | … | … | … |
Wpisz wartość z każdego miejsca. Każdy wiersz z różnymi wartościami to zadanie: wybierz jedną prawdziwą wersję, popraw ją wszędzie, a na stronie faktów podaj datę. Najczęstsze rozjazdy to rok założenia (data rejestracji spółki zamiast początku działalności albo „X lat doświadczenia” liczone od innej daty) i liczba opinii (inna w widżecie, inna w schemie, inna w Profilu Firmy).
Zapytaj ChatGPT z wyszukiwaniem i Gemini: „Czym zajmuje się [firma], od kiedy działa i ile ma opinii?”. Porównaj każdą liczbę z odpowiedzi z tabelą audytu. Rozjazd w odpowiedzi AI zwykle ma źródło w jednej z jej kolumn.
E-E-A-T i autor treści: fikcyjni autorzy w wytycznych Google
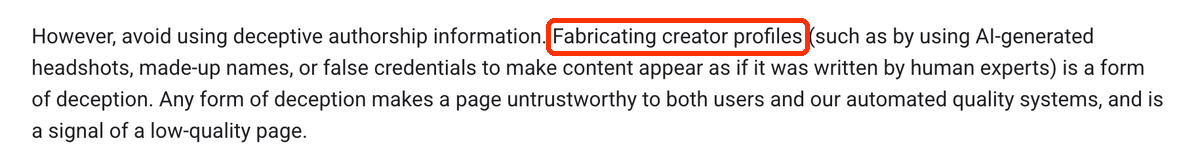
Podpisuj treści prawdziwymi ludźmi. Google pisze w wytycznych o pomocnych treściach: „Fabricating creator profiles (such as by using AI-generated headshots, made-up names, or false credentials to make content appear as if it was written by human experts) is a form of deception”. Czyli: tworzenie fikcyjnych profili autorów (zdjęcia z AI, zmyślone nazwiska, fałszywe kwalifikacje), żeby treść wyglądała na napisaną przez ekspertów, to oszustwo. Według Google takie oszustwo czyni stronę niewiarygodną dla użytkowników i dla automatycznych systemów jakości i jest sygnałem strony niskiej jakości.
Wymóg to prawdziwa osoba związana z tekstem, a nie znane nazwisko z branży. E-E-A-T (doświadczenie, wiedza, autorytet, wiarygodność) to rama, w której oceniający jakość patrzą na stronę; opisują ją wytyczne dla oceniających jakość. Poza tematami YMYL doświadczenie z pierwszej ręki jest kwalifikacją, o ile je pokażesz: zdjęcia z realizacji, liczby z własnych projektów, opis tego, co autor zrobił. Jak Google ocenia przydatność treści, wyjaśniamy w haśle Helpful Content Update.
Person w schemie ma opisywać tego samego autora, który jest podpisany na stronie. W naszej próbie na 12% stron z autorem w JSON-LD tej osoby nie było w podpisie; typowe są „Redakcja”, „admin” albo nick zamiast imienia i nazwiska. Najlepiej, gdy autor ma własną stronę z biogramem, zdjęciem, kwalifikacjami, linkami do profili i listą tekstów. To jego strona tożsamości, tak jak strona główna dla firmy (przykład: strona autora). Rady o „budowaniu autorytetu” zmyślonymi certyfikatami czy historiami, które padają na branżowych webinarach, stoją w sprzeczności z tymi wytycznymi.
Wersje językowe: jedna encja, nie dwie
Jeśli masz stronę po polsku i po angielsku, Organization w obu wersjach powinna mieć te same atrybuty i te same adresy w sameAs, najlepiej z jednym @id. Inaczej marka może rozpaść się na dwie słabe encje. To praktyka, bez pomiaru. Powiązanie wersji językowych przez hreflang opisujemy w lekcji o technicznym SEO.
Otwórz 3 swoje wpisy. Sprawdź, czy autor ze schemy jest podpisany na stronie, czy ma stronę autora i czy jego zdjęcie i kwalifikacje są prawdziwe. Jeśli tekst pisał zespół, podpisz osobę, która go sprawdziła, i napisz to wprost.
FAQ — najczęściej zadawane pytania o dane strukturalne i encję marki
- Czy JSON-LD jest lepszy od mikrodanych?
Google obsługuje JSON-LD, mikrodane i RDFa i wszystkie działają tak samo, o ile są poprawne. Zaleca JSON-LD, bo najłatwiej go wdrożyć i utrzymać na dużą skalę. JSON-LD ma ok. 89% udziału we wdrożeniach (Alhena). Sam format nie daje przewagi w wynikach.
- Czy schema wygenerowana przez wtyczkę albo AI wystarczy?
Tylko jeśli zgadza się z treścią. Generator nie wie, co jest widoczne na stronie: wtyczka ocen potrafi wstawić ocenę całego sklepu do każdego wpisu, a AI dopisze FAQ, którego na stronie nie ma. Po wdrożeniu porównaj schemę z treścią ręcznie.
- Czy dane strukturalne poprawiają pozycje w Google?
Nie bezpośrednio. Dają kwalifikację do wyników rozszerzonych i pomagają Google jednoznacznie zrozumieć stronę i firmę. Google zastrzega, że nawet poprawne znaczniki nie gwarantują wyniku rozszerzonego.
- Czy boty AI widzą schemę dodaną JavaScriptem?
Googlebot renderuje JavaScript, więc ją zobaczy. Boty AI zwykle stron nie renderują i widzą tylko surowy HTML. W naszej próbie schema dodawana skryptem była marginesem: na 30 stronach bez JSON-LD w HTML render dodał ją na jednej. Bezpieczniej wstawiać JSON-LD w HTML z serwera (więcej w rozdziale o botach AI i llms.txt).
- Ile trwa, zanim zmiana schemy będzie widoczna?
Według relacji z Search Central Live w Barcelonie Google przetwarza aktualizacje danych strukturalnych w czasie od kilku godzin do 1–2 tygodni. Digital Applied podaje, że efekt w cytowaniach widać po ok. 30 dniach (pomiar agencji). Licz od wizyty Google na stronie po zmianie, a nie od dnia wdrożenia.
Encja marki i schema w ośmiu zdaniach
- 01Model nie czyta JSON-LD, gdy pisze odpowiedź; Google pisze wprost, że schema nie jest wymagana w wynikach AI.
- 02Schema działa pośrednio: przez wyniki rozszerzone i grafy wiedzy, a cytat w AI pochodzi z tekstu strony.
- 03W polskich AI Overviews cytowane strony mają JSON-LD częściej (78,6% vs 69,0%), ale przy jednej stronie na domenę różnica to szum.
- 04Zepsuta albo nieprawdziwa schema to większy problem niż jej brak: co piąta strona z oceną w schemie nie pokazuje tej liczby opinii.
- 05FAQ rich results zniknęły 7 maja 2026; FAQPage zostaw tylko tam, gdzie pytania są widoczne na stronie.
- 06To, czy Google zna firmę, sprawdzasz w Knowledge Graph Search API i Wikidata, a nie pytając model.
- 07Fakty o firmie muszą być te same na stronie, w schemie i w profilach; konkret wygrywa z ogólnikiem.
- 08Fikcyjny autor to według Google oszustwo i sygnał strony niskiej jakości — podpisuj treści prawdziwymi ludźmi.
Ciąg dalszy przewodnika.
SEO, paid media i strategie widoczności w Double Digital