Zanim ChatGPT albo Gemini odpowie, zamienia pytanie w kilka własnych zapytań do wyszukiwarki (query fan-out) i składa odpowiedź z ich wyników.
Przy polskim pytaniu ChatGPT wysyła ich średnio ok. 3, a nie 7–8 jak w badaniach na angielskich promptach. Ok. 70% tych wyszukiwań celuje operatorem site: w konkretną domenę, najczęściej urzędu albo producenta. W 42% pytań co najmniej jedno wyszukiwanie idzie po angielsku. Gemini w naszym pomiarze sięgał do sieci tylko przy co trzecim pytaniu.
Podzapytania zmieniają się z przebiegu na przebieg, więc nie da się pod nie „pisać nagłówków”. Dają za to mapę pytań wokół tematu. To, czy pytanie dostaje osobną stronę, rozstrzyga popyt, odrębna encja i podobieństwo wyników, a nie sam fakt, że model o nie zapytał.
W tym rozdziale masz pomiar 120 polskich pytań w trzech modelach, procedurę sprawdzenia własnej frazy i test „strona czy sekcja” na przykładzie naszej sieci stron miejskich. Przy każdej lekcji podajemy ocenę dowodu.
Model nie wyszukuje Twojego pytania, tylko kilka własnych: często z site: na stronę urzędu albo producenta, czasem po angielsku, za każdym razem inne. Traktuj je jak mapę tematu, a o osobnej stronie decyduj po popycie, encji i wynikach wyszukiwania.
- potwierdzoneco najmniej dwa niezależne pomiary zgodne co do kierunku
- pojedynczy pomiarjeden pomiar z jawną metodą: kierunek wiarygodny, liczba niepewna
- spornepomiary są sprzeczne albo spór o interpretację nie jest rozstrzygnięty
- mechanizmopis działania z dokumentacji platformy, patentu lub dokumentu sądowego
- praktykaobserwacja z pracy albo rekomendacja bez pomiaru
- obaloneliczba bez pokrycia w źródłach, zbita pomiarem albo wycofana przez autora
Ocena dotyczy tezy, nie źródła: dokumentacja Google opisuje mechanizm, ale nie mierzy jego efektu.
Query fan-out: co to jest i dlaczego nie zobaczysz go w Search Console
Query fan-out to technika, w której model zamienia jedno pytanie użytkownika w kilka zapytań do wyszukiwarki, czyli podzapytań, i buduje odpowiedź z ich wyników. Google potwierdza ją w dokumentacji AI Overviews i AI Mode. Podzapytań nie ma w Search Console, bo nie wpisał ich człowiek. Twoja strona może więc pojawić się w odpowiedzi AI na zapytanie, którego nie zobaczysz w żadnym raporcie.
Najprościej pokazać to na przykładzie z naszego pomiaru. Zadaliśmy ChatGPT pytanie „Co to jest cholesterol LDL i jaka jest norma?”. Model nie wyszukał tego zdania. Wysłał trzy własne zapytania, każde zawężone do jednej domeny, z liczbami, które już „znał”, i dwa z nich po angielsku:
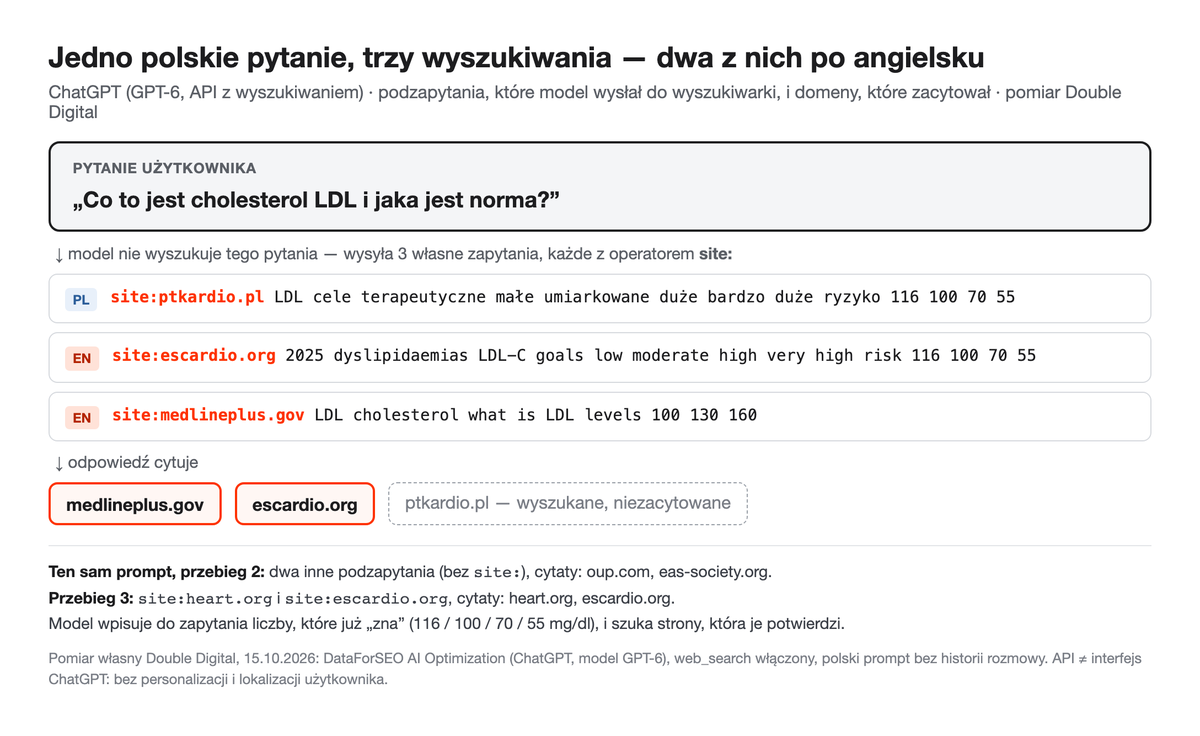
Z tego przykładu wynikają trzy rzeczy, które wracają w całym rozdziale. Model wybiera źródła, zanim zacznie szukać: wpisuje site: i idzie po potwierdzenie na stronę, którą uważa za wiarygodną. Pytanie zadane po polsku nie oznacza wyszukiwania po polsku. A polska strona, nawet wyszukana, nie musi trafić do odpowiedzi: ptkardio.pl była w zapytaniu, ale cytaty dostały escardio.org i medlineplus.gov.
Co mówi Google
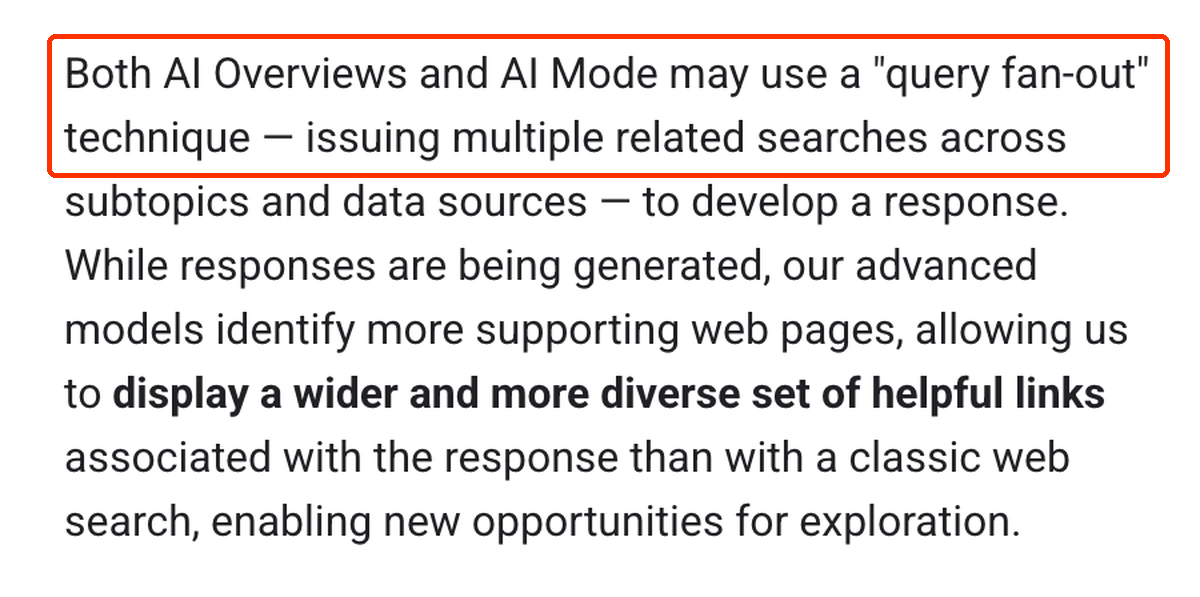
Dokumentacja Google opisuje fan-out jednym zdaniem: AI Overviews i AI Mode mogą wysyłać wiele powiązanych wyszukiwań w podtematach i różnych źródłach danych, żeby zbudować odpowiedź.
Więcej szczegółów dają patenty, które omówił iPullRank. Opisują one osiem typów wariantów zapytania, m.in. uszczegółowienie, uogólnienie, doprecyzowanie i tłumaczenie. Warianty mogą powstawać także z kontekstu użytkownika: lokalizacji, historii czy pory dnia. O tym, czy generować kolejne warianty, decyduje osobny model, a jedno ze zgłoszeń wymienia wśród kryteriów nawet bieżące obciążenie serwera. To jeden z powodów, dla których ten sam prompt daje różne źródła. Patent opisuje zdolność systemu, a nie to, jak często Google jej używa.
Dlaczego podzapytań nie ma w GSC
John Mueller mówił na Search Central Live w Barcelonie, że podzapytania AI Mode i AI Overviews nie trafiają do Search Console, bo nie pochodzą od użytkowników. Przechodzą za to to samo rozumienie zapytania co zapytanie człowieka: rozpoznanie języka, encji i synonimów. W praktyce oznacza to, że fan-outów Google nie zmierzysz w GSC. Możesz je obserwować w innych silnikach (API Gemini, API OpenAI, Bing Webmaster Tools) albo symulować. Jak to zrobić, pokazujemy w części o narzędziach.
Fan-out to pierwsza z bramek, przez które przechodzi strona, zanim AI ją zacytuje. Całą ścieżkę, od wyszukania po wybór marki, opisujemy w lekcji o tym, jak działają wyszukiwarki AI. Jak fan-out wygląda w samym Google, opisujemy w rozdziale o AI Overviews i AI Mode.
Zadaj w ChatGPT z włączonym wyszukiwaniem pytanie, które zadają Twoi klienci, i policz źródła pod odpowiedzią. Sprawdź, czy któreś z nich jest polskie i czy jest wśród nich Twoja konkurencja. Źródła to ślad fan-outu, a nie jego lista. Listę podzapytań zobaczysz dopiero przez API.
Query fan-out w ChatGPT i Gemini: ile podzapytań robi model przy polskim pytaniu
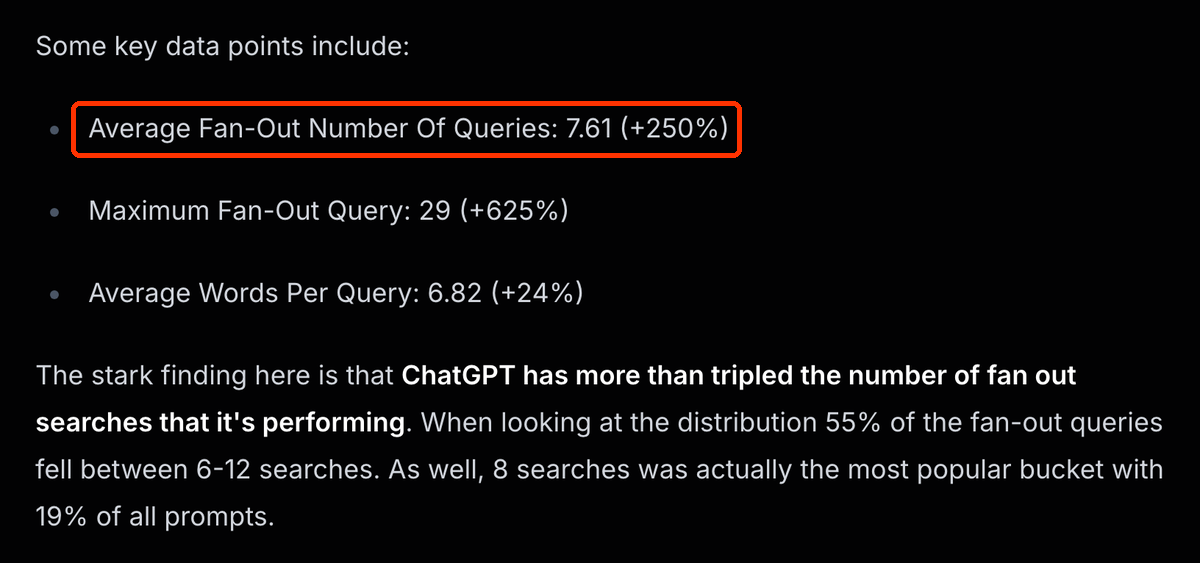
Przy polskim pytaniu ChatGPT (GPT-6, domyślny model planów płatnych) wysyła średnio 3,3 podzapytania, darmowy GPT-5.6 Luna 2,5, a Gemini 3.8 Flash 0,6, bo w dwóch trzecich pytań w ogóle nie szuka. To wyraźnie mniej niż 7,61 podzapytania, które Nectiv zmierzył na angielskich promptach po przejściu ChatGPT na GPT-5.6. Liczba podzapytań zależy od modelu, języka i typu pytania. Obiegowe „fan-out to 5–10 zapytań” nie ma źródła.
Jak mierzyliśmy
Napisaliśmy 120 polskich pytań tak, jak zadaje je użytkownik, w 12 branżach: od zdrowia i finansów po motoryzację i sport. Były wśród nich 36 pytań informacyjnych („co to jest…”), 36 porównawczych („X czy Y”, „jaki X wybrać”), 24 lokalne („… w Krakowie”) i 24 porady („czy można…”). 15 października 2026 r. wysłaliśmy je przez API DataForSEO do trzech modeli z włączonym wyszukiwaniem, bez wymuszania go. Model sam decydował, czy szukać. Odpowiedź API zawiera listę podzapytań, które model wysłał, i cytowane adresy. 30 pytań zadaliśmy trzy razy, żeby sprawdzić powtarzalność. Łącznie 576 odpowiedzi kosztowało ok. 15 USD.
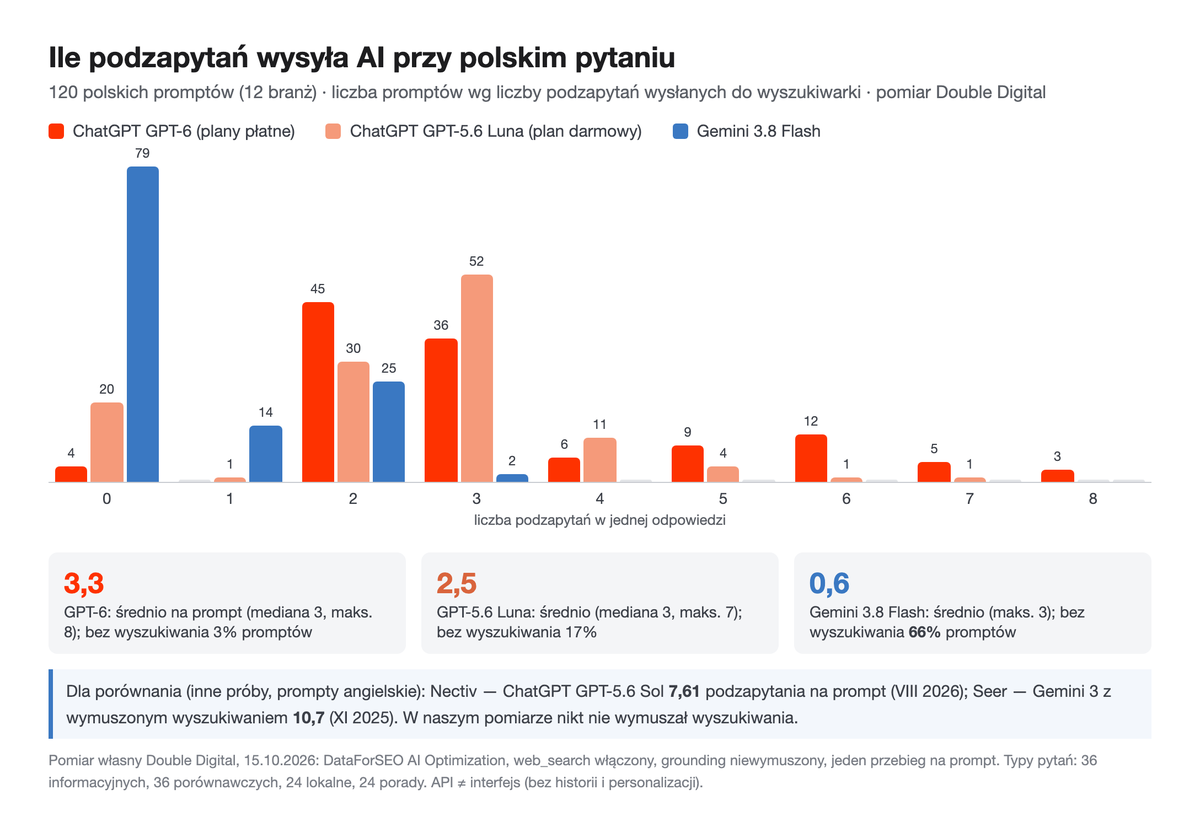
Rozkład ma dwa szczyty. ChatGPT najczęściej robi 2 albo 3 podzapytania, a dłuższe serie (5–8) zostawia głównie dla pytań porównawczych. Typ pytania zmienia liczbę wyraźnie: w GPT-6 porównania dostają średnio 4,5 podzapytania, pytania lokalne 3,6, porady 2,8, a pytania informacyjne 2,3. To zgodne z obserwacją AirOps, że definicje model wyszukuje prawie dosłownie, a porównania rozbija na części.
Co mierzyli inni
Najgłośniejszy wynik pochodzi od Nectiv. Po przejściu ChatGPT na GPT-5.6 średnia liczba podzapytań na prompt wzrosła z 2,17 do 7,61:
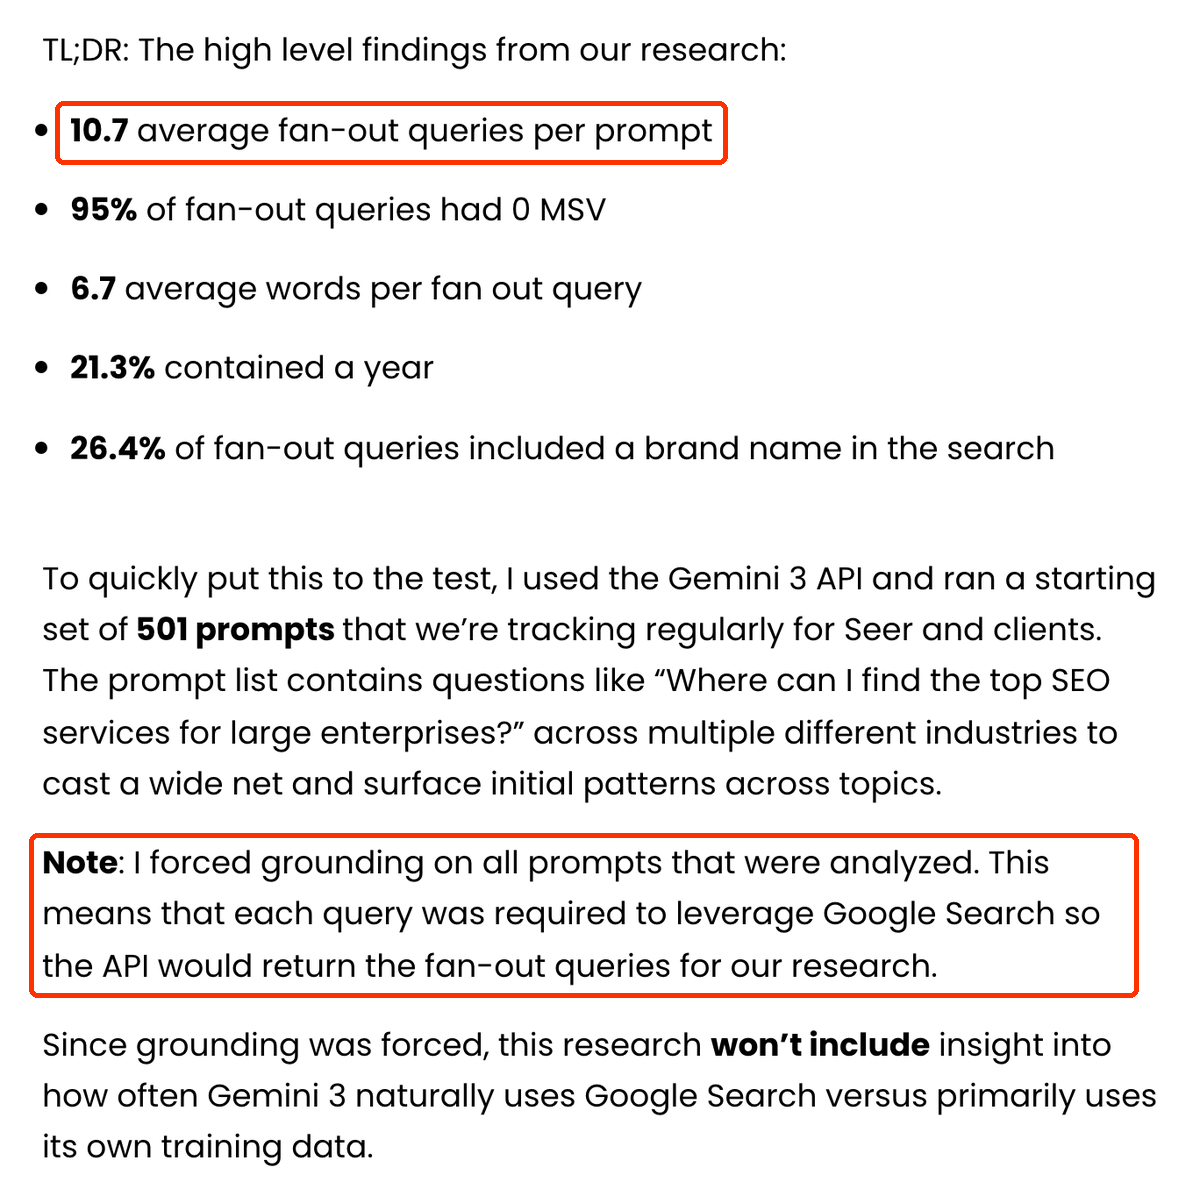
Gemini 3 w badaniu Seer Interactive robił średnio 10,7 podzapytania. Seer zaznacza jednak, że wymusił wyszukiwanie na każdym prompcie. Jego wynik nie mówi więc, jak często model szuka sam z siebie. Nasz pomiar mówi: Gemini 3.8 Flash bez przymusu szukał tylko przy 34% polskich pytań.
| Kto mierzył | Model | Próba | Podzapytań na prompt | Uwagi |
|---|---|---|---|---|
| Nectiv (2025) | ChatGPT, przed GPT-5.6 | ok. 4 tys. promptów EN | 2,17 | API |
| AirOps (wiosna 2026) | ChatGPT, interfejs | prompty EN | 88,6% zapytań = dokładnie 2 | stan sprzed GPT-5.6 |
| Nectiv (VIII 2026) | ChatGPT GPT-5.6 Sol | ok. 4 tys. promptów EN | 7,61 | API, te same prompty co w 2025 |
| Nectiv (2025) | ok. 60 tys. podzapytań | 9,06 | prompty EN | |
| Seer (XI 2025) | Gemini 3 | 501 promptów EN | 10,7 | wyszukiwanie wymuszone |
| Double Digital (X 2026) | ChatGPT GPT-6 | 120 promptów PL | 3,3 (mediana 3) | API, wyszukiwanie niewymuszone |
| Double Digital (X 2026) | ChatGPT GPT-5.6 Luna | 120 promptów PL | 2,5 | 17% bez wyszukiwania |
| Double Digital (X 2026) | Gemini 3.8 Flash | 120 promptów PL | 0,6 | 66% bez wyszukiwania |
Skąd różnica między naszym 3,3 a 7,61 Nectiv? Nie wiemy na pewno, a powodów może być kilka naraz: inny model, inny język i inne pytania. Nectiv badał branże zakupowe (oprogramowanie, e-commerce, nieruchomości, moda, podróże, karty kredytowe) Najmniej podzapytań miały tam podróże i karty kredytowe (poniżej 6 na prompt), najwięcej oprogramowanie (10,7). Żeby oddzielić model od języka, puściliśmy nasze 36 pytań porównawczych także przez GPT-5.6 Sol, model z badania Nectiv. Wyszło 4,3 podzapytania na prompt, prawie tyle samo co GPT-6 na tych samych pytaniach (4,5). Przy polskich pytaniach to nie wersja modelu robi różnicę, tylko język i typ pytania. Nie da się też wykluczyć, że część różnicy to sposób zbierania danych: inny dostawca API, inny dzień.
Dwie uwagi metodyczne. Po pierwsze, API to nie interfejs ChatGPT: nie ma historii rozmowy, personalizacji ani lokalizacji użytkownika, a patenty Google przewidują podzapytania budowane właśnie z takiego kontekstu. Po drugie, tryb „thinking” robi więcej wyszukiwań niż tryb szybki, w pojedynczych obserwacjach 15–40 przy jednym pytaniu porównawczym. Podzapytania pobierają strony przez boty wyszukiwarek AI. Jeśli Twój serwer je blokuje, nie wejdziesz nawet do puli. Opisujemy to w rozdziale o botach AI, robots.txt i llms.txt.
Zadaj to samo pytanie klienta w ChatGPT dwa razy: raz w trybie szybkim, raz z „thinking”. Porównaj liczbę i domeny źródeł. Jeśli w trybie szybkim nie ma Twojej strony, a w trybie „thinking” jest, Twoja treść jest w puli, ale nie w pierwszych wyszukiwaniach.
Jak brzmią podzapytania: site:, marki, rok i angielski
Podzapytanie nie przypomina pytania użytkownika. To długi ciąg rzeczowników (w GPT-6 mediana 8 słów), często z rokiem, nazwą instytucji albo producenta, której pytanie nie zawierało, i z operatorem site:, który zawęża wyszukiwanie do jednej domeny. Przy polskich pytaniach GPT-6 użył site: w 75% pytań, rok wpisał w 57%, a co najmniej jedno podzapytanie po angielsku wysłał w 42%. Gemini 3.8 Flash szukał prawie wyłącznie po polsku i bez site:.
site: na konkretne domeny, pokazują dwa niezależne pomiary: Nectiv (64% podzapytań GPT-5.6, prompty angielskie) i nasz (70% podzapytań GPT-6, prompty polskie). Skala zjawiska angielskich podzapytań jest natomiast sporna sporne: Peec AI podaje 88,2% polskich rozmów, my 42% polskich pytań. Różni je metoda, okres i model.Stan na: 2026-10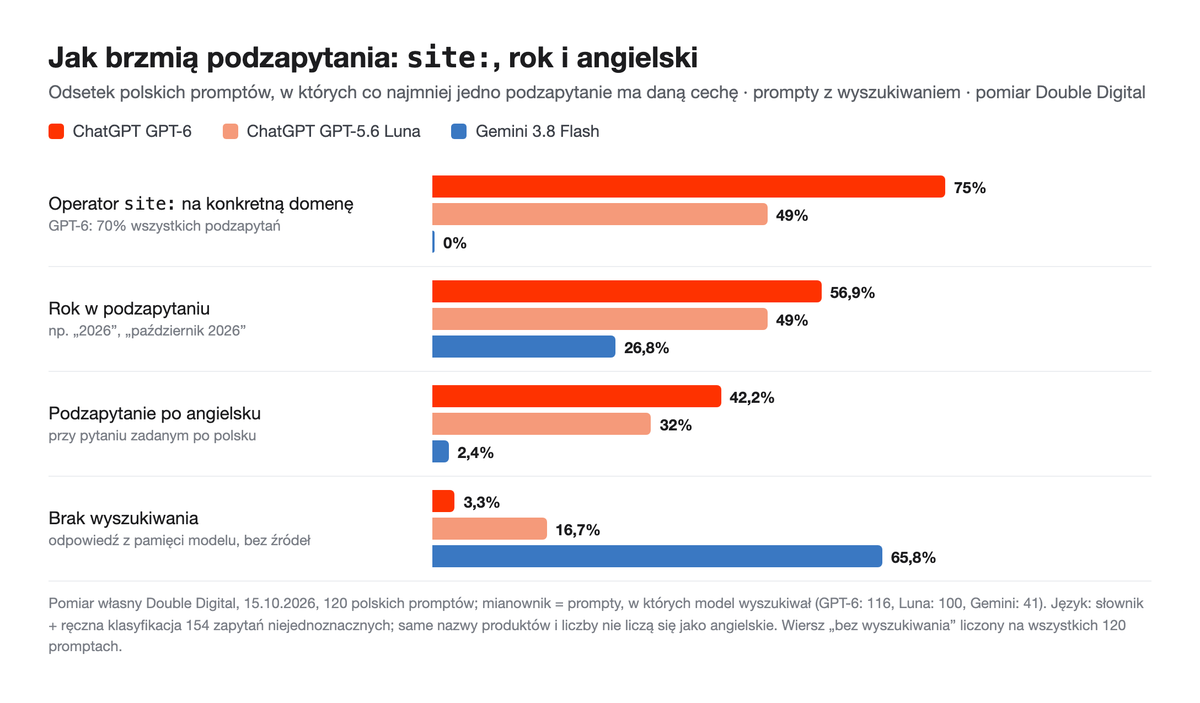
site: — model sam wybiera, gdzie szukać
To najmocniejszy wynik pomiaru. 70% podzapytań GPT-6 zawierało site:, a w 71% pytań z wyszukiwaniem co najmniej jedna domena w site: nie była wymieniona w pytaniu. Model nie przeszukuje więc całej sieci, tylko z góry wskazuje kilka stron, które uważa za wiarygodne, i sprawdza na nich fakty. Przy polskich pytaniach najczęściej były to gov.pl, podatki.gov.pl, knf.gov.pl, uokik.gov.pl i ure.gov.pl, przy produktach strony producentów (apple.com, garmin.com, daikin.pl). Nectiv widzi to samo na angielskich promptach: site: w 64% podzapytań, a słowa „official” i „gov” w czołówce najczęstszych dopisków modelu.
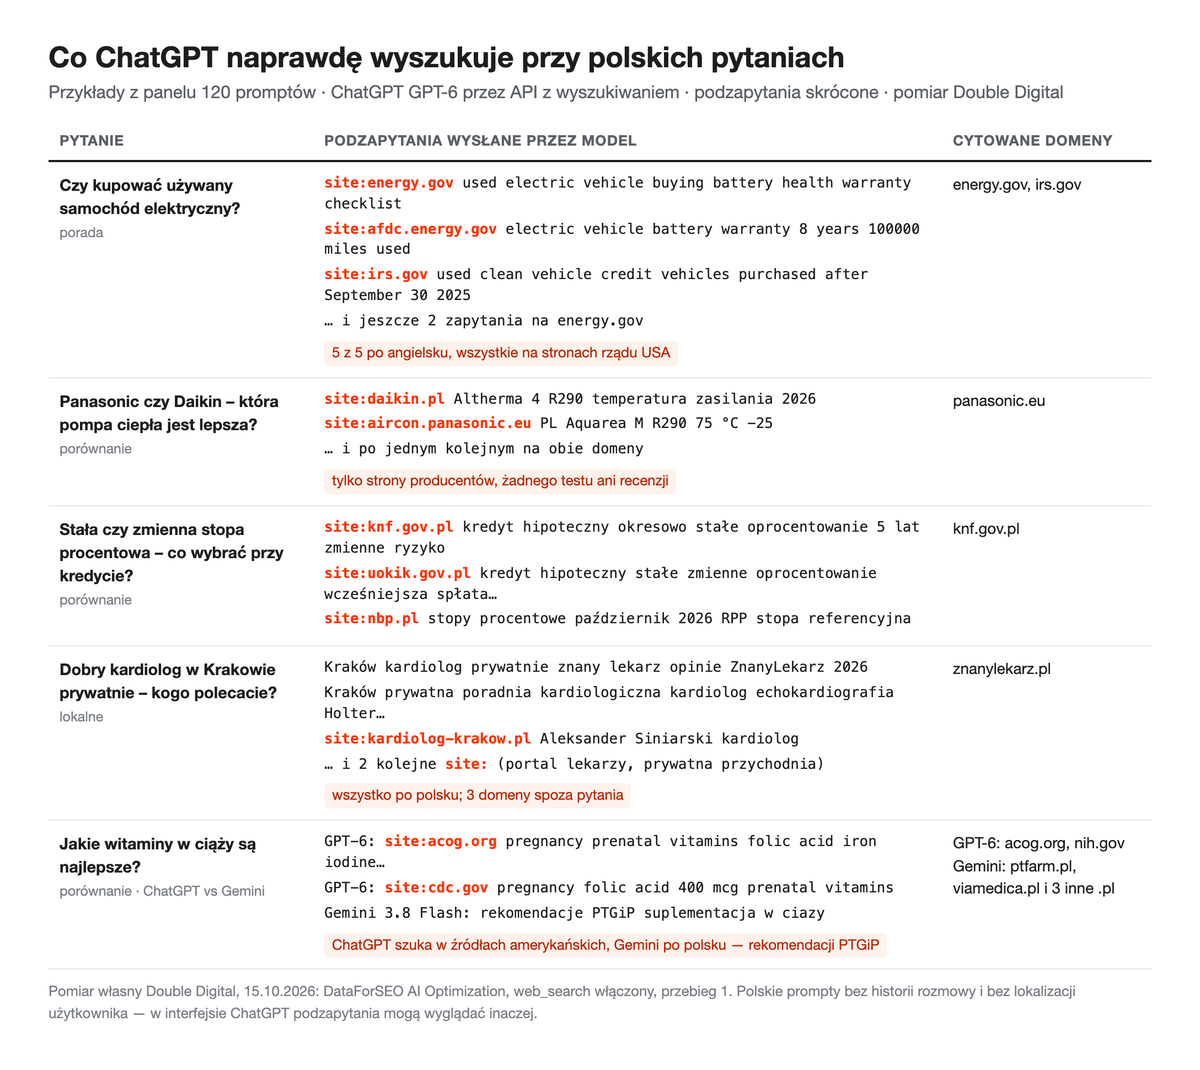
Przykłady pokazują, że model ma gotową listę miejsc, zanim zacznie szukać. Przy porównaniu pomp ciepła sprawdza tylko strony producentów, bez testów i recenzji. Przy kredycie idzie na strony nadzoru (KNF, UOKiK, NBP). Przy pytaniu o używany samochód elektryczny szuka wyłącznie na stronach rządu USA, łącznie z amerykańską ulgą podatkową, która polskiego kupującego nie dotyczy. Taki fakt może trafić do polskiej odpowiedzi.
Angielski przy polskim pytaniu
W 42% polskich pytań GPT-6 wysłał co najmniej jedno podzapytanie po angielsku, a 32% wszystkich jego podzapytań było angielskich. Darmowy GPT-5.6 Luna robił to w 32% pytań, Gemini w 2%. Najwięcej angielskiego dostają porady (67% pytań: zdrowie, zwierzęta, sport), najmniej pytania lokalne (4%). Pytanie „dobry kardiolog w Krakowie” zostaje po polsku, a pytanie „czy psu można dawać ibuprofen” trafia na merckvetmanual.com i aspca.org.
Peec AI podaje dla polskiego dużo więcej: co najmniej jedno angielskie podzapytanie w 88,2% rozmów i 43% angielskich podzapytań dla wszystkich języków innych niż angielski.
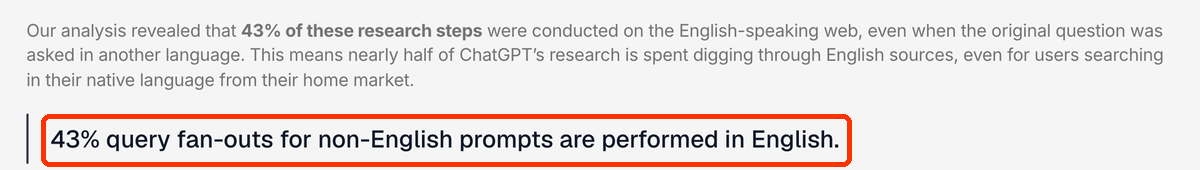
Kierunek się zgadza, liczby nie. Peec liczył wyszukiwania ze swojej platformy (ponad 10 mln) w lutym 2026, przed GPT-5.6 i GPT-6, i nie podaje, czy dane pochodzą z interfejsu, czy z API, ani jak rozpoznawał język. My liczyliśmy pojedyncze pytania przez API w październiku. Uczciwy wniosek brzmi: ChatGPT szuka po angielsku przy znacznej części polskich pytań, ale „prawie zawsze” nie jest dziś udokumentowane.
Rok i marka spoza pytania
GPT-6 dopisywał rok do podzapytania w 57% pytań, nawet gdy pytanie nie dotyczyło niczego, co się zmienia. Model szuka aktualnej wersji faktu: stawki, normy, ceny. Seer widział rok w 21,3% podzapytań Gemini 3, a markę w 26,4%. W naszym panelu marki w podzapytaniach to przede wszystkim producenci i serwisy, które model wybrał sam: przy pytaniu o kredyt we Wrocławiu GPT-6 sprawdzał site:oferteo.pl i stronę jednego doradcy z nazwiskiem. Kiedy rok w zapytaniu pomaga Twojej stronie, a kiedy podmiana daty szkodzi, opisujemy w rozdziale o świeżości treści.
Co z tym zrobić
- Fakty pod własnym adresem. Jeśli jesteś producentem albo usługodawcą, cena, specyfikacja i warunki muszą być na Twojej stronie w tekście, a nie tylko w PDF-ie czy grafice. Model idzie po nie operatorem
site:właśnie do Ciebie. Jak pisać akapity, które da się wyjąć, opisujemy w rozdziale o treści, którą AI cytuje. - Angielska wersja tylko tam, gdzie ma sens. Dla B2B, eksportu i tematów, które model i tak wyszukuje po angielsku (zdrowie, technologia), angielska wersja kluczowych stron poszerza pulę. Dla usług lokalnych nie tłumacz na zapas: w naszym pomiarze pytania lokalne prawie nie dostawały angielskich podzapytań.
- Bądź źródłem, na które model się powołuje. Jeśli w Twojej branży model idzie na stronę urzędu, Twoja strona powinna cytować ten sam akt czy rekomendację z linkiem. Wtedy jest zgodna z tym, co model potwierdza.
Weź listę podzapytań dla swojej frazy (jak ją zdobyć, pokazujemy niżej) i zaznacz te z site:. Zapisz domeny. Czy jest wśród nich Twoja? Czy na Twojej stronie jest w tekście informacja, której model szuka na tych domenach: cena, norma, parametr?
Druga powierzchnia cytowań: ranking na podzapytanie zamiast na pytanie
Strona może trafić do odpowiedzi AI, bo rankuje na podzapytanie, którego nikt nie wpisał, a nie na pytanie użytkownika. W badaniu AirOps 32,9% cytowanych stron rankowało wyłącznie na podzapytanie, a nie na oryginalne pytanie. Według Seer 95% podzapytań Gemini 3 nie ma żadnego wolumenu w narzędziach do słów kluczowych. Frazy z zerowym wolumenem w Senuto czy Ahrefs nie są więc bezwartościowe. Nie znaczy to jednak, że każda zasługuje na osobną stronę.
Mechanizm jest prosty. Model wysyła trzy podzapytania, dla każdego dostaje osobną listę wyników i z tych list wybiera strony do odpowiedzi. Jeśli Twoja strona jest wysoko na jedno z nich, dostaje szansę, nawet gdy na pytanie użytkownika stoi na trzeciej stronie wyników. Działa to też odwrotnie: pierwsze miejsce na frazę główną nie gwarantuje cytatu, jeśli model jej w ogóle nie wyszuka. W naszym pomiarze GPT-6 przy 97% pytań wysłał co najmniej jedno podzapytanie, ale żadne z nich nie powtarzało dosłownie pytania użytkownika.
Co wiadomo o Google
Ahrefs zmierzył, że tylko 37,9% adresów cytowanych w AI Overviews stoi w pierwszej dziesiątce wyników tego samego zapytania (badanie Ahrefs). Nie sprawdzał jednak wyników podzapytań, więc „reszta pochodzi z fan-outu” to hipoteza, a nie wynik. W naszym pomiarze polskich AI Overviews w przeglądarce (26 odpowiedzi, 12 października 2026 r.) 63% źródeł stało na pierwszej stronie wyników frazy głównej, a pierwszy wynik był cytowany w 23 z 26 przypadków. Ranking na frazę główną dalej się liczy, ale nie tłumaczy wszystkich cytatów.
AirOps zestawił cytaty ChatGPT z wynikami Google dla pytania i dla podzapytań (raport AirOps). Wniosek z liczb: jedna trzecia cytowanych stron nie rankowała na pytanie, ale rankowała na podzapytanie. Liczba 32,9% jest tylko na wykresie w raporcie, dlatego podajemy link zamiast zrzutu.
Nasz pomiar tej części jest niedomknięty
Chcieliśmy policzyć to samo dla polskich pytań: pobraliśmy wyniki Google dla każdej frazy bazowej i każdego podzapytania z panelu i porównaliśmy je z domenami cytowanymi przez modele. Zebraliśmy 614 z 1 037 wyników wyszukiwania, zanim dostawca danych zatrzymał serię na dziennym limicie. Przy tylu brakach ponad połowa cytatów nie ma kompletu danych, więc nie podajemy liczby. Uzupełnimy ją w tym rozdziale po dokończeniu pomiaru.
Co z tego wynika dla wyboru fraz
- Nie odrzucaj fraz z zerowym wolumenem. Długie, rzeczownikowe zapytania z rokiem i parametrem to dokładnie forma podzapytań. Wolumen w narzędziach ich nie widzi, a model je wysyła.
- Nie odsiewaj fraz po długości. Długość słabo przewiduje popyt: o wolumenie decyduje treść zapytania (marka, kategoria, parametr), a nie liczba słów.
- Sprawdzaj, gdzie stoisz na podzapytania, a nie tylko na frazę. Jeśli rankujesz na frazę, a na jej podzapytania nie, model może Cię nie zobaczyć. Procedura jest w następnej części.
Jak budować mapę fraz, w tym frazy bez wolumenu, opisujemy w lekcji analiza słów kluczowych.
Weź 3 podzapytania dla swojej najważniejszej frazy i wpisz je w Google w oknie incognito. Zapisz, na którym miejscu stoi Twoja strona. Jeśli na frazę główną jesteś w pierwszej trójce, a na podzapytania poza pierwszą dziesiątką, masz konkretną listę braków do uzupełnienia.
Query fan-out tool czy API: jak sprawdzić podzapytania swojej frazy
Są dwa rodzaje list podzapytań. Obserwowane pochodzą od samego modelu: z API Gemini, z API OpenAI, z raportu Grounding Queries w Bing Webmaster Tools albo z narzędzi, które je zbierają przez API. Wygenerowane tworzą symulatory typu „query fan out tool”: model zgaduje, co by wysłał. Pierwsze to dane, drugie to hipoteza. Gdy masz już listę, luki znajdziesz w Search Console tabelą przestawną: przy każdym podzapytaniu najlepsza pozycja Twojej strony albo informacja, że nie rankujesz wcale.
Skąd wziąć podzapytania
| Źródło | Rodzaj | Koszt | Ograniczenie |
|---|---|---|---|
API Gemini z wyszukiwaniem Google (pole webSearchQueries) | obserwowane | wg cennika API | to Gemini przez API, a nie AI Overviews ani AI Mode |
| API OpenAI z wyszukiwaniem | obserwowane | wg cennika API | bez historii i personalizacji z interfejsu |
| Usługi pośredniczące, np. DataForSEO LLM Responses (tego użyliśmy w pomiarze) | obserwowane | ok. 0,01–0,09 USD za odpowiedź, zależnie od modelu | jak wyżej; wynik zależy od dostawcy i dnia |
| Bing Webmaster Tools, raport Grounding Queries | obserwowane | bezpłatnie | zapytania, przy których Copilot cytował Twoją stronę; część to zapytania ludzi, a nie podzapytania; dane Binga, nie ChatGPT ani Google |
| Rozszerzenia przeglądarki czytające rozmowę | obserwowane | bezpłatnie | przestają działać, gdy interfejs ukryje podzapytania |
| Symulatory „query fan out tool” w narzędziach SEO | wygenerowane | w abonamencie | model zgaduje, nie ma kontaktu z prawdziwym wyszukiwaniem |
Rozszerzenia przez jakiś czas były najprostszą drogą, bo czytały podzapytania z rozmowy w ChatGPT. Nectiv opisał, że od GPT-5.4 interfejs je ukrył, a API nadal je zwraca (wpis Nectiv ze skryptem). Pamiętaj też, że fan-outów samego Google nie ma w Search Console. Dla AI Overviews i AI Mode zostaje symulacja albo przybliżenie przez API Gemini, które działa jako osobny system.
Procedura w czterech krokach
- Zbierz 5–10 pytań, które zadają klienci. Z rozmów sprzedażowych, maili, formularza kontaktowego, sekcji „Ludzie pytają też”. Pisz je tak, jak pyta człowiek, a nie jak fraza kluczowa.
- Pobierz podzapytania z dwóch modeli, każde pytanie dwa razy. W naszym pomiarze ten sam prompt w GPT-6 dawał przy kolejnych przebiegach prawie zupełnie inne podzapytania (podobieństwo zbiorów 0,05 w skali 0–1). Cytowane domeny pokrywały się już w ok. połowie (0,56). Pojedynczy przebieg to próbka, a nie lista.
- Wyczyść listę do 20–25 fraz na stronę. Usuń operator
site:i duplikaty, połącz warianty tego samego pytania. Pogrupuj resztę w motywy: definicje, porównania, ceny, wymagania, problemy. Motyw, który wraca w wielu pytaniach, jest ważniejszy niż pojedyncze, nawet bardzo długie podzapytanie. - Znajdź luki w Search Console. Wyeksportuj zapytania i strony z GSC za 3 miesiące. W arkuszu zrób tabelę przestawną: wiersze to frazy z listy, wartość to najmniejsza pozycja (MIN), a brak danych oznacz liczbą 100, czyli „nie rankuje”. Frazy z wartością 100 albo powyżej 20 to luki.
Ten proces opisał Zyppy (fan-out framework). W jego przykładzie lista urosła do ok. 400 pozycji, z czego zaobserwowanych było kilkanaście, a resztę wygenerował model. Luki okazały się głównie narzędziowe: brakowało kalkulatora czy podglądu. Skuteczności całego procesu nikt nie zmierzył. Traktuj go jako sposób uporządkowania pracy, a nie gwarancję cytatów.
Lista podzapytań to też dobry materiał do śledzenia widoczności w AI, ale samo śledzenie promptów ma swoje pułapki: odpowiedzi zmieniają się z dnia na dzień, więc pojedynczy odczyt niewiele mówi. Jeśli chcesz, żebyśmy przeprowadzili tę analizę dla Twojego serwisu i ułożyli z niej plan stron, zrobimy to w ramach strategii SEO.
Weź jedną stronę usługową i przejdź cztery kroki. Na koniec masz tabelę: podzapytanie, motyw, najlepsza pozycja w GSC. Policz, ile motywów ma pozycję 100. Jeśli więcej niż połowa, strona nie jest w puli większości wyszukiwań, które model robi przy tym temacie.
Query fan-out w SEO: mapa klastra, a nie lista nagłówków
Podzapytania pokazują, jakie pytania otaczają temat, ale nie każą upychać ich wszystkich na jednej stronie. W badaniu AirOps strony, które pokrywały 26–50% podzapytań, były cytowane w 38,2% przypadków, a strony pokrywające wszystkie podzapytania w 34,0%. Dopasowanie trzech–czterech nagłówków do podzapytań obniżało cytowanie o 6 punktów procentowych. Zasada robocza: jedna strona odpowiada na jedno główne pytanie, a pozostałe podzapytania trafiają do sekcji albo na strony klastra.
Wyniki AirOps są tylko na wykresach w raporcie (The Fan-Out Effect), więc podajemy link zamiast zrzutu. Wniosek jest sprzeczny z popularną radą, żeby „maksymalnie wyczerpać temat” na jednej stronie. Strona, która próbuje odpowiedzieć na wszystko, rzadziej ma akapit, który najlepiej pasuje do jednego konkretnego podzapytania. A model cytuje akapit, nie stronę.
Nasz pomiar dokłada drugi argument. Skoro podzapytania GPT-6 przy kolejnych przebiegach prawie się nie powtarzają, nagłówki dopasowane do jednej listy podzapytań będą pasować do następnej tylko przypadkiem. Stabilniejszy jest temat i encja: cytowane domeny powtarzały się między przebiegami w ok. połowie.
Ale strony szerokie też wygrywają
Kevin Indig na danych Gauge pokazał, że strony cytowane przez ChatGPT w największej liczbie promptów to przewodniki i porównania kategorii, a nie cienkie strony o jednym pytaniu. Jedna strona porównawcza learn.g2.com obsługiwała 65 promptów (analiza w Search Engine Journal). Ten sam autor na danych AirOps zaleca „najlepszą odpowiedź na jedno pytanie”. Oba wyniki się nie wykluczają. Skupiona strona częściej wygrywa konkretne pytanie, szeroka częściej pojawia się w wielu pytaniach. Wybór zależy od tego, co mierzysz.
Jest też kontrprzykład z drugiej strony. W eksperymencie SE Ranking z fikcyjną marką 30 krótkich stron po 500–750 słów dało 1 897 odpowiedzi AI z marką, a hub z dziesięcioma podlinkowanymi artykułami żadnej (opis eksperymentu). To była jednak nowa domena, jeden miesiąc i głównie Perplexity, który mocno premiuje świeżość. Na domenie z historią nikt tego nie powtórzył.
Jak użyć podzapytań do planu klastra
- Pogrupuj podzapytania w motywy (z procedury wyżej): definicje, porównania, ceny, wymagania, problemy, alternatywy.
- Najpierw przypisz motywy do istniejących stron. Większość trafi do sekcji stron, które już masz. Nowej strony nie zakładaj, zanim nie sprawdzisz, czy motywu nie obsługuje już inny adres.
- Motyw z własnym popytem i własną encją to kandydat na stronę klastra. Kryteria rozstrzygające opisujemy w następnej części.
- Połącz stronę główną tematu ze stronami klastra linkami w obie strony, z opisowym anchorem. Model widzi zwykle jedną stronę z domeny na odpowiedź, a linki pomagają wyszukiwarce wybrać właściwą.
Zasady linkowania wewnętrznego opisujemy w lekcji o optymalizacji on-page, a budowę akapitu-odpowiedzi w rozdziale o treści, którą AI cytuje.
Policz, ile nagłówków H2 na Twojej najważniejszej stronie to przepisane podzapytania albo frazy z narzędzia. Jeśli więcej niż połowa, sprawdź, czy któreś z nich nie jest osobnym pytaniem z własnym popytem. Takie pytanie lepiej przenieść na osobną stronę i podlinkować, niż trzymać jako jedną z dwudziestu sekcji.
Strona czy sekcja: test QDP na przykładzie sieci stron Double Digital
Pytanie zasługuje na osobną stronę, gdy spełnia większość z czterech kryteriów: ma popyt, dotyczy odrębnej encji, jego wyniki wyszukiwania różnią się od wyników sąsiednich zapytań i ma powtarzalny wzorzec, na przykład cenę, opinie czy problemy. Pozostałe pytania to sekcje istniejących stron. Na naszej sieci ok. 100 stron miejskich na usługę odsetek stron bez ani jednego wyświetlenia rósł, gdy malał popyt: 12% przy „pozycjonowanie {miasto}”, 38% przy „google ads {miasto}”, 45% przy „meta ads {miasto}”. Sam fakt, że model o coś zapytał, nie jest powodem do zakładania strony.
Test w czterech pytaniach
- Czy jest popyt? Sprawdź wyświetlenia frazy i jej wariantów w Search Console, a dla nowych tematów wolumen w Senuto lub innym narzędziu. Podzapytania AI bez wolumenu nie wystarczą: pokazują, czego model szuka, a nie czego szukają ludzie.
- Czy to odrębna encja? Inna usługa, inny produkt, inne miasto z własną ofertą, a nie wariant tej samej rzeczy innymi słowami. „Pompa ciepła do 150 m²” to wariant strony o doborze mocy, „pompa ciepła powietrze-woda” to osobny produkt.
- Czy wyniki wyszukiwania są inne? Wpisz obie frazy w Google i porównaj pierwszą dziesiątkę. Jeśli powtarza się większość adresów, Google traktuje je jako jedno pytanie i wystarczy jedna strona. To kryterium opisujemy szerzej w lekcji analiza słów kluczowych.
- Czy ma powtarzalny wzorzec? Czy ludzie pytają o tę rzecz w ten sam sposób, który da się obsłużyć szablonem: cena, opinie, porównanie, problemy? Sprawdź „Ludzie pytają też” i podpowiedzi wyszukiwarki.
Kryteria opisał Koray Tuğberk Gübür w artykule w Search Engine Land. W jego przykładzie kancelaria scaliła ok. 19 stron „usługa + dzielnica” ze stroną główną i w raporcie Search Console zyskała pozycje na 60 frazach, a straciła na 5. To raport autora, który sam prowadził projekt, i korelacja przy kilku zmianach naraz.
Nasz przypadek: sieć stron miejskich
Double Digital ma po ok. 100 stron miejskich dla kilku usług: pozycjonowania, Google Ads, Meta Ads i agencji marketingowej. Wszystkie powstały z jednego szablonu i różnią się miastem oraz częścią treści. Policzyliśmy w Search Console (28 dni, 15 września–12 października 2026 r.), ile wyświetleń mają frazy danej rodziny, np. „google ads” z nazwą miasta, w przeliczeniu na stronę, i ile stron nie miało ani jednego wyświetlenia.
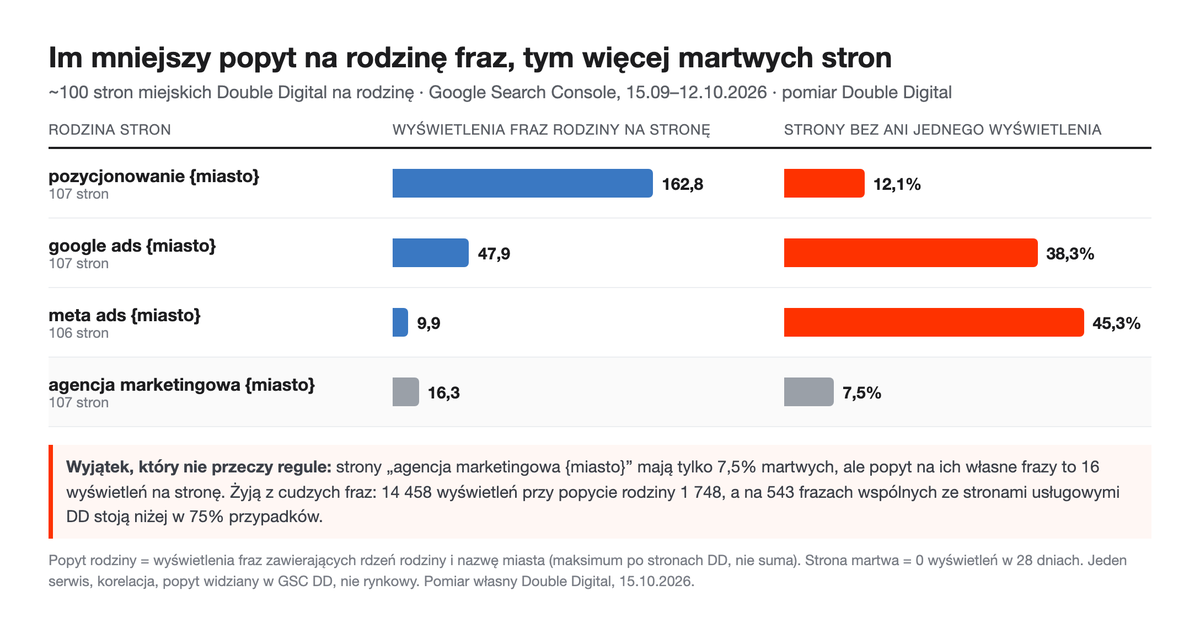
Zależność jest wyraźna. Rodzina z największym popytem ma najmniej martwych stron, a rodzina z najmniejszym prawie połowę. Przy „meta ads {miasto}” fraz z nazwą miasta szuka się tak mało, że dla większości miast osobna strona nie spełnia już pierwszego kryterium. Lepsza byłaby jedna strona usługi z sekcją o obsłudze lokalnej.
Strony „agencja marketingowa {miasto}” wyglądają na zdrowe: martwych jest tylko 7,5%. Ruch biorą jednak głównie z fraz innych rodzin. Na 543 frazach, na które stoją obok naszych stron usługowych, są niżej w 75% przypadków, a 43% ich wyświetleń pochodzi z fraz, na które wyżej stoi inna strona DD. Dwie strony na to samo pytanie zjadają się nawzajem, czyli dochodzi do kanibalizacji. W wyszukiwarkach AI działa to podobnie, bo odpowiedź zwykle pokazuje jedną stronę z domeny.
Scalić, przyciąć czy dobudować
| Sytuacja | Decyzja |
|---|---|
| Pytanie spełnia 3–4 kryteria, a strony nie ma | Strona klastra, podlinkowana ze strony głównej tematu |
| Pytanie spełnia 1–2 kryteria | Sekcja na istniejącej stronie, z akapitem-odpowiedzią |
| Dwie strony odpowiadają na to samo pytanie | Scal w mocniejszą i ustaw przekierowanie 301 ze słabszej |
| Strona bez wyświetleń od miesięcy i bez popytu | Przytnij: scal, przepisz albo wyłącz z indeksu. Content pruning to nie samo usuwanie |
Ostrożnie z masowymi stronami bez bramki. Przy sierpniowej aktualizacji antyspamowej w 2026 r. opisano serwis, który miał ok. 85% indeksu w stronach generowanych z szablonu i stracił ok. 60% widoczności w całej domenie, nie tylko w tej części. Są też dane w drugą stronę: według Orbit Media liczba wizyt botów AI rośnie z liczbą stron, ale odesłań z AI już nie. Więcej stron to więcej pobrań, a nie więcej cytatów.
Każdą z tych decyzji mierz przed i po: wyświetlenia, frazy w top 10 i kliknięcia z Search Console z 28 dni przed zmianą i 28 dni po niej, najlepiej obok grupy stron, których nie ruszałeś. Jeśli chcesz, żebyśmy przeprowadzili ten test na Twoim serwisie i zaplanowali strukturę stron, zrobimy to w ramach strategii SEO.
Weź grupę stron z jednego szablonu, np. strony miast, kategorii albo branż. W Search Console policz dla nich wyświetlenia z 28 dni i odsetek stron z zerem. Jeśli martwych jest więcej niż jedna trzecia, przejdź test czterech pytań dla kilku z nich, zanim dobudujesz kolejne.
FAQ — najczęściej zadawane pytania o query fan-out
- Czy query fan-out da się śledzić w Google Search Console?
Nie. Podzapytania AI Overviews i AI Mode nie trafiają do Search Console, bo nie wpisuje ich człowiek. Potwierdził to John Mueller z Google. Podzapytania innych modeli zobaczysz przez API Gemini i OpenAI. Bing Webmaster Tools pokazuje w raporcie Grounding Queries zapytania, przy których Copilot cytował Twoją stronę. Dla Google zostają symulacje i pośrednie wskazówki.
- Ile podzapytań robi Google AI Mode?
Nie wiadomo. Google tego nie podaje, a publiczne liczby się rozjeżdżają. Nectiv zmierzył średnio 9,06 podzapytania w Google w 2025 r., Seer 10,7 dla Gemini 3 przez API z wymuszonym wyszukiwaniem. iPullRank podaje w tabeli „10+”, a na własnym nagraniu pokazuje 4 wyszukania. Gemini 3.8 Flash w naszym pomiarze bez wymuszenia nie szukał przy dwóch trzecich polskich pytań.
- Czy tłumaczyć stronę na angielski pod ChatGPT?
Tylko tam, gdzie ma to sens biznesowy. Przy polskich pytaniach ChatGPT (GPT-6) wysłał co najmniej jedno angielskie podzapytanie w 42% przypadków, najczęściej przy poradach zdrowotnych i technicznych, a przy pytaniach lokalnych tylko w 4%. Dla B2B, eksportu i branż, w których model szuka po angielsku, angielska wersja kluczowych stron poszerza pulę. Dla usług lokalnych najpierw zmierz, czy model w ogóle szuka po angielsku w Twojej branży.
- Czy topical authority działa w wyszukiwarkach AI?
Nie wprost. Organic Labs sprawdził 134 kategorie B2B SaaS: domena z największym udziałem w ruchu z Google była w modelach AI średnio o 3,65 pozycji niżej, a korelacja z rankingiem w Google była słaba i nieistotna statystycznie (r = 0,145). Tylko Perplexity, który mocno opiera się na wyszukiwaniu, wyraźniej szedł za Google. To jeden pomiar w jednej branży, ale pokazuje, że pokrycie tematu w Google nie przenosi się automatycznie na odpowiedzi AI.
Fan-out w ośmiu zdaniach
- 01Fan-out to kilka własnych zapytań modelu do wyszukiwarki; w Search Console ich nie zobaczysz.
- 02Przy polskim pytaniu ChatGPT (GPT-6) wysyła średnio 3,3 podzapytania, nie 7–8 z badań na angielskich promptach.
- 03Gemini 3.8 Flash bez wymuszenia nie szukał w sieci przy dwóch trzecich polskich pytań.
- 0470% podzapytań GPT-6 ma operator site: — model z góry wybiera urząd albo producenta i tam sprawdza fakty.
- 05W 42% polskich pytań GPT-6 szukał też po angielsku; przy pytaniach lokalnych prawie nigdy.
- 06Ten sam prompt daje za każdym razem inne podzapytania: optymalizuj pod temat i encję, nie pod listę zapytań.
- 07Podzapytania bierz z API albo Bing Webmaster Tools; symulator „fan-out tool” to hipoteza, nie dane.
- 08Osobna strona tylko przy popycie, odrębnej encji i innych wynikach wyszukiwania — reszta to sekcje.
Ciąg dalszy przewodnika.
SEO, paid media i strategie widoczności w Double Digital