Nawigacja Fasetowa w SEO: Kompletny Przewodnik dla Sklepów Internetowych
Faceted navigation (nawigacja fasetowa) to system filtrów produktów w sklepach internetowych, który umożliwia użytkownikom zawężanie wyników według różnych kryteriów: ceny, koloru, rozmiaru, marki, dostępności i wielu innych. To nieoceniane narzędzie UX, ale bez odpowiedniego zarządzania staje się koszmarem SEO e-commerce.

Dlaczego nawigacja fasetowa to problem?
Wyobraź sobie sklep z 1,000 produktów i 5 filtrów, z których każdy ma 5 opcji. Matematyka jest brutalna:
5^5 = 3,125 potencjalnych kombinacji URL
Dla Google każda kombinacja to osobna strona do:
- Crawlowania (zużycie crawl budget)
- Indeksowania (index bloat)
- Rankowania (duplicate content issues)
Realny przykład: Sklep z obuwiem miał 50,000 zaindeksowanych stron, z czego 45,000 to kombinacje filtrów generujące identical lub near-duplicate content. Rezultat:
- 90% crawl budget marnowane na bezwartościowe URL-e
- Spadek pozycji głównych kategorii o 15-30%
- Confused search signals dla Google
Podstawowy dylemat
User Experience wymaga filtrów → Klienci chcą szybko znaleźć „czerwone buty Nike rozmiar 38”
SEO wymaga kontroli → Google nie powinno indeksować tysięcy podobnych stron
Rozwiązanie: Strategiczne zarządzanie faceted navigation poprzez:
- Canonical tags – konsolidacja sygnałów rankingowych
- Robots.txt – blokowanie crawlowania niepotrzebnych parametrów
- Meta noindex – crawlowanie bez indeksowania
- Selective indexing – indeksowanie tylko wartościowych kombinacji
Prawidłowa implementacja nawigacji fasetowej może dramatycznie poprawić wyniki pozycjonowania całego sklepu!
Trzy Fundamentalne Metody Zarządzania Faceted Navigation
Metoda 1: Canonical Tag – Konsolidacja Sygnałów Rankingowych
Czym jest canonical tag?
Element HTML wskazujący Google, która wersja strony jest „oryginalna” gdy istnieje wiele podobnych URL-i.
Przykład:
<!– Na stronie /buty/?color=czerwony&size=38 –>
<link rel=”canonical” href=”https://example.com/buty/” />
Co to oznacza dla Google: „Ta strona z filtrami to wariant głównej kategorii /buty/ – wszystkie sygnały rankingowe (linki, autorytet) przypisz do głównego URL-a.”
Kiedy stosować canonical?
✅ Używaj, gdy:
- Strona z filtrem jest podobna do wersji bez filtrów
- Chcesz, aby Google traktował wszystkie warianty jako jedną stronę
- Filtry nie zmieniają fundamentalnie treści (sortowanie, widok)
- Kombinacja filtrów nie ma samodzielnej wartości SEO
❌ Nie używaj, gdy:
- Kombinacja filtrów ma unique value (np. „laptopy do gier do 5000 zł”)
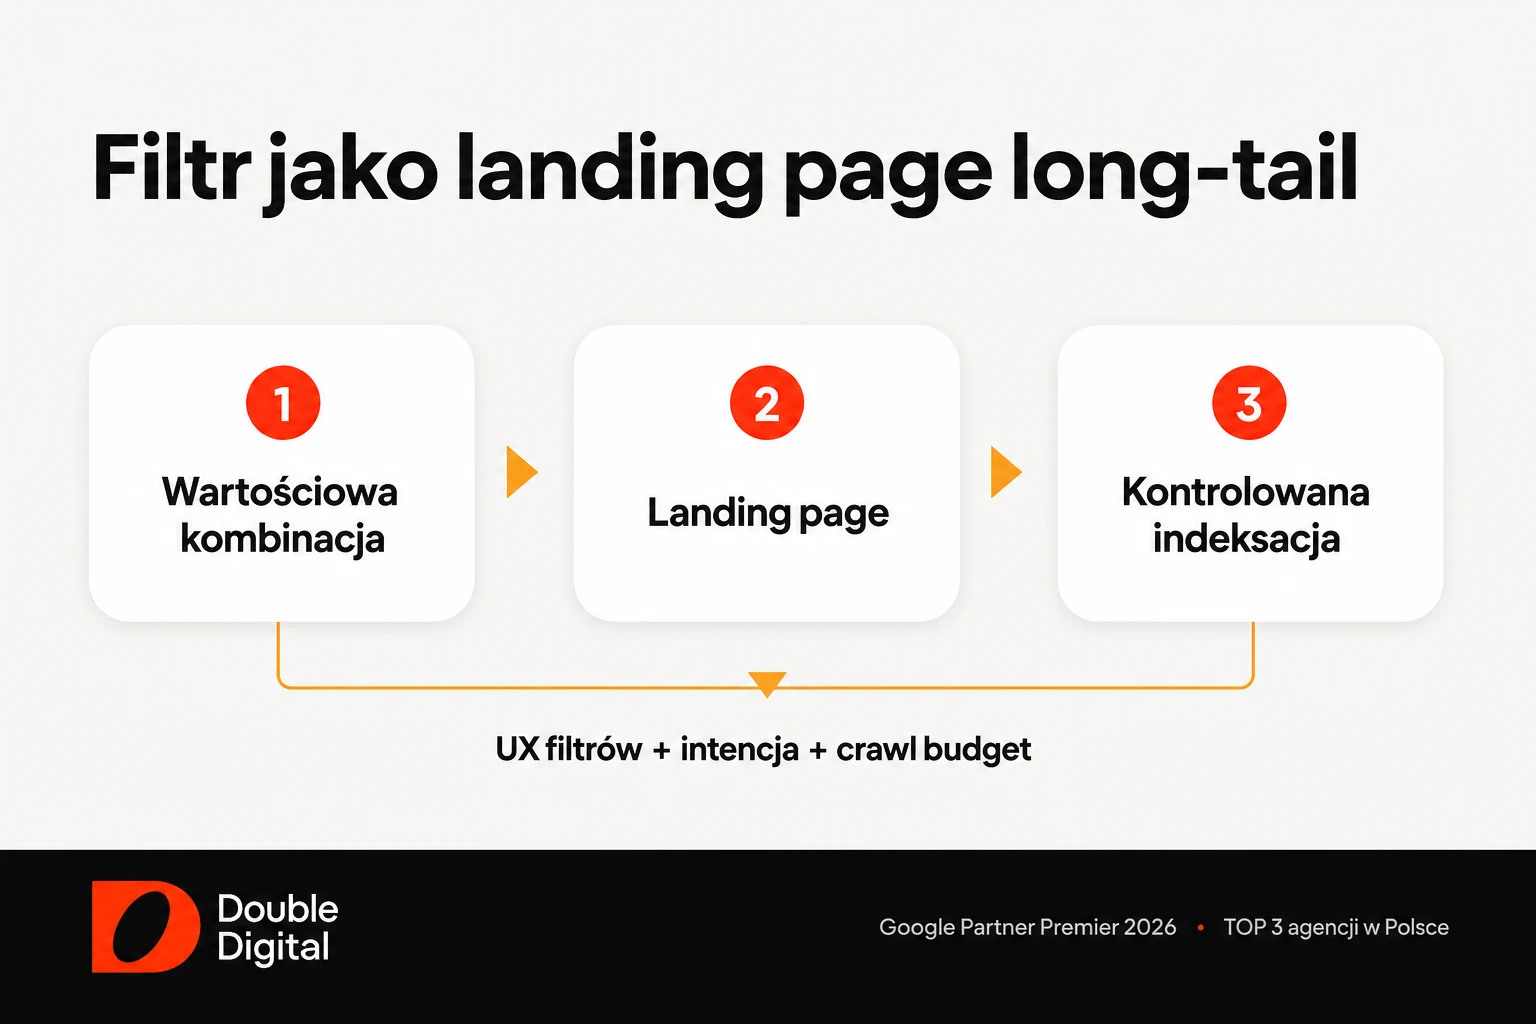
- Chcesz indeksować tę konkretną kombinację dla long-tail keywords
- Strona z filtrem zawiera unikalny content
Rodzaje canonical
1. Self-referencing canonical Każda strona wskazuje na siebie:
<!– Na https://example.com/buty/ –>
<link rel=”canonical” href=”https://example.com/buty/” />
Zastosowanie: Główne kategorie, produkty – zapobiega problemom z parametrami trackingowymi.
2. Canonical do głównej kategorii Filtry wskazują na czystą kategorię:
<!– Na /buty/?color=czerwony –>
<link rel=”canonical” href=”https://example.com/buty/” />
Zastosowanie: Pojedyncze filtry bez wartości SEO.
3. Canonical do najbliższej wartościowej strony
<!– Na /buty/?color=czerwony&size=38&brand=nike –>
<link rel=”canonical” href=”https://example.com/buty-nike/” />
Zastosowanie: Zaawansowane kombinacje – kieruj do najbardziej relevant premium page.
Częste błędy z canonical
❌ Canonical conflict: Jedna strona otrzymuje canonical z wielu innych stron o różnej treści ❌ Canonical chains: A → B → C (Google przetwarza tylko pierwszy link) ❌ Canonical + noindex: Nigdy nie łącz – sprzeczne sygnały dla Google ❌ Cross-domain canonical bez powodu: Tracisz cały link equity
Weryfikacja canonical:
- Sprawdź źródło strony (View Page Source)
- Szukaj <link rel=”canonical”
- Zweryfikuj w Google Search Console → Page Indexing → Inspect URL
Metoda 2: Robots.txt – Blokowanie Crawlowania
Czym jest robots.txt?
Plik tekstowy w głównym katalogu witryny instruujący roboty wyszukiwarek, których URL-i nie crawlować.
Lokalizacja: https://example.com/robots.txt
Kiedy używać robots.txt dla filtrów?
✅ Używaj, gdy:
- Parametry nie mają żadnej wartości SEO (sortowanie, sesja, tracking)
- Chcesz całkowicie wykluczyć URL-e z crawlowania
- Oszczędzasz crawl budget – najskuteczniejsza metoda
❌ Nie używaj, gdy:
- Google potrzebuje odkryć produkty przez te URL-e
- Kombinacja może mieć wartość SEO w przyszłości
- Chcesz, aby linki internal przekazywały PageRank (robots.txt blokuje crawl = blokuje link equity)
Składnia dla parametrów filtrów
Blokowanie konkretnego parametru:
User-agent: *
Disallow: /*?*sort=
Disallow: /*?*view=
Wyjaśnienie:
- /* = każdy URL na stronie
- ?* = zawierający query string
- sort= = z konkretnym parametrem
Blokowanie wielu wartości jednego parametru:
Disallow: /*?*color=czerwony
Disallow: /*?*color=niebieski
Disallow: /*?*color=zielony
Blokowanie wszystkich kombinacji określonych parametrów:
Disallow: /*?*color=
Disallow: /*?*size=
Disallow: /*?*price=
Przykład: Robots.txt dla sklepu z odzieżą
User-agent: *
# Blokuj parametry sortowania
Disallow: /*?*sort=
Disallow: /*?*order=
Disallow: /*?*dir=
# Blokuj parametry widoku
Disallow: /*?*view=
Disallow: /*?*mode=
Disallow: /*?*limit=
# Blokuj parametry sesji
Disallow: /*?*SID=
Disallow: /*?*sessionid=
# Pozwól na paginację
Allow: /*?p=
Allow: /*?page=
# Blokuj kombinacje wielu filtrów (2+)
Disallow: /*?*color=*&size=
Disallow: /*?*size=*&color=
Sitemap: https://example.com/sitemap.xml
Kluczowa zasada: Allow vs Disallow
Order matters! Google przetwarza najbardziej specific rules najpierw.
Przykład:
User-agent: *
Allow: /*?page=
Disallow: /*?
# Rezultat: Parametr ?page= BĘDZIE crawlowany
# Wszystkie inne parametry BĘDĄ blokowane
Testowanie robots.txt
ZAWSZE testuj przed wdrożeniem!
- Google Search Console → robots.txt Tester
- Wklej zawartość robots.txt
- Testuj konkretne URL-e z parametrami
- Sprawdź, czy Allow/Disallow działa zgodnie z intencją
Monitorowanie efektów robots.txt
Po wdrożeniu monitoruj:
- GSC → Settings → Crawl stats – czy liczba crawled pages spadła?
- Log file analysis – czy Googlebot przestał crawlować zablokowane parametry?
- Indexing status – już zaindeksowane strony z zablokowanymi parametrami mogą pozostać w indeksie (użyj dodatkowo noindex lub URL removal)
Metoda 3: Meta Noindex – Crawlowanie Bez Indeksowania
Czym jest meta noindex?
Tag HTML instruujący Google: „Możesz crawlować i odkrywać linki na tej stronie, ale nie dodawaj jej do indeksu wyszukiwarki.”
Składnia:
<meta name=”robots” content=”noindex, follow” />
Wyjaśnienie:
- noindex = nie indeksuj tej strony
- follow = przetwarzaj linki na tej stronie (odkrywaj produkty)
Kiedy używać meta noindex?
✅ Używaj, gdy:
- Google musi odkryć produkty przez filtrowane strony
- Kombinacja filtrów nie ma wartości SEO, ale prowadzi do wartościowych produktów
- Chcesz uniknąć duplicate content bez blokowania crawlowania
- Masz ograniczony crawl budget, ale musisz balansować discovery
❌ Nie używaj, gdy:
- Strona ma wartość SEO i powinna rankować (użyj canonical lub indeksuj)
- Chcesz całkowicie zaoszczędzić crawl budget (lepiej robots.txt)
- Łączysz z canonical (sprzeczne sygnały)
Warianty meta robots
Podstawowe kombinacje:
<!– Nie indeksuj, ale przetwarzaj linki –>
<meta name=”robots” content=”noindex, follow” />
<!– Nie indeksuj i nie przetwarzaj linków (rzadko używane) –>
<meta name=”robots” content=”noindex, nofollow” />
<!– Indeksuj, ale nie przetwarzaj linków (bardzo rzadko) –>
<meta name=”robots” content=”index, nofollow” />
Dla faceted navigation najczęściej:
<meta name=”robots” content=”noindex, follow” />
Zaawansowane: Conditional noindex
Strategia: Noindex tylko dla 2+ filtrów jednocześnie.
Logika:
- 1 filtr → może mieć wartość (np. „buty Nike”)
- 2+ filtry → thin content, niska wartość SEO
Implementacja (pseudo-kod):
IF liczba_aktywnych_filtrów >= 2 THEN
dodaj <meta name=”robots” content=”noindex, follow”>
END IF
Różnica: Noindex vs Robots.txt
| Aspekt | Meta Noindex | Robots.txt |
| Crawlowanie | ✅ Tak | ❌ Nie |
| Indeksowanie | ❌ Nie | ⚠️ Może (jeśli już w indeksie) |
| Link equity | ✅ Przekazuje | ❌ Blokuje |
| Discovery produktów | ✅ Tak | ❌ Nie |
| Crawl budget saving | ⚠️ Częściowe | ✅ Maksymalne |
Kluczowa różnica:
- Robots.txt: „Nie przychodź tutaj w ogóle”
- Noindex: „Przyjdź, zobacz linki, ale nie indeksuj tej strony”
Monitorowanie noindex
Google Search Console → Page Indexing → Why pages aren’t indexed
Sprawdź kategorię: „Excluded by 'noindex’ tag”
- Jeśli widzisz setki/tysiące stron – OK, strategia działa
- Jeśli widzisz wartościowe strony – błąd! Usuń noindex
Kompleksowa Strategia: Łączenie Trzech Metod
Prawdziwa moc pojawia się, gdy strategicznie kombinujesz wszystkie trzy metody dla różnych typów parametrów.
Framework decyzyjny
Krok 1: Sklasyfikuj parametry według wartości SEO
| Typ parametru | Wartość SEO | Przykłady |
| High-value | ✅ Wysoka | Marka, kategoria główna, popularne kombinacje |
| Medium-value | ⚠️ Średnia | Pojedyncze filtry (kolor, rozmiar) |
| Low-value | ❌ Niska | Sortowanie, widok, limit wyników |
| No-value | ❌ Żadna | Session ID, tracking, parametry techniczne |
Krok 2: Przypisz metodę do każdej kategorii
| Wartość SEO | Metoda | Indeksacja | Crawlowanie |
| High-value | ✅ Index + optimize | Tak | Tak |
| Medium-value | 🔗 Canonical do głównej | Nie | Tak |
| Low-value | 🚫 Noindex, follow | Nie | Tak |
| No-value | 🛑 Robots.txt block | Nie | Nie |
Przykład: Strategia dla sklepu z elektroniką
Kategoria: Laptopy
High-value combinations (Index):
- /laptopy-do-gier/ (dedykowany URL slug)
- /laptopy-dell/ (popularna marka)
- /laptopy-do-5000-zl/ (popularny przedział cenowy)
Akcja: Stwórz dedykowane landing pages, indeksuj, promuj w sitemap.
Medium-value (Canonical):
- /laptopy/?brand=hp
- /laptopy/?ram=16gb
- /laptopy/?screen=15inch
Akcja: Canonical do /laptopy/, crawlowalne dla odkrywania produktów.
Low-value (Noindex):
- /laptopy/?brand=dell&ram=16gb (2 filtry)
- /laptopy/?color=silver&price=3000-4000&processor=i7 (3+ filtry)
Akcja: <meta name=”robots” content=”noindex, follow”>, crawlowalne ale nie indeksowane.
No-value (Robots.txt):
- /laptopy/?sort=price_asc
- /laptopy/?view=grid
- /laptopy/?limit=48
Akcja: Zablokuj w robots.txt – zero crawl budget waste.
Audyt Faceted Navigation – Jak Zmierzyć Problem?
Zanim wdrożysz jakąkolwiek strategię, musisz zmierzyć skalę problemu.
Krok 1: Google Search Console Analysis
Coverage Report:
- GSC → Indexing → Pages
- Sprawdź Indexed pages vs Excluded pages
- Filtruj po URL patterns (np. zawierające ?color=, ?size=)
Co szukać:
- Wysoka liczba zaindeksowanych URL-i z parametrami
- Duplicate meta descriptions/titles
- Strony z low/no traffic (Google indeksuje, ale nie rankują)
Crawl Stats:
- GSC → Settings → Crawl stats
- Sprawdź total crawl requests
- Porównaj crawl requests per day przed/po optymalizacji
Cel: Zidentyfikować, ile crawl budget jest marnowane na filtry.
Krok 2: Screaming Frog lub Search Atlas Crawl
Narzędzia:
Co sprawdzić:
- Liczba unikalnych URL-i z parametrami
- Screaming Frog → Internal → Filter by query string
- Duplicate content
- Sprawdź meta descriptions/titles/H1
- Identyczne lub niemal identyczne
- Canonical implementation
- Ile stron ma canonical?
- Czy canonical wskazuje poprawnie?
- Self-referencing na głównych kategoriach?
- Noindex status
- Filtruj po meta robots = „noindex”
- Sprawdź, czy są na właściwych stronach
- Indexability issues
- Orphan pages (bez internal links)
- Noindex + canonical (sprzeczność)
- Blocked by robots.txt but indexed
Krok 3: Log File Analysis (zaawansowane)
Dlaczego warto:
- GSC pokazuje sample data
- Log files pokazują wszystkie requests od Googlebot
Narzędzia:
Co analizować:
- Które URL-e Googlebot crawluje najczęściej?
- Czy to wartościowe strony czy filtry?
- Crawl budget distribution
- % requests na produkty vs kategorie vs filtry
- Response codes dla filtrów
- Czy zwracają 200 (OK)?
- Czy canonical jest respektowany?
- Trendy crawl frequency
- Czy po wdrożeniu robots.txt crawl filtrów spadł?
Benchmark Metrics
Przed optymalizacją (typowy problem site):
- 70% crawl budget na filtry i thin pages
- 50,000+ zaindeksowanych URL-i (z czego 40,000 to filtry)
- Średnio 5 visits/miesiąc per filtered page
- Duplicate content warnings w GSC
Po optymalizacji (target metrics):
- 80% crawl budget na wartościowe strony (produkty, kategorie premium)
- <5,000 zaindeksowanych URL-i (głównie produkty + top kategorie)
- Filtered pages: canonical lub noindex
- Zero duplicate content issues
Implementacja Techniczna dla Różnych Platform E-commerce
Shopify – Zarządzanie Filtrami
Problem: Shopify domyślnie generuje parametryzowane URL-e dla filtrów bez kontroli SEO.
Rozwiązanie 1: Canonical w Shopify theme
Edytuj theme.liquid w sekcji <head>:
{% if collection %}
{% if current_tags.size > 0 or collection.sort_by %}
<link rel=”canonical” href=”{{ shop.url }}{{ collection.url }}” />
{% else %}
<link rel=”canonical” href=”{{ canonical_url }}” />
{% endif %}
{% endif %}
Co to robi: Jeśli kolekcja ma aktywne tagi (filtry) lub sortowanie, canonical wskazuje na czystą kolekcję bez parametrów.
Rozwiązanie 2: Robots.txt w Shopify
Shopify pozwala edytować robots.txt przez theme.liquid:
Dodaj blok robots.txt w theme.liquid:
User-agent: *
# Blokuj parametry sortowania
Disallow: /collections/*?*sort_by=
# Blokuj widoki
Disallow: /collections/*?*view=
# Pozwól na paginację
Allow: /collections/*?page=
Sitemap: {{ shop.url }}/sitemap.xml
Ważne: Shopify automatycznie generuje sitemap.xml, więc upewnij się, że filtry nie są w sitemap.
Rozwiązanie 3: Shopify Apps dla zaawansowanej kontroli
- Smart SEO – automatyczny canonical dla filtrów
- SEO Manager – bulk editing meta tags, noindex rules
- Plug in SEO – audyt i automatyzacja SEO fixes
Best practices dla Shopify:
- Używaj natywnych collection pages dla top combinations
- Canonical dla wszystkich filter/sort variations
- Nie twórz zbyt wielu collections – Shopify ma limity
Magento – Zaawansowana Kontrola Layered Navigation
Przewaga Magento: Natywne SEO settings dla layered navigation.
Konfiguracja w Magento Admin:
- Stores → Configuration → Catalog → Catalog → Search Engine Optimization
- Ustaw:
- Use Canonical Link Meta Tag for Categories: Yes
- Use Canonical Link Meta Tag for Products: Yes
Co to robi: Automatycznie dodaje self-referencing canonical do głównych kategorii i produktów.
Layered Navigation Settings:
Stores → Configuration → Catalog → Layered Navigation
- Price Navigation Step Calculation: Automatic/Manual (kontrola przedziałów cenowych)
- Display Product Count: Yes/No (UX decyzja)
Dla zaawansowanej kontroli: Stwórz custom module zarządzający canonical i noindex dynamicznie.
Robots.txt dla Magento:
User-agent: *
# Blokuj parametry filtrów
Disallow: /*?*price=
Disallow: /*?*color=
Disallow: /*?*size=
Disallow: /*?*manufacturer=
# Blokuj sortowanie i wyświetlanie
Disallow: /*?*product_list_order=
Disallow: /*?*product_list_mode=
Disallow: /*?*product_list_limit=
# Pozwól na paginację
Allow: /*?p=
Sitemap: https://example.com/sitemap.xml
Google Search Console – URL Parameters
W GSC możesz skonfigurować jak Google traktuje parametry:
- price → Narrows (zawęża wyniki)
- color → Narrows
- product_list_order → Sorts (sortuje)
Uwaga: Google przestał oficjalnie wspierać URL Parameters tool, ale ustawienia mogą być respektowane dla starszych witryn.
Best practices dla Magento:
- Wykorzystaj natywne SEO settings jako bazę
- Dla zaawansowanej kontroli rozważ custom module
- Regularnie sprawdzaj logi serwera – Magento może generować tysiące kombinacji
- Używaj Varnish cache z intelligent cache rules dla filtrowanych URL-i
WooCommerce – WordPress SEO dla Filtrów
Problem: WooCommerce domyślnie indeksuje wszystkie filtry bez kontroli.
Rozwiązanie 1: Canonical w functions.php
Dodaj do functions.php child theme:
function custom_woocommerce_canonical() {
if (is_shop() || is_product_category() || is_product_taxonomy()) {
$filter_params = array(’filter_color’, 'filter_size’, 'filter_price’, 'orderby’);
$has_filters = false;
foreach ($filter_params as $param) {
if (isset($_GET[$param])) {
$has_filters = true;
break;
}
}
if ($has_filters) {
global $wp;
$clean_url = home_url($wp->request);
echo '<link rel=”canonical” href=”’ . esc_url($clean_url) . '” />’;
}
}
}
add_action(’wp_head’, 'custom_woocommerce_canonical’, 1);
Rozwiązanie 2: Noindex dla kombinacji filtrów
function custom_woocommerce_noindex_filters() {
if (is_shop() || is_product_category()) {
$filter_count = 0;
$filter_params = array(’filter_color’, 'filter_size’, 'filter_price’, 'filter_brand’);
foreach ($filter_params as $param) {
if (isset($_GET[$param])) {
$filter_count++;
}
}
// Noindex dla 2+ filtrów
if ($filter_count >= 2) {
echo '<meta name=”robots” content=”noindex, follow” />’;
}
}
}
add_action(’wp_head’, 'custom_woocommerce_noindex_filters’, 1);
Rozwiązanie 3: Robots.txt dla WooCommerce
User-agent: *
# Blokuj parametry filtrów WooCommerce
Disallow: /sklep/?*filter_
Disallow: /*?*filter_color=
Disallow: /*?*filter_size=
Disallow: /*?*min_price=
Disallow: /*?*max_price=
# Blokuj sortowanie
Disallow: /*?*orderby=
# WordPress core
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://example.com/wp-sitemap.xml
Pluginy WooCommerce dla SEO filtrów:
Yoast SEO + Yoast WooCommerce SEO:
- Zaawansowana kontrola canonical
- Opcje noindex według reguł
- Integracja z WooCommerce taxonomies
RankMath:
- Podobne funkcje do Yoast
- Bardziej intuitive UI
- Większość funkcji dostępna w darmowej wersji
Konfiguracja:
- RankMath → General Settings → WooCommerce
- Enable canonical dla shop pages
- Noindex dla filtered pages
Zaawansowane: AJAX Filtering
Rozważ AJAX-based filtering dla najlepszego UX i SEO:
- Zero generowania nowych URL-i
- Błyskawiczne filtrowanie
- Możliwość bookmarkowania przez history.pushState
- Kompletna kontrola nad indexation
Best practices dla WooCommerce:
- Używaj canonical LUB noindex (nigdy obu razem)
- Testuj na staging przed wdrożeniem na produkcję
- Rozważ AJAX filtering dla najlepszego UX/SEO balance
- Używaj child theme dla wszystkich customizacji
Porównanie Platform
| Aspekt | Shopify | Magento | WooCommerce |
| Natywne SEO controls | ⚠️ Podstawowe | ✅ Zaawansowane | ⚠️ Brak (wymaga pluginów) |
| Łatwość konfiguracji | ✅ Prosta | ❌ Skomplikowana | ⚠️ Średnia |
| Elastyczność | ⚠️ Ograniczona | ✅ Pełna | ✅ Wysoka |
| Wymagane umiejętności | Podstawy SEO | Magento architecture | WordPress + PHP |
| Najlepsze dla | Małe/średnie sklepy | Enterprise | Małe/średnie, WordPress users |
Long-Tail Keywords: Jak Wykorzystać Filtry do Zwiększenia Ruchu
Faceted navigation to nie tylko wyzwanie – to także ogromna szansa na pozyskanie ruchu z niszowych long-tail keywords.
Dlaczego long-tail keywords są wartościowe?
Charakterystyka:
- Niższa konkurencja – łatwiej pozycjonować
- Wyższy intent – użytkownicy wiedzą czego szukają
- Lepszy conversion rate – precyzyjne zapytania
- Stabilniejszy ruch – mniej wrażliwe na zmiany algorytmu
Przykład:
- Short-tail: „buty damskie” (50,000 wyszukiwań/m, wysoka konkurencja, CR 1%)
- Long-tail: „czerwone buty damskie nike 38” (50 wyszukiwań/m, niska konkurencja, CR 8%)
Jak filtry odpowiadają long-tail queries?
Użytkownik szukający „laptopy do gier do 5000 zł 16gb ram” naturalnie trafi na:
/laptopy/?category=gaming&price=0-5000&ram=16gb
Jeśli ta strona jest zoptymalizowana – może rankować na niszową frazę.
Krok 1: Identyfikuj wartościowe kombinacje
Metoda 1: Keyword Research
Narzędzia:
- Ahrefs Keywords Explorer
- Semrush Keyword Magic Tool
- Senuto (polski rynek)
Proces:
- Zacznij od głównej kategorii (np. „smartfony”)
- Dodaj modyfikatory:
- „smartfony samsung”, „smartfony do 1000 zł”
- Połącz modyfikatory:
- „smartfony samsung do 2000 zł”
Kryteria selekcji:
- Search volume: min 10-50 wyszukiwań/miesiąc
- Keyword Difficulty: <30 (Ahrefs)
- Business value: czy użytkownicy kupują?
- Dostępność produktów: min 5-10 produktów
Metoda 2: Google Search Console
- GSC → Performance
- Filtruj queries zawierające nazwy atrybutów
- Sortuj według impressions
- Zidentyfikuj high impressions + low clicks = opportunity
Przykład:
- Query: „czerwone sukienki wieczorowe”
- Impressions: 5,000/m, Clicks: 50, Position: 15
- Akcja: Stwórz dedykowaną stronę, zwiększ ruch do ~250 clicks/m
Metoda 3: Analiza Konkurencji
Ahrefs Site Explorer:
- Wpisz domenę konkurenta
- Filtruj organic keywords po URL-ach z filtrami
- Zidentyfikuj traffic-generating filtered pages
Krok 2: Stwórz Wartościowe Landing Pages
Nie wystarczy pozwolić Google zaindeksować parametry – musisz stworzyć dedykowane, zoptymalizowane strony.
Strategia 1: Clean URL Slugs
Zamiast:
/laptopy/?category=gaming&price=0-5000
Stwórz:
/laptopy-do-gier-do-5000-zl/
Korzyści:
- Lepszy UX (czysty URL)
- Łatwiejsza optymalizacja
- Możliwość unikalnej treści
- Canonical z parametryzowanych wersji wskazuje tutaj
Strategia 2: Dodaj Unikalny Content
Co dodać:
✅ Zoptymalizowany H1:
- Zamiast: „Laptopy (243)”
- Lepiej: „Laptopy do Gier do 5000 zł – Najlepsze Modele 2025”
✅ Unique description (200-400 słów):
- Wprowadzenie do kategorii
- Kluczowe cechy produktów
- Porady zakupowe
- FAQ
✅ Meta tagi:
<title>Laptopy do Gier do 5000 zł – Ranking 2025 | TwojaFirma</title>
<meta name=”description” content=”✅ TOP laptopy do gier do 5000 zł ✅ GTX/RTX ✅ Wysoka wydajność ➤ Sprawdź ranking!” />
✅ Schema markup:
{
„@context”: „https://schema.org”,
„@type”: „CollectionPage”,
„name”: „Laptopy do Gier do 5000 zł”
}
Strategia 3: Internal Linking
Na stronie /laptopy/:
<h3>Popularne kategorie laptopów:</h3>
<ul>
<li><a href=”/laptopy-do-gier-do-5000-zl/”>Laptopy do gier do 5000 zł</a></li>
<li><a href=”/laptopy-dell-17-cali/”>Laptopy Dell 17″</a></li>
</ul>
Krok 3: Balansuj Indeksację vs Crawl Budget
Tier System:
Tier 1: Premium (10-50 stron)
- Dedykowane URL slugs
- 400+ słów unique content
- Zaindeksowane, w sitemap
- Strong internal linking
Tier 2: Semi-optimized (50-200 stron)
- Parametryzowane URL lub slug
- 100-200 słów opisu
- Zaindeksowane, ale nie w sitemap
Tier 3: Discoverable, nie indexed (reszta)
- Parametryzowane URL
- Crawlowalne
- Noindex
Tier 4: Blocked (infinite combinations)
- Robots.txt
- Zero value combinations
Kluczowe Wnioski
5 Najważniejszych Zasad
1. Faceted navigation wymaga strategicznego zarządzania
- Bez kontroli = katastrofa SEO
- Z odpowiednim podejściem = przewaga konkurencyjna
2. Nie ma jednego rozwiązania
- Canonical – konsolidacja sygnałów
- Robots.txt – blokowanie crawlowania
- Noindex – crawlowanie bez indeksowania
- Sukces = strategiczny mix wszystkich trzech
3. Audyt to fundament
- GSC, Screaming Frog, log files
- Zmierz baseline przed zmianami
- Monitoruj przez min 8 tygodni
4. Long-tail opportunity
- Strategic indexing wybranych kombinacji
- Dedykowane landing pages z unique content
- Nie indeksuj wszystkiego – selekcja jest kluczowa
5. Continuous monitoring
- Faceted navigation SEO to proces, nie projekt
- Regularny przegląd GSC i crawl stats
- Dostosuj strategię na podstawie danych
Złota Zasada
Balans między user experience a technical SEO przez strategiczne stosowanie canonical, noindex i robots.txt to klucz do sukcesu. Przekształć potencjalne zagrożenie w przewagę konkurencyjną.
FAQ
Q: Kiedy stosować canonical vs noindex? A: Canonical gdy chcesz konsolidować sygnały z podobnych stron. Noindex gdy strona powinna być crawlowana (discovery), ale nie ma wartości SEO. Nigdy nie łącz obu.
Q: Jak konfigurować robots.txt dla filtrów? A: Blokuj parametry bez wartości: Disallow: /*?*sort=. Testuj w Google Robots Testing Tool przed wdrożeniem.
Q: Jak monitorować zmiany indeksacji? A: GSC → Indexing → Pages. Sprawdzaj tygodniowo przez pierwsze 2 miesiące czy filtry trafiają do właściwych kategorii (Excluded by noindex, Blocked by robots.txt).
Q: Czy faceted navigation zawsze wymaga canonical/noindex? A: Nie! Strategiczne kombinacje z high long-tail potential powinny być indeksowane. Klucz to selekcja – indeksuj wartościowe, blokuj resztę.
Q: Jak często audytować? A: Po wdrożeniu: tygodniowo przez 8 tygodni. Długoterminowo: pełny audyt co kwartał. Continuous: kluczowe metryki przez automated dashboards.
Zasoby i Narzędzia
Narzędzia SEO:
Dokumentacja Google:
Dalsze materiały:
- Optymalizacja produktów w sklepie pod SEO
- Optymalizacja stron kategorii
- Keyword Research w E-commerce
Powodzenia w optymalizacji! 🚀